
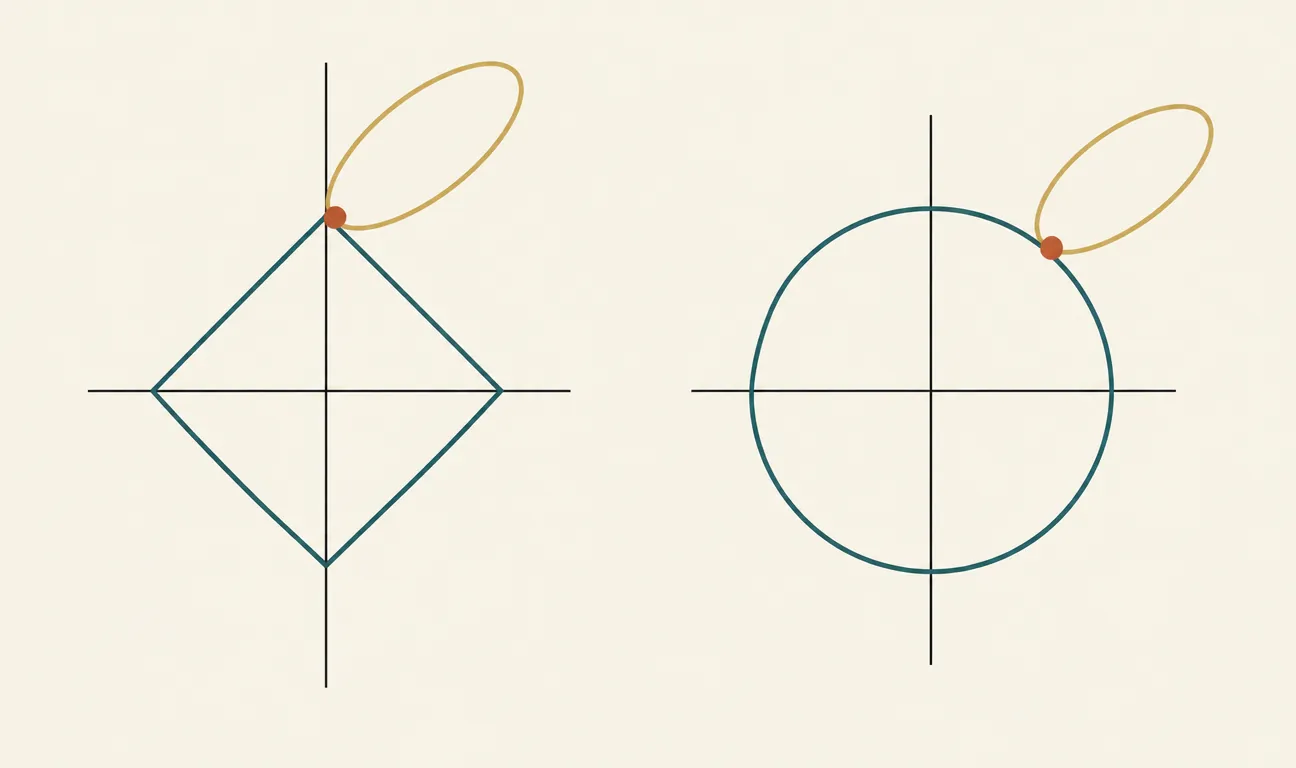
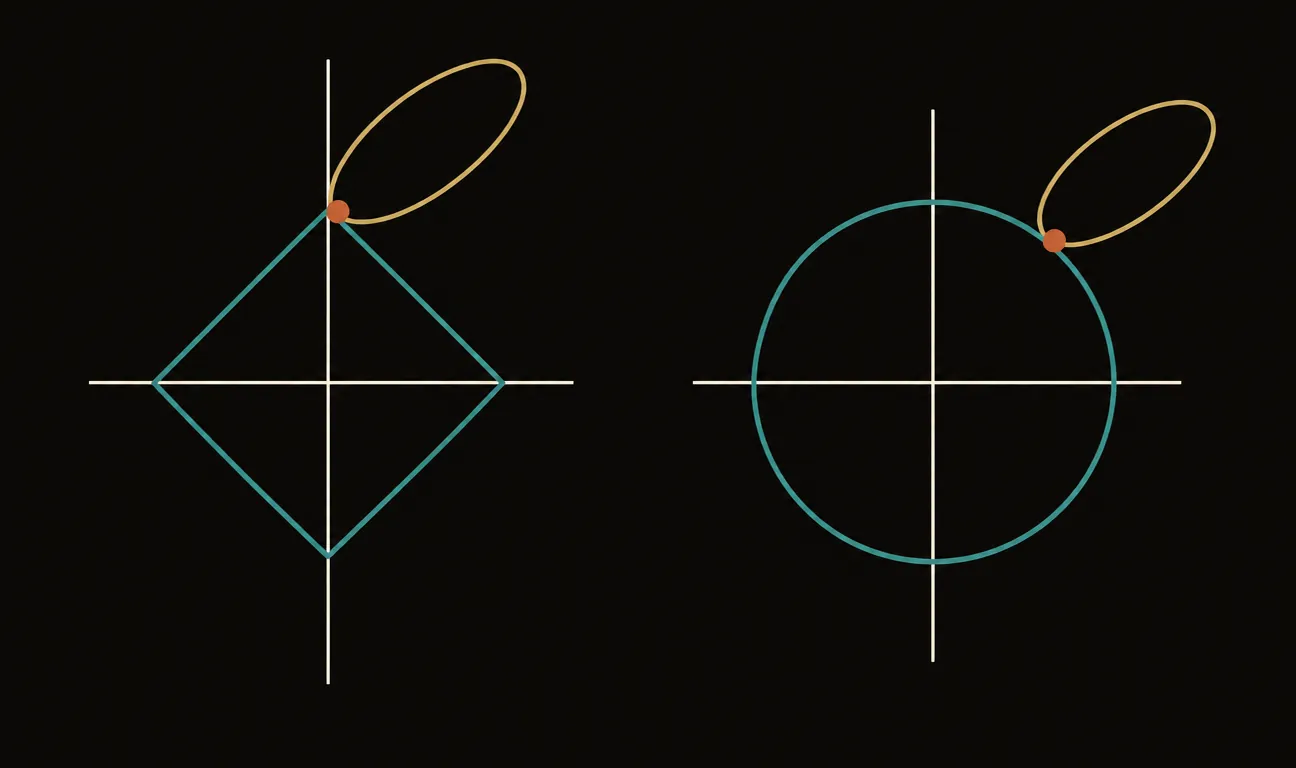
C’è una riga che compare in quasi ogni configurazione di addestramento, da una regressione logistica su un foglio Excel fino ai modelli linguistici da miliardi di parametri: weight_decay=0.01. Pochi si fermano a chiedersi cosa faccia. Quella riga applica una delle idee più vecchie e più resistenti del machine learning: se un modello tende a esagerare, mettigli i pesi a dieta. Si chiama regolarizzazione, esiste almeno dagli anni Settanta con il nome di ridge regression, e viene in due varianti principali — L1 e L2 — che si assomigliano nella formula e si comportano in modo sorprendentemente diverso. La differenza, come vedremo, si può letteralmente disegnare: è quella tra un rombo e un cerchio.
Overfitting e underfitting, il compromesso bias-varianza, train/validation/test e la cross-validation: nel libro, con i conti.
Leggi «Overfitting, bias-varianza e validazione» nel libro →
Il problema: pesi grandi, modello nervoso
Un modello di machine learning è, in fondo, un insieme di numeri chiamati pesi. Durante l’addestramento questi numeri vengono aggiustati per ridurre l’errore sui dati di esempio. Il guaio è che l’ottimizzazione, lasciata libera, non ha alcun senso della misura: se per azzerare l’errore su un punto anomalo serve un peso di valore 4.000, lei lo mette a 4.000 senza esitare.
Pesi molto grandi producono modelli nervosi: funzioni che oscillano violentemente per passare esattamente per ogni punto del training set, comprese le sue imperfezioni e il suo rumore. È l’overfitting nella sua forma più concreta. L’analogia utile è quella dello studente che prepara l’esame imparando a memoria le soluzioni degli esercizi svolti in classe, virgole comprese: sui quegli esercizi è perfetto, ma alla prima domanda leggermente diversa crolla. Un peso enorme è l’equivalente numerico di una nozione imparata a memoria: serve solo per quel caso specifico.
La cura: una penalità nella funzione di costo
La regolarizzazione interviene modificando l’obiettivo dell’addestramento. Invece di minimizzare solo l’errore sui dati, il modello minimizza errore + penalità sulla grandezza dei pesi. In formula: costo = errore + λ · (misura dei pesi), dove λ (lambda) è una manopola che decide quanto la dieta è severa.
Le due varianti differiscono per come misurano la grandezza dei pesi:
- L2 somma i quadrati dei pesi: penalità = w₁² + w₂² + … È il classico weight decay, o ridge.
- L1 somma i valori assoluti: penalità = |w₁| + |w₂| + … Nel mondo della regressione si chiama lasso.
Sembra un dettaglio contabile. Non lo è: cambia il carattere del modello che ne esce. L2 produce pesi tutti piccoli ma quasi mai esattamente zero. L1 produce pesi in gran parte esattamente zero: spegne intere feature, lasciando accese solo quelle che contano davvero.
L2 abbassa il volume di tutti gli strumenti dell’orchestra; L1 manda a casa i musicisti che non servono.
Il rombo e il cerchio
Il modo più illuminante di capire questa differenza è geometrico. Immaginate un modello con due soli pesi, w₁ e w₂, disegnati su un piano. Imporre una penalità equivale a dire ai pesi: potete muovervi solo dentro una regione di budget limitato intorno all’origine. La forma di quella regione dipende dalla penalità: con L2 (somma dei quadrati costante) il budget è un cerchio; con L1 (somma dei valori assoluti costante) è un rombo con i vertici sugli assi.
L’errore sui dati, dal canto suo, disegna sul piano una serie di curve di livello concentriche — come le isoipse di una mappa topografica — centrate sul punto che il modello sceglierebbe se fosse libero. La soluzione regolarizzata è il punto in cui la curva di livello più bassa possibile tocca il bordo della regione di budget.
Ed ecco il punto: una curva liscia che si avvicina a un cerchio lo tocca in un punto qualsiasi del bordo, dove tipicamente entrambi i pesi sono diversi da zero. La stessa curva che si avvicina a un rombo, invece, con alta probabilità lo tocca su un vertice — perché i vertici sporgono. E i vertici del rombo stanno sugli assi, cioè nei punti dove uno dei due pesi vale esattamente zero. La sparsità di L1 non è un trucco algoritmico: è la geometria degli spigoli.
Lo stesso errore, due vincoli diversi: il rombo di L1 viene toccato sul vertice, dove un peso è esattamente zero; il cerchio di L2 in un punto generico, dove i pesi sono piccoli ma tutti attivi.
Quando usare l’una, quando l’altra
La geometria si traduce in criteri pratici piuttosto netti. L1 quando volete selezione: avete molte feature e sospettate che solo una manciata conti — dati tabellari con centinaia di colonne, segnali genomici, feature costruite a mano. Il modello che ne esce è più interpretabile (le colonne spente si ignorano) e più economico da usare, perché le feature azzerate non serve nemmeno calcolarle.
L2 quando volete stabilità: è la scelta di default nel deep learning, dove nessun singolo peso di una rete ha un significato leggibile e spegnerne alcuni non renderebbe nulla più interpretabile. L2 ha anche vantaggi di ottimizzazione: è derivabile ovunque (L1 ha uno spigolo in zero che complica i gradienti) e gestisce meglio le feature correlate, distribuendo il peso tra loro invece di sceglierne una arbitrariamente come tende a fare L1.
Esiste anche la via di mezzo, chiamata elastic net: una combinazione pesata di L1 e L2 che eredita un po’ di sparsità dalla prima e un po’ di stabilità dalla seconda. Nelle librerie standard è a un parametro di distanza.
La manopola λ e i suoi eccessi
Resta da regolare la severità della dieta. Con λ = 0 la penalità sparisce e si torna al modello libero, overfitting incluso. Con λ enorme la penalità domina tutto: i pesi collassano verso zero e il modello diventa una banalità che predice sempre la media — dall’imparare a memoria si passa al non imparare niente. Il valore giusto sta in mezzo e non si indovina: si cerca con la validazione, tipicamente provando valori su scala logaritmica (0.001, 0.01, 0.1, 1) e misurando l’errore su dati mai visti durante l’addestramento.
Un’avvertenza pratica spesso trascurata: la penalità confronta i pesi tra loro, quindi ha senso solo se le feature sono su scale comparabili. Se una colonna è espressa in millimetri e un’altra in chilometri, i loro pesi vivranno su scale diversissime e la penalità colpirà alla cieca. Standardizzare le feature prima di regolarizzare non è un vezzo: è un prerequisito.
Perché vi riguarda
Se addestrate modelli, la regolarizzazione è probabilmente la singola difesa anti-overfitting con il miglior rapporto tra costo e beneficio: una riga di codice, nessun dato in più richiesto. Sapere cosa c’è dietro weight_decay vi permette di sceglierla e tararla invece di copiarla da un tutorial. E se i modelli li usate soltanto, la lezione vale lo stesso, perché è una lezione sulla conoscenza in generale: un sistema — o una persona — che spiega i dati vecchi in modo troppo perfetto, aggrappandosi a ogni dettaglio, di solito sta memorizzando rumore. Un po’ di disciplina forzata, la rinuncia a spiegare tutto, è spesso il prezzo per capire davvero qualcosa di nuovo. Il rombo e il cerchio sono solo il modo in cui la matematica ha imparato a dirlo.
I commenti sono riservati agli iscritti.
Accedi per commentare