
C’è un esperimento mentale che ogni corso di machine learning dovrebbe aprire così: prendi un modello abbastanza capiente, addestralo su mille esempi e poi valutalo sugli stessi mille esempi. Otterrai un punteggio eccellente, magari perfetto. E non avrai imparato assolutamente nulla, perché un modello con abbastanza memoria può semplicemente ricordarsi le risposte. È lo studente che ha visto in anticipo le domande dell’esame: il 30 e lode non misura la preparazione, misura la fuga di notizie.
Overfitting e underfitting, il compromesso bias-varianza, train/validation/test e la cross-validation: nel libro, con i conti.
Leggi «Overfitting, bias-varianza e validazione» nel libro →
Da questa osservazione banale discende quasi tutta la disciplina della valutazione: i dati usati per addestrare non possono essere gli stessi usati per giudicare. La soluzione più semplice — mettere da parte un pezzo di dati come test — funziona, ma ha un difetto subdolo. La cross-validation nasce per correggerlo.
Il problema dello split singolo
La ricetta classica dice: 80% dei dati per l’addestramento, 20% tenuto nel cassetto per la valutazione finale. Ragionevole. Ma quel 20% è uno dei tanti campioni possibili, e con dataset piccoli o medi la fortuna del sorteggio pesa: se nel test finiscono per caso gli esempi facili, il modello sembra migliore di quanto sia; se finiscono i casi strani, sembra peggiore. Rifai lo split con un seed diverso e il punteggio cambia — a volte di parecchio.
È come giudicare un ristorante da una sola cena: magari era la serata dello chef in forma, magari quella del congelatore rotto. Una recensione affidabile richiede più visite. La cross-validation è esattamente questo: più visite, organizzate in modo che nessun dato faccia mai il doppio gioco.
K-fold: l’esaminatore a rotazione
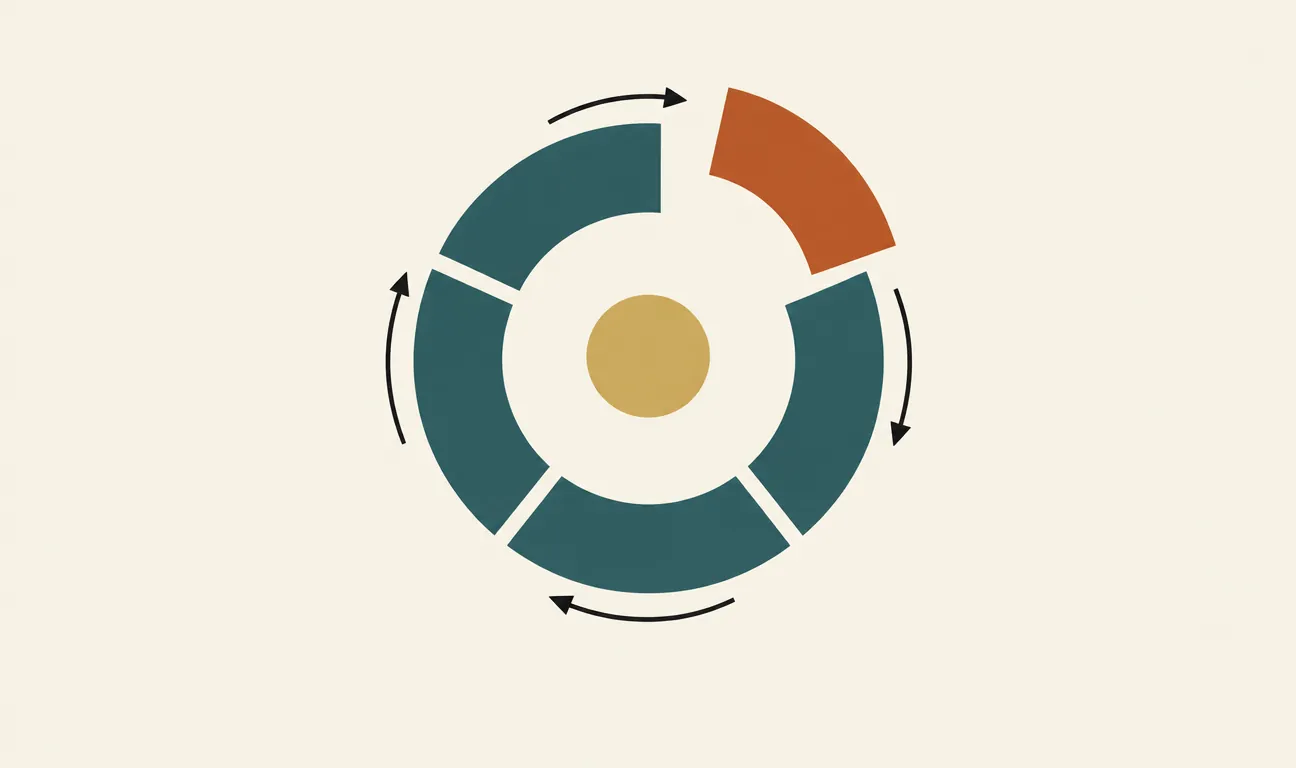
La variante più diffusa è la k-fold cross-validation. Dividi il dataset in k blocchi («fold») di uguale dimensione — cinque o dieci sono i valori tipici. Poi ripeti k volte lo stesso rito: un fold fa da test, gli altri k−1 da training. A ogni giro il fold di test cambia, a rotazione, finché ogni esempio del dataset è stato esattamente una volta dalla parte dell’esaminatore e k−1 volte dalla parte dello studente.
Alla fine hai k punteggi indipendenti tra loro quanto basta per fare due cose preziose: calcolarne la media, che è una stima della performance molto più stabile di quella di uno split singolo, e la deviazione standard, che ti dice quanto il modello è sensibile a quali dati vede. Un modello che oscilla tra 0,70 e 0,92 a seconda del fold è una bandiera rossa che lo split singolo non avrebbe mai sventolato.
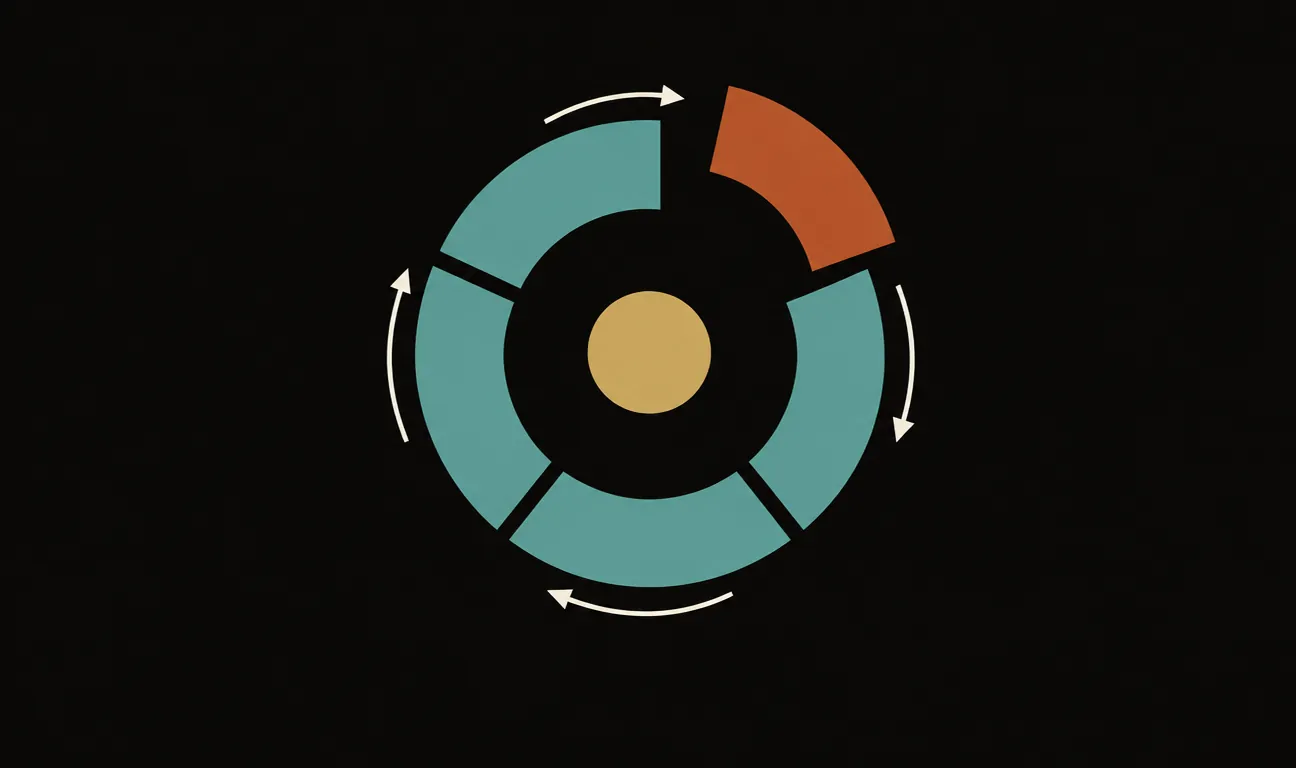
A ogni giro un fold diverso (terracotta) fa da test mentre gli altri quattro (teal) addestrano. Ogni esempio viene giudicato esattamente una volta.
Le varianti che contano
La k-fold liscia va bene nel caso medio, ma tre situazioni richiedono adattamenti — e ignorarle è il modo più rapido per barare senza accorgersene.
Classi sbilanciate → stratified k-fold. Se i positivi sono il 3% del dataset, un fold sorteggiato alla cieca può contenerne pochissimi o nessuno, e il punteggio su quel giro diventa rumore. La versione stratificata costruisce i fold mantenendo in ciascuno la stessa proporzione di classi del dataset intero.
Dati raggruppati → group k-fold. Se hai dieci radiografie per paziente, e le radiografie dello stesso paziente finiscono un po’ in training e un po’ in test, il modello può riconoscere il paziente invece della patologia. La regola: tutto ciò che appartiene allo stesso gruppo (paziente, utente, sensore) deve stare dallo stesso lato della barricata.
Serie temporali → split temporale. Con dati che evolvono nel tempo, la rotazione classica commette un peccato capitale: addestra sul futuro per predire il passato. Un modello di previsione vendite validato così vedrà i saldi di gennaio per «prevedere» dicembre. Si usa invece una finestra che avanza: si addestra fino a un certo mese, si testa sul successivo, e si scivola in avanti. Niente rotazione completa, solo avanti.
Esiste anche l’estremo della famiglia, il leave-one-out: k pari al numero di esempi, ogni giro testa su un singolo dato. Massimo sfruttamento del dataset, costo computazionale proporzionale alla sua dimensione, e una stima che paradossalmente può risultare più ballerina. Nella pratica si usa quasi solo con dataset minuscoli.
Il leak silenzioso: preprocessare prima di dividere
Qui casca la maggior parte dei principianti, e non solo loro. Se normalizzi le feature, selezioni le variabili o riempi i valori mancanti usando le statistiche di tutto il dataset, e solo dopo fai la cross-validation, hai già contaminato il test: la media e la varianza usate per normalizzare contengono informazione dei dati che poi userai per giudicare. È un travaso invisibile — data leakage — che gonfia i punteggi in modo sistematico.
La regola è una sola: qualunque cosa venga imparata dai dati — anche una banale media per la normalizzazione — va imparata solo dentro il fold di training di quel giro.
Gli strumenti moderni rendono facile rispettarla. In scikit-learn il costrutto Pipeline incapsula preprocessing e modello in un oggetto unico, e cross_val_score riesegue l’intera pipeline dentro ogni fold: la normalizzazione viene ricalcolata a ogni giro solo sui dati di training. Se stai facendo cross-validation su un modello ma il preprocessing è avvenuto fuori dalla pipeline, il punteggio che leggi è quasi certamente ottimista.
Un giudice sotto pressione smette di essere un giudice
C’è un ultimo trabocchetto, più sottile. La cross-validation serve spesso a scegliere gli iperparametri: provi cento configurazioni, tieni quella col punteggio medio più alto. Legittimo. Ma quel punteggio migliore, proprio perché selezionato tra cento, è in parte frutto della fortuna: hai ottimizzato contro il tuo sistema di valutazione, e il sistema ha smesso di essere neutrale. È la versione statistica della legge di Goodhart: quando una misura diventa un obiettivo, smette di essere una buona misura.
La soluzione pulita è la nested cross-validation: un anello interno sceglie gli iperparametri, un anello esterno — con dati mai visti dall’anello interno — misura la performance finale. Costa di più in calcolo, ma è l’unico modo per dichiarare un numero che non si è auto-lusingato. In alternativa, la vecchia disciplina del test set finale intoccabile: lo apri una volta sola, alla fine, come una busta sigillata.
Perché ti riguarda
La cross-validation non è un dettaglio da manuale: è la differenza tra sapere quanto vale un modello e crederci soltanto. Ogni claim del tipo «il nostro sistema ha il 97% di accuratezza» andrebbe accolto con tre domande: valutato su dati mai visti in addestramento? con quale variabilità tra i fold? e il preprocessing stava dentro o fuori dalla rotazione? Sono domande che non richiedono una laurea in statistica, e che smontano una quota sorprendente di risultati troppo belli.
Vale anche come postura mentale, oltre il machine learning: qualunque autovalutazione fatta sugli stessi dati che ti hanno formato l’opinione tende a darti ragione. Il test onesto è quello in cui l’esaminatore cambia a ogni giro — e nessuno, mai, ha visto le domande in anticipo.
I commenti sono riservati agli iscritti.
Accedi per commentare