
Un modello che rileva frodi sulle carte di credito non dice mai davvero «questa transazione è una frode». Dice qualcosa di più sfumato: «questa transazione ha un punteggio di 0,87». Poi qualcuno — un data scientist, un product manager, a volte una riga di codice scritta di fretta — decide che sopra 0,5 si blocca la carta e sotto si lascia passare. Quel numero, la soglia, non fa parte del modello: è una scelta di business. E qui nasce un problema serio: come si valuta un classificatore prima di aver deciso la soglia?
Matrice di confusione, precision e recall, curva ROC e AUC, e cosa fare con le classi sbilanciate: la trattazione è nel libro.
La risposta ha più di settant’anni e viene da un campo inaspettato: i radar della seconda guerra mondiale. Gli operatori dovevano distinguere gli aerei nemici dal rumore sullo schermo, e gli ingegneri inventarono uno strumento per misurare quanto bene ci riuscivano a ogni livello di sensibilità dell’apparecchio. Lo chiamarono Receiver Operating Characteristic: la curva ROC.
La soglia è un cursore, non una verità
Immagina il punteggio del modello come il volume di un metal detector in aeroporto. Se lo regoli al massimo, suona per ogni fibbia di cintura: becchi tutti gli oggetti pericolosi, ma fermi anche metà dei passeggeri innocenti. Se lo regoli al minimo, la fila scorre veloce, ma qualcosa di grave può passare. Nessuna delle due regolazioni è «giusta» in assoluto: dipende da quanto costa un falso allarme rispetto a un mancato allarme.
Ogni posizione del cursore produce due numeri:
- True Positive Rate (TPR), o sensibilità: dei casi davvero positivi, quanti ne ho catturati. È il «quante frodi ho bloccato sul totale delle frodi».
- False Positive Rate (FPR): dei casi negativi, quanti ne ho segnalati per errore. È il «quanti clienti onesti ho bloccato sul totale dei clienti onesti».
Abbassando la soglia, entrambi i numeri salgono: catturi più positivi veri, ma anche più falsi allarmi. Alzandola, entrambi scendono. La tensione tra i due è inevitabile — e la curva ROC è esattamente la fotografia di questa tensione.
Come si disegna la curva
Il procedimento è più semplice di quanto sembri. Prendi il tuo set di test con le etichette vere, ordini gli esempi per punteggio decrescente, e fai scorrere la soglia da «accetto tutto» a «rifiuto tutto». Per ogni posizione calcoli la coppia (FPR, TPR) e la disegni su un piano: FPR sull’asse orizzontale, TPR su quello verticale. Unendo i punti ottieni la curva.
Due estremi sono fissi per costruzione. Con la soglia altissima non segnali nulla: TPR = 0, FPR = 0, angolo in basso a sinistra. Con la soglia a zero segnali tutto: TPR = 1, FPR = 1, angolo in alto a destra. Quello che succede in mezzo è il carattere del modello.
C’è un riferimento fondamentale: la diagonale. Un classificatore che assegna punteggi a caso — lanciando una moneta, in sostanza — produce una curva che si adagia sulla retta TPR = FPR. Ha senso: se i punteggi non contengono informazione, catturare il 30% dei positivi ti costa sempre il 30% di falsi allarmi. Tutto ciò che sta sopra la diagonale è meglio del caso; tutto ciò che le sta sotto è peggio (e curiosamente basta invertire le predizioni per tornare sopra).
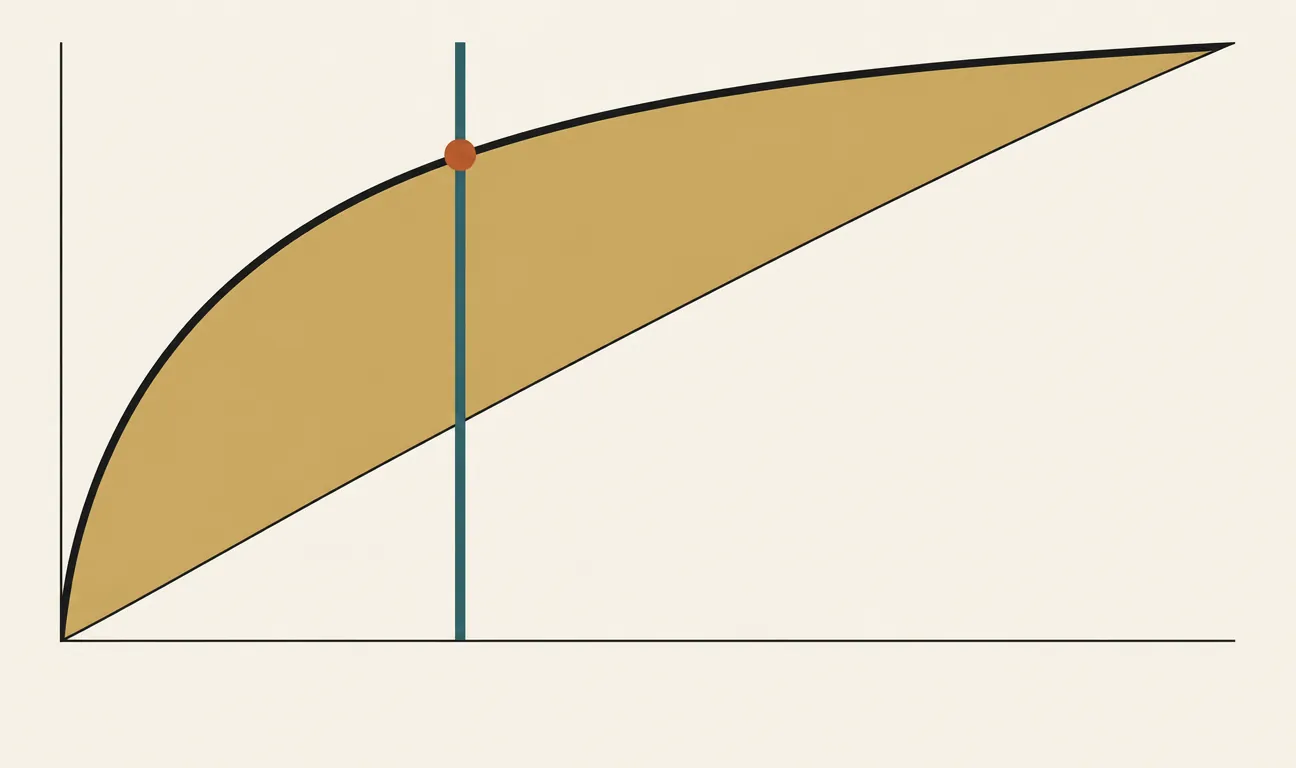
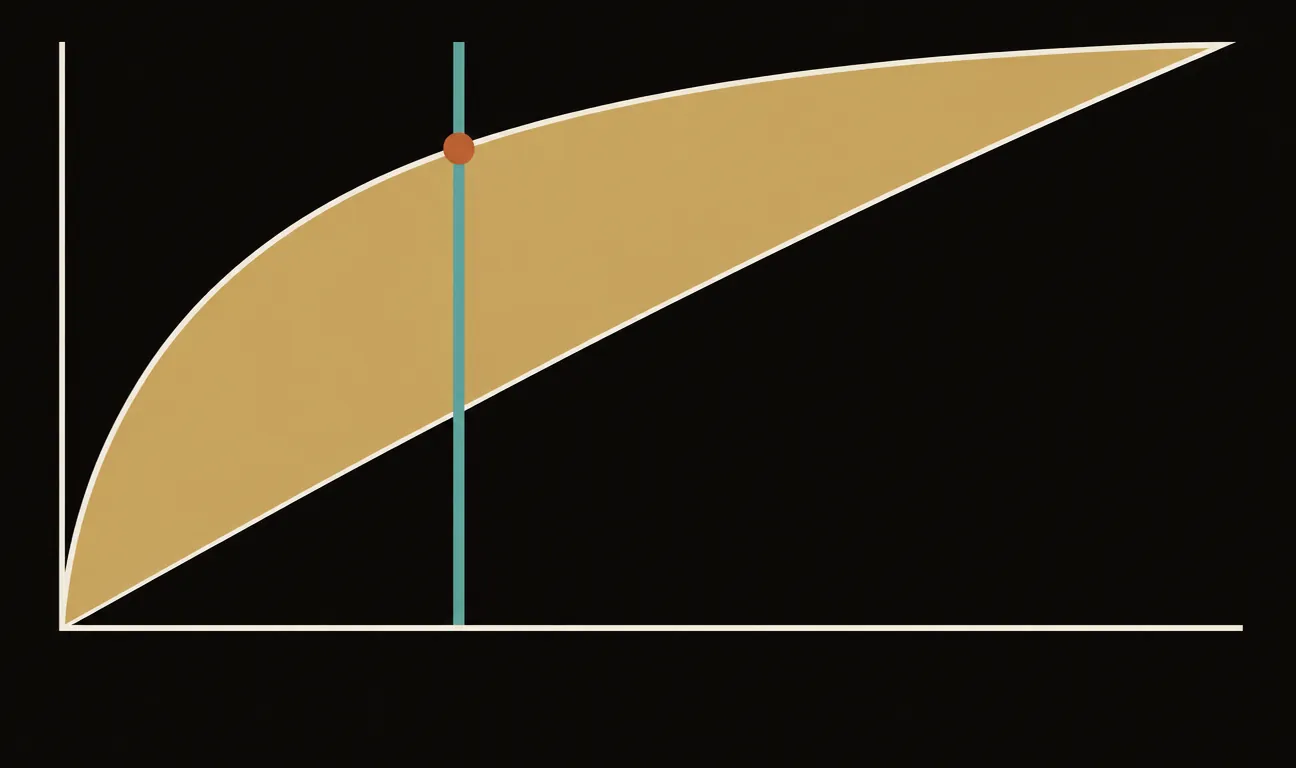
La curva ROC (terracotta) contro la diagonale del caso (tratteggiata). Ogni punto sulla curva è una possibile soglia; l’area ocra sotto la curva è l’AUC.
AUC: tutta la curva in un numero
Confrontare due curve a occhio è scomodo, soprattutto quando si incrociano. Per questo si usa l’AUC (Area Under the Curve): l’area compresa tra la curva e l’asse orizzontale. Vale 1,0 per un classificatore perfetto, 0,5 per il lancio di moneta, e i modelli reali stanno in mezzo.
L’AUC ha un’interpretazione elegante che vale la pena memorizzare: è la probabilità che, pescando a caso un esempio positivo e uno negativo, il modello assegni un punteggio più alto al positivo. Un AUC di 0,9 significa che nove volte su dieci il modello ordina correttamente la coppia. Non parla di soglie, non parla di percentuali di errore: parla di capacità di ordinamento. È come valutare un sommelier non chiedendogli «questo vino è buono?» ma mettendogli davanti due bicchieri e chiedendo quale sia il migliore.
L’AUC non misura quanto il modello sbaglia a una soglia: misura quanto bene sa mettere in fila i casi, dal più sospetto al più innocuo.
Dove ROC e AUC ingannano
Onestà intellettuale d’obbligo: ROC e AUC hanno punti ciechi noti, e ignorarli produce valutazioni fuorvianti.
Il primo riguarda le classi sbilanciate. Il FPR ha al denominatore il numero di negativi: se i negativi sono un milione e i positivi cento, anche diecimila falsi allarmi producono un FPR dell’1% — la curva ROC resta splendida mentre, in pratica, per ogni vera frode segnalata ne stai mostrando cento false all’analista. In questi scenari la curva precision-recall è spesso più informativa, perché la precision sente il peso dei falsi positivi in rapporto alle segnalazioni, non al mare dei negativi.
Il secondo: l’AUC media su tutte le soglie, incluse quelle che non userai mai. Se in produzione lavorerai sempre in zona «pochi falsi allarmi», ti interessa la parte sinistra della curva, e un modello con AUC complessiva più bassa potrebbe essere migliore proprio lì. Esistono varianti come l’AUC parziale, ma il punto è più semplice: guarda la curva, non solo il numero.
Il terzo: l’AUC non dice nulla sulla calibrazione. Un modello può ordinare perfettamente i casi e allo stesso tempo produrre punteggi che non c’entrano niente con le probabilità reali. Se ti serve dire al cliente «questa transazione ha il 30% di probabilità di essere fraudolenta», l’AUC da sola non basta.
Come scegliere la soglia, alla fine
La curva ROC rimanda la scelta della soglia, ma prima o poi va fatta. Il criterio corretto non è statistico: è economico. Assegna un costo al falso positivo (un cliente bloccato ingiustamente, una telefonata al call center) e uno al falso negativo (una frode passata), poi cerca sulla curva il punto che minimizza il costo totale atteso. Un’euristica frequente quando i costi sono simili è massimizzare la statistica J = TPR − FPR (indice di Youden), che geometricamente è il punto più lontano dalla diagonale.
In medicina si tende a privilegiare la sensibilità (meglio un esame di troppo che un tumore mancato); nell’antispam la specificità (meglio uno spam nella inbox che una mail importante nel cestino). Stesso strumento, scelte opposte: la curva le contiene entrambe.
Perché ti riguarda
Se lavori con modelli di classificazione — o se semplicemente devi valutare quello che ti presenta un fornitore — la curva ROC è il vaccino contro un errore comune: giudicare un modello da una singola accuracy calcolata a una soglia arbitraria. «Il nostro modello ha il 95% di accuratezza» è una frase che non dice quasi nulla; «ha AUC 0,93, e alla soglia che ci serve cattura l’80% delle frodi con lo 0,5% di falsi allarmi» è una frase su cui si può prendere una decisione.
La lezione più generale vale anche fuori dal machine learning: ogni sistema che segnala qualcosa — un antifurto, un test diagnostico, un filtro antispam, perfino un collega ansioso — vive sullo stesso compromesso tra allarmi mancati e allarmi falsi. La curva ROC è solo il modo onesto di guardarlo in faccia, tutto insieme, prima di decidere dove piazzare il cursore.
I commenti sono riservati agli iscritti.
Accedi per commentare