Hai davanti la tabella degli annunci immobiliari della tua città: metri quadri, quartiere, numero di bagni, classe energetica, prezzo. Vuoi costruire un modello che stimi il prezzo di una casa nuova, di quelle non ancora in tabella. Prima ancora di scrivere una riga di scikit-learn, devi rispondere a due domande che sembrano banali e non lo sono: quali colonne sono gli indizi, e quale colonna è la risposta? E poi: di che natura è ciascun indizio? Sbagliare qui significa costruire un modello che impara cose senza senso — e oggi vediamo perché.
Regressione lineare e logistica, dalla retta di best fit alla probabilità, sono derivate per intero nel libro.
Leggi «Apprendimento supervisionato: regressione e classificazione» nel libro →
Prerequisiti in una riga ciascuno. DataFrame: la tabella con colonne nominate di pandas, il foglio di calcolo dentro Python delle ultime tre lezioni. dtype: il tipo che pandas assegna a ogni colonna (numeri interi, decimali, testo…). Ambiente: Python 3.12 in un virtual environment con uv pip install pandas. Di scikit-learn oggi parliamo soltanto: il codice arriva tra qualche lezione.
Feature e label: indizi e risposta
Ti ricordi Akinator, il genio del web che indovina il personaggio a cui stai pensando? Fa domande — «è una persona reale?», «è vivo?», «è italiano?» — e da quegli indizi arriva alla risposta. Il machine learning supervisionato funziona esattamente così: le feature sono gli indizi (le risposte alle domande), la label è ciò che vogliamo indovinare (il personaggio). Nel nostro caso immobiliare: metri quadri, quartiere, bagni e classe energetica sono le feature; il prezzo è la label.
La convenzione che ritroverai ovunque, da scikit-learn ai paper: le feature si chiamano X (maiuscola, perché è una tabella intera) e la label si chiama y (minuscola, perché è una colonna sola). «Addestrare un modello» significa mostrargli tante righe complete di X e y — case di cui conosciamo già il prezzo — finché non impara la relazione tra indizi e risposta, per poi applicarla a case mai viste.
import pandas as pd

case = pd.DataFrame({
    "mq":        [65, 110, 48, 95, 120, 75],
    "bagni":     [1, 2, 1, 2, 3, 1],
    "quartiere": ["Centro", "Periferia", "Centro",
                  "Semicentro", "Semicentro", "Periferia"],
    "classe_energetica": ["C", "A", "F", "B", "A", "D"],
    "prezzo":    [210_000, 265_000, 155_000, 240_000, 335_000, 150_000],
})

# la separazione fondamentale del ML supervisionato
X = case.drop(columns=["prezzo"])   # le feature: gli indizi
y = case["prezzo"]                  # la label: la risposta

print(X.dtypes)
# mq                   int64
# bagni                int64
# quartiere              str   <- testo: qui inizia il bello
# classe_energetica      str
Un dettaglio da fissare subito: la label è tale solo rispetto a una domanda. Se domani volessi prevedere il quartiere a partire da metri quadri e prezzo, allora quartiere diventerebbe la mia y. Nessuna colonna nasce feature o label: lo decide il problema che vuoi risolvere.
Non tutti gli indizi sono fatti della stessa pasta
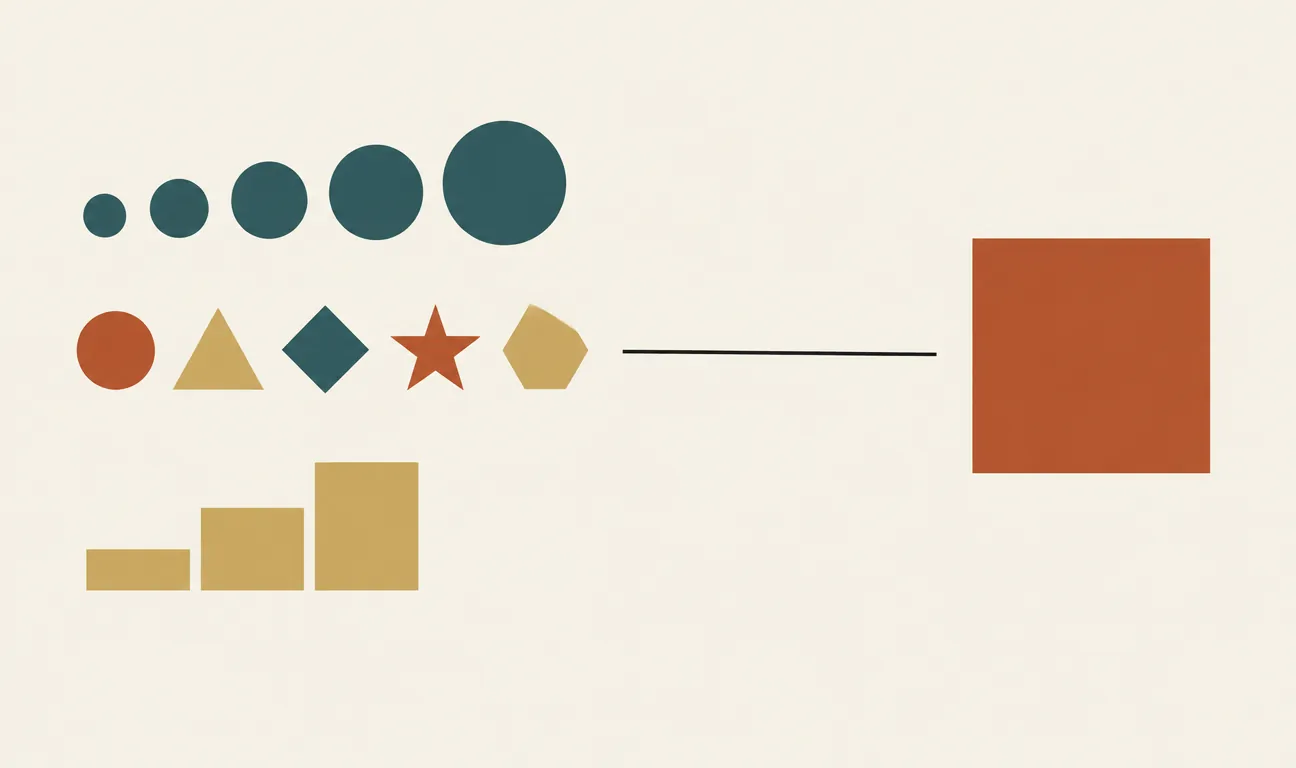
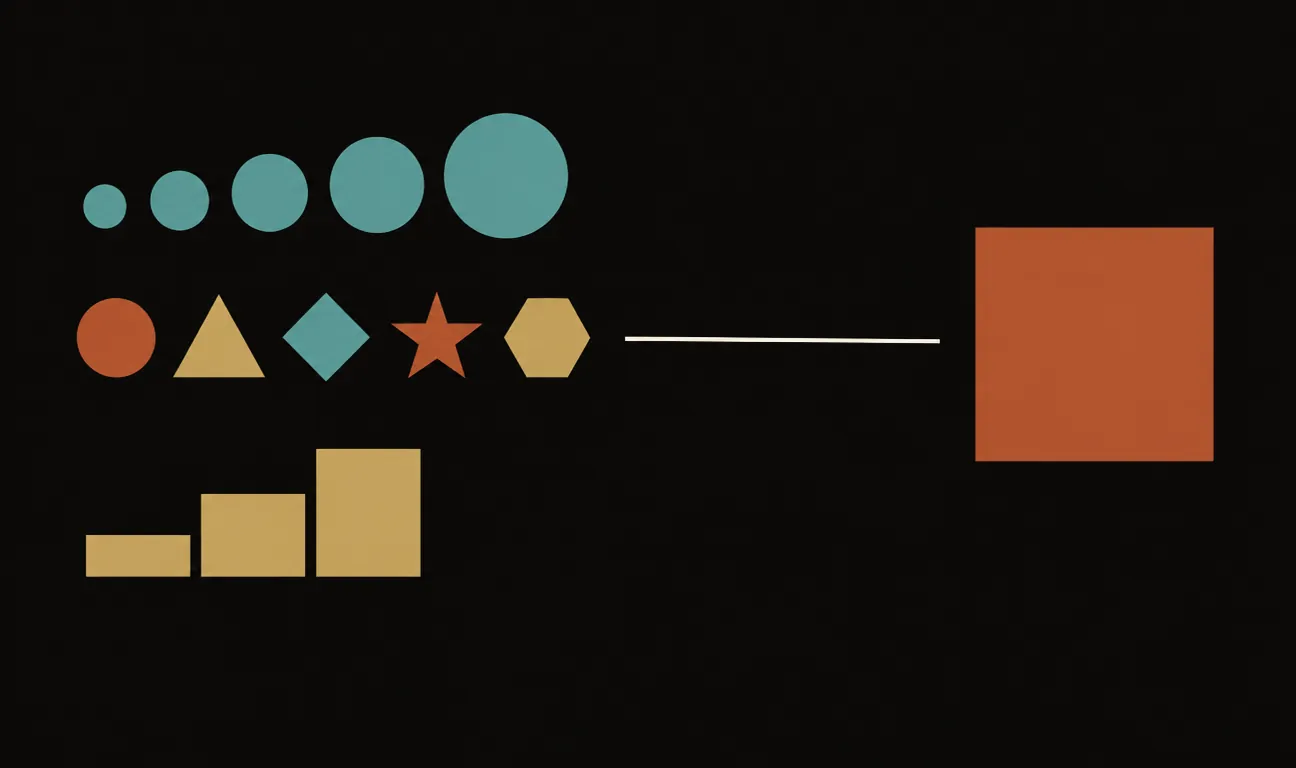
Guarda le quattro feature: mq è un numero su cui ha senso fare aritmetica; quartiere è un’etichetta senza ordine; classe_energetica è un’etichetta con un ordine (A è meglio di B, che è meglio di C…). Tre nature diverse, e ogni natura va trattata a modo suo. È come ordinare il guardaroba: le temperature di lavaggio sono numeri, i colori sono categorie pure, le taglie S-M-L-XL sono categorie ordinate. Nessuno stenderebbe i colori «in ordine crescente» — e un modello non dovrebbe farlo con i quartieri.
Le tre nature di una feature: sul numerico puoi fare aritmetica, il categorico è pura etichetta, l’ordinale sta nel mezzo — l’ordine esiste, ma la distanza tra i gradini no.
Vediamole una per una.
Numerico. Numeri veri, su cui somme, medie e distanze hanno senso: metri quadri, prezzo, temperatura. Dentro questa famiglia c’è una distinzione utile: continuo (può assumere qualsiasi valore in un intervallo: 87,3 mq) e discreto (solo valori isolati e contati: 2 bagni, mai 2,4). Per il modello cambia poco, per i tuoi grafici molto — un istogramma per il continuo, un grafico a barre per il discreto.
Categorico (nominale). Etichette senza alcun ordine: quartiere, colore, marca. La trappola classica è che spesso arrivano travestite da numeri: il CAP, il numero di maglia, il codice prodotto. Il CAP 20121 non è «il doppio» del CAP 10060 — è solo un nome scritto con le cifre. Se lo lasci come numero, il modello ci farà aritmetica sopra e imparerà relazioni inventate.
Ordinale. Etichette con un ordine ma senza distanze: classe energetica (A > B > C), taglie (S < M < L), titolo di studio, le stelle di un hotel. Sai che A batte B, ma non sai di quanto: il salto da G ad F non vale necessariamente quanto il salto da B ad A. È l’errore della scala del dolore in ospedale: da 1 a 10, ma nessuno crede che un dolore 8 sia «il doppio» di un dolore 4.
Un modello non vede colonne, vede numeri. Sei tu a dovergli dire quali numeri sono quantità, quali sono nomi e quali sono gradini di una scala.
Dirlo a pandas (e prepararsi a dirlo al modello)
Pandas ha un dtype apposta per le categorie, e per le ordinali puoi dichiarare l’ordine esplicitamente:
from pandas.api.types import CategoricalDtype

# quartiere: categorico puro, nessun ordine
case["quartiere"] = case["quartiere"].astype("category")

# classe energetica: ordinale, con l'ordine dichiarato da noi
scala_energetica = CategoricalDtype(
    categories=["G", "F", "E", "D", "C", "B", "A"],  # dal peggiore al migliore
    ordered=True,
)
case["classe_energetica"] = case["classe_energetica"].astype(scala_energetica)

# ora pandas SA che A batte D:
print(case["classe_energetica"] > "D")   # True dove la classe è C, B o A

# e possiamo separare le feature per tipo, come faremo nel preprocessing
numeriche  = case.select_dtypes(include="number").columns
categoriche = case.select_dtypes(include="category").columns
print(list(numeriche))    # ['mq', 'bagni', 'prezzo']
print(list(categoriche))  # ['quartiere', 'classe_energetica']
Questa dichiarazione non è pignoleria: è il contratto su cui si regge tutto il preprocessing che vedremo nelle prossime lezioni. Le feature numeriche andranno scalate, le categoriche pure andranno in one-hot encoding (una colonna binaria per categoria), le ordinali in un encoding che rispetti l’ordine. Tre tipi, tre strade — e la strada la sceglie il tipo, non l’algoritmo.
Una dose di onestà per chiudere il cerchio: non tutto merita un modello. Se la tua domanda è «qual è il prezzo medio al metro quadro per quartiere?», la risposta è un groupby, non il machine learning. Il ML serve quando vuoi prevedere la label per righe nuove, non quando vuoi riassumere le righe che hai già. Con sei case d’esempio, poi, nessun modello impara nulla di sensato: i giocattoli didattici servono a capire i concetti, i modelli veri vogliono centinaia o migliaia di righe.
Prova tu
Prendi un dominio che conosci bene — la tua palestra, la tua collezione di dischi, le partite della tua squadra — e progetta su carta un dataset per una previsione: scegli la label, elenca 5-6 feature e classifica ognuna come numerica (continua o discreta), categorica o ordinale. Poi costruisci il DataFrame in pandas con 8-10 righe inventate, assegna i dtype corretti (incluso un CategoricalDtype ordinato dove serve) e verifica con select_dtypes di saper separare le famiglie. Domanda bonus, la più formativa: c’è una feature che sembra numerica ma è un’etichetta travestita?
Per approfondire: la pagina «Categorical data» della documentazione pandas, e il capitolo 2 di Hands-On Machine Learning di Aurélien Géron (3ª edizione), dove un dataset immobiliare vero — quello californiano — viene sezionato feature per feature esattamente con questo metodo.
I commenti sono riservati agli iscritti.
Accedi per commentare