Hai due file: uno con l’anagrafica dei clienti, uno con gli ordini dell’ultimo mese. Il capo ti chiede una cosa banale — «quanto ha speso ogni cliente, città per città?» — e ti accorgi che la risposta non sta in nessuna delle due tabelle: sta nella loro unione. E come se non bastasse, tre clienti non hanno la città compilata e due ordini puntano a un cliente che nel file anagrafico non esiste. Benvenuto nei dati veri. Oggi impari le due abilità che, messe insieme, coprono metà del lavoro quotidiano di chi fa data science: unire tabelle e gestire i buchi.
Series e DataFrame, selezione e filtri, raggruppamenti e valori mancanti, e i grafici: nel libro.
Leggi «Pandas e Matplotlib: dati e visualizzazione» nel libro →
Prerequisiti in una riga ciascuno. DataFrame: la tabella con colonne nominate di pandas — se ti sei perso le due lezioni precedenti, ti basta pensarlo come un foglio di calcolo dentro Python. groupby: raggruppa le righe per il valore di una colonna e applica un calcolo a ogni gruppo; lo useremo nel finale. Ambiente: Python 3.12 nel tuo virtual environment, uv pip install pandas (o pip install pandas) e sei pronto.
Il problema: i dati vivono in tabelle separate
Non è un incidente, è una scelta di design: nei database ogni informazione vive in un posto solo. L’indirizzo del cliente sta nell’anagrafica, non ripetuto su ognuno dei suoi cinquanta ordini. È come la segreteria della tua vecchia scuola: un registro con i dati degli studenti, un registro con i voti. Nessuno ricopiava l’indirizzo di casa accanto a ogni voto di matematica — quando serviva il quadro completo, si incrociavano i registri usando il nome dello studente come aggancio.
Quell’aggancio in pandas si chiama chiave (key): una colonna presente in entrambe le tabelle che dice quali righe vanno accoppiate. Costruiamo le nostre due tabelle di lavoro:
import pandas as pd

# anagrafica: 4 clienti, uno senza città (None diventa NaN)
clienti = pd.DataFrame({
    "cliente_id": [1, 2, 3, 4],
    "nome":  ["Anna", "Bruno", "Carla", "Dario"],
    "citta": ["Torino", "Bari", None, "Milano"],
})

# ordini: 5 righe; il cliente 99 non esiste in anagrafica
ordini = pd.DataFrame({
    "ordine_id":  [101, 102, 103, 104, 105],
    "cliente_id": [1, 1, 2, 4, 99],
    "importo":    [35.0, 12.5, 89.9, 45.0, 20.0],
})

print(clienti)
print(ordini)
Nota i due difetti seminati apposta: Carla non ha la città, e l’ordine 105 appartiene al cliente fantasma 99. Sono lì perché nei dati veri ci sono sempre, e vedremo come ogni tipo di join li tratta diversamente.
merge: quattro modi di unire, un solo comando
Il comando è uno: pd.merge(). Il parametro che cambia tutto è how, che risponde alla domanda: cosa faccio con le righe che non trovano il partner? L’analogia che uso sempre è quella delle due liste di invitati a una festa — la tua e quella del tuo coinquilino:
- inner: entrano solo le persone presenti su entrambe le liste. Nessun imbucato, ma qualcuno resta fuori.
- left: entra tutta la tua lista; chi del coinquilino non è anche sulla tua resta fuori. Se un tuo invitato manca dalla sua lista, entra lo stesso ma con il campo «conosciuto dal coinquilino» vuoto.
- right: lo specchio — comanda la lista del coinquilino.
- outer: entrano tutti, da qualsiasi lista arrivino; i dati che mancano restano vuoti.
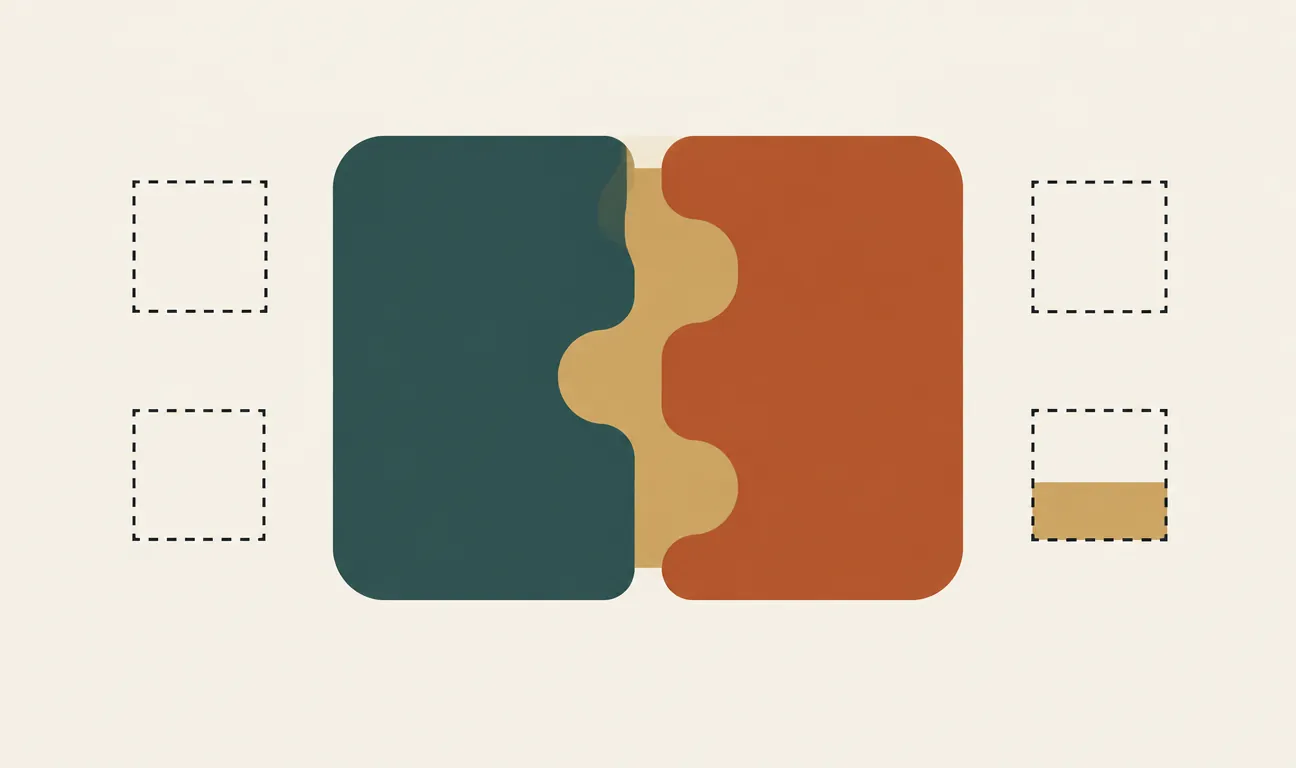
I quattro tipi di join: l’area colorata in ocra è ciò che sopravvive all’unione. Con inner restano solo le chiavi presenti in entrambe le tabelle; con outer resta tutto, e i valori mancanti diventano NaN.
In codice:
# inner (default): solo i clienti con almeno un ordine E presenti in anagrafica
inner = pd.merge(clienti, ordini, on="cliente_id", how="inner")
print(inner)          # 4 righe: sparisce Carla (0 ordini) e l'ordine del cliente 99

# left: tutti i clienti, anche chi non ha ordinato nulla
left = pd.merge(clienti, ordini, on="cliente_id", how="left")
print(left)           # Carla c'è, con ordine_id e importo NaN

# outer: proprio tutto, incluso l'ordine orfano del cliente 99
outer = pd.merge(clienti, ordini, on="cliente_id", how="outer")
print(outer)          # il cliente 99 compare con nome e citta NaN
Come scegliere? Chiediti chi è il protagonista della tua domanda. «Quanto ha speso ogni cliente?» → i clienti sono protagonisti, anche quelli a quota zero: left con i clienti a sinistra. «Analizza gli ordini validi» → conta solo l’incrocio: inner. E outer è la lente del detective: la usi per scoprire le incongruenze, come il nostro cliente 99, prima di decidere cosa farne.
Il tipo di join non è un dettaglio tecnico: è la risposta alla domanda «di chi mi fido quando le tabelle non combaciano?»
Due parenti stretti che è bene conoscere: df.join() è una scorciatoia di merge che aggancia sull’indice invece che su una colonna, comoda quando l’indice è già la chiave; pd.concat([df1, df2]) non incrocia niente — impila tabelle una sotto l’altra (o una accanto all’altra), come spillare insieme due risme di moduli identici. Se le colonne combaciano e vuoi solo «allungare» i dati, concat è lo strumento giusto e merge sarebbe sbagliato.
NaN: i buchi nei dati
Hai visto che i join producono valori mancanti (il NaN nella riga di Carla). Ma spesso i buchi ci sono già in partenza: il modulo compilato a metà, il sensore spento per un’ora, il campo facoltativo saltato. Pandas rappresenta il buco con NaN — Not a Number — e ha una proprietà infida: è contagioso. Qualsiasi operazione aritmetica che tocca un NaN restituisce NaN, come una firma mancante che blocca l’intera pratica.
Primo passo, sempre: contare i buchi.
# quanti NaN per colonna? isna() marca i buchi, sum() li conta
print(outer.isna().sum())

# le righe incriminate, per guardarle in faccia
print(outer[outer.isna().any(axis=1)])
Poi hai due famiglie di rimedi. Buttare: dropna() elimina le righe con almeno un buco (o le colonne, con axis=1). Drastico ma onesto — va bene quando le righe bucate sono poche e casuali. Riempire: fillna() mette un valore al posto del buco. Qui serve testa, perché il valore lo scegli tu:
pulito = outer.copy()

# buco testuale → etichetta esplicita: non nasconde, dichiara
pulito["citta"] = pulito["citta"].fillna("Sconosciuta")

# buco numerico → 0 SOLO se ha senso: "nessun ordine" = importo zero
pulito["importo"] = pulito["importo"].fillna(0)

# per una misura (età, prezzo di mercato) meglio la mediana:
# resiste agli outlier più della media
# pulito["eta"] = pulito["eta"].fillna(pulito["eta"].median())

print(pulito)
Attenzione all’onestà intellettuale: riempire un buco è inventare un dato. A volte è l’invenzione giusta (l’importo di un ordine mai fatto è davvero zero), a volte è una bugia statistica (dare a Carla la città «più frequente» può distorcere ogni analisi geografica). Regola pratica: prima chiediti perché il dato manca. Se manca in modo sistematico — per esempio se a non dichiarare la città sono soprattutto i clienti online — nessun fillna te lo dirà, e cancellare quelle righe distorcerebbe il campione. Nel dubbio, l’etichetta esplicita «Sconosciuta» è la scelta più trasparente: il buco resta visibile invece di travestirsi da dato.
Il gran finale: la domanda del capo
Ora hai tutti i pezzi. Unire, pulire, raggruppare:
# 1. unisco: comandano i clienti (left), l'ordine orfano resta fuori
tabella = pd.merge(clienti, ordini, on="cliente_id", how="left")

# 2. pulisco: chi non ha ordinato ha speso 0, città mancante dichiarata
tabella["importo"] = tabella["importo"].fillna(0)
tabella["citta"] = tabella["citta"].fillna("Sconosciuta")

# 3. raggruppo: spesa totale per città
risposta = tabella.groupby("citta")["importo"].sum().sort_values(ascending=False)
print(risposta)
# Bari            89.9
# Torino          47.5
# Milano          45.0
# Sconosciuta      0.0
Tre righe di sostanza. Ma il valore non è nella brevità: è nelle decisioni che ogni riga incorpora — quale join, quale riempimento, quale raggruppamento. Il codice è facile; le scelte sono il mestiere.
Prova tu
Costruisci un DataFrame studenti (colonne: studente_id, nome, classe) con 5 studenti, e un DataFrame voti (colonne: studente_id, materia, voto) con 8 voti — ma lascia uno studente senza voti e inserisci un voto con uno studente_id inesistente. Poi: (1) trova con un outer merge le incongruenze; (2) calcola la media voti per classe con un left merge, decidendo tu — e scrivendolo in un commento — se lo studente senza voti debba contare come 0 o essere escluso. Le due scelte danno medie diverse: qual è quella onesta?
Per approfondire: la guida ufficiale «Merge, join, concatenate and compare» nella documentazione di pandas, e il capitolo 8 di Python for Data Analysis (3ª edizione) di Wes McKinney — il creatore di pandas — leggibile gratuitamente su wesmckinney.com/book.
I commenti sono riservati agli iscritti.
Accedi per commentare