Hai caricato il tuo primo DataFrame, hai fatto head(), hai ammirato la tabella… e poi? Arriva la domanda vera — «qual è l’incasso medio per prodotto?», «quali clienti hanno speso più di 100 euro a giugno?» — e ti accorgi che guardare la tabella non basta: devi interrogarla. La tentazione è tornare al vecchio amico ciclo for con un dizionario di accumulatori. Resisti: oggi impari i tre attrezzi che trasformano ogni domanda in una riga di Pandas — la selezione con loc e iloc, i filtri booleani e il re di tutti, groupby.
Series e DataFrame, selezione e filtri, raggruppamenti e valori mancanti, e i grafici: nel libro.
Leggi «Pandas e Matplotlib: dati e visualizzazione» nel libro →
Prerequisiti in una riga: se non ricordi cos’è un DataFrame, ti basta sapere che è una tabella con etichette sulle righe (l’indice) e nomi sulle colonne, dove ogni colonna è una Series — ne abbiamo parlato nell’articolo precedente. Ambiente solito: Python 3.12 in un virtualenv (python -m venv .venv oppure uv venv), pip install pandas, VS Code o PyCharm.
Il dataset di oggi
Lavoriamo su un piccolo registro vendite: abbastanza piccolo da poterlo verificare a occhio (fallo sempre, quando impari!), abbastanza vario da rendere interessanti le domande. Copia, incolla, esegui.
# vendite_setup.py — Python 3.12, richiede: pip install pandas
import pandas as pd

vendite = pd.DataFrame({
    "prodotto":  ["tastiera", "mouse", "monitor", "tastiera", "mouse",
                  "monitor", "webcam", "tastiera", "webcam", "mouse"],
    "citta":     ["Milano", "Milano", "Roma", "Roma", "Napoli",
                  "Milano", "Roma", "Napoli", "Milano", "Roma"],
    "quantita":  [3, 5, 2, 1, 4, 1, 2, 2, 3, 6],
    "prezzo":    [49.90, 19.90, 189.00, 49.90, 19.90,
                  189.00, 39.90, 49.90, 39.90, 19.90],
})
vendite["incasso"] = vendite["quantita"] * vendite["prezzo"]

print(vendite)
loc e iloc: chiamare per nome o per numero civico
Per estrarre pezzi di tabella hai due citofoni. loc chiama per nome: etichette di riga e nomi di colonna. iloc chiama per numero civico: posizioni intere, come nelle liste Python. Confonderli è l’errore più comune dei primi mesi, quindi fissalo subito: loc = label, iloc = intero.
# Riga con etichetta 3 (qui l'indice è numerico, ma è un'ETICHETTA)
print(vendite.loc[3])

# Righe 0-2, solo due colonne: nomi espliciti
print(vendite.loc[0:2, ["prodotto", "incasso"]])

# Le ultime due righe, prime tre colonne: pure posizioni
print(vendite.iloc[-2:, 0:3])

# Attenzione alla differenza sugli intervalli:
# loc[0:2]  include ENTRAMBI gli estremi (3 righe: sono etichette)
# iloc[0:2] esclude il secondo, come le liste (2 righe: sono posizioni)
Filtri booleani: il buttafuori con la lista
Il filtro booleano funziona come un buttafuori all’ingresso di un locale: tu gli dai la regola («entrano solo gli incassi sopra 100 euro»), lui scorre la fila e per ognuno risponde solo vero o falso. Tecnicamente: una condizione su una colonna produce una Series di True/False, e passarla al DataFrame tiene solo le righe col True.
# La maschera: una Series di True/False, una risposta per riga
maschera = vendite["incasso"] > 100
print(maschera.head(3))

# Passala al DataFrame: restano solo le righe True
print(vendite[maschera])

# In pratica si scrive tutto in una riga:
print(vendite[vendite["incasso"] > 100])

# Condizioni multiple: & (e), | (o), ~ (non) — parentesi OBBLIGATORIE
print(vendite[(vendite["citta"] == "Milano") & (vendite["quantita"] >= 3)])

# Appartenenza a una lista di valori: isin
print(vendite[vendite["prodotto"].isin(["mouse", "webcam"])])
Due trappole da segnare sul taccuino: si usa & e |, non and e or (che con le Series sollevano un errore); e ogni condizione va tra parentesi, perché & ha precedenza più alta del confronto. Il novanta per cento degli errori di filtro dei principianti è una di queste due cose.
groupby: split, apply, combine
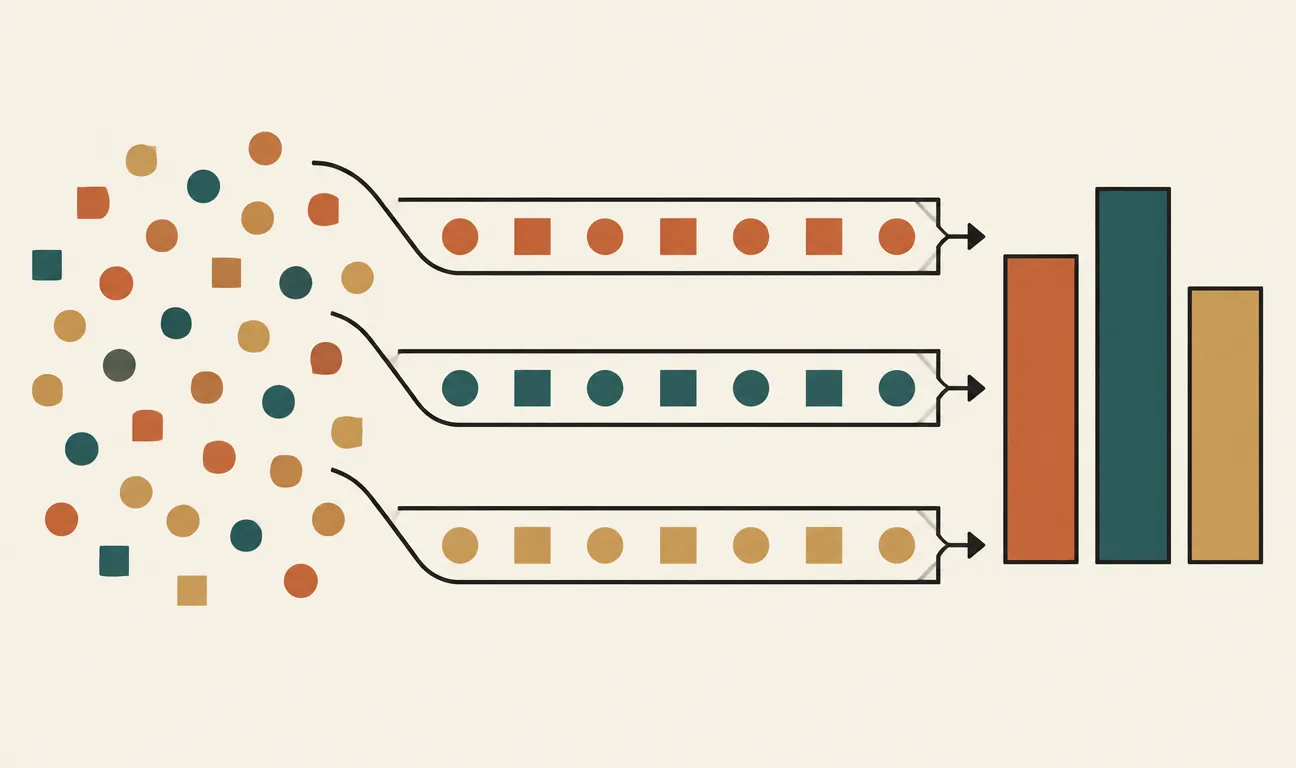
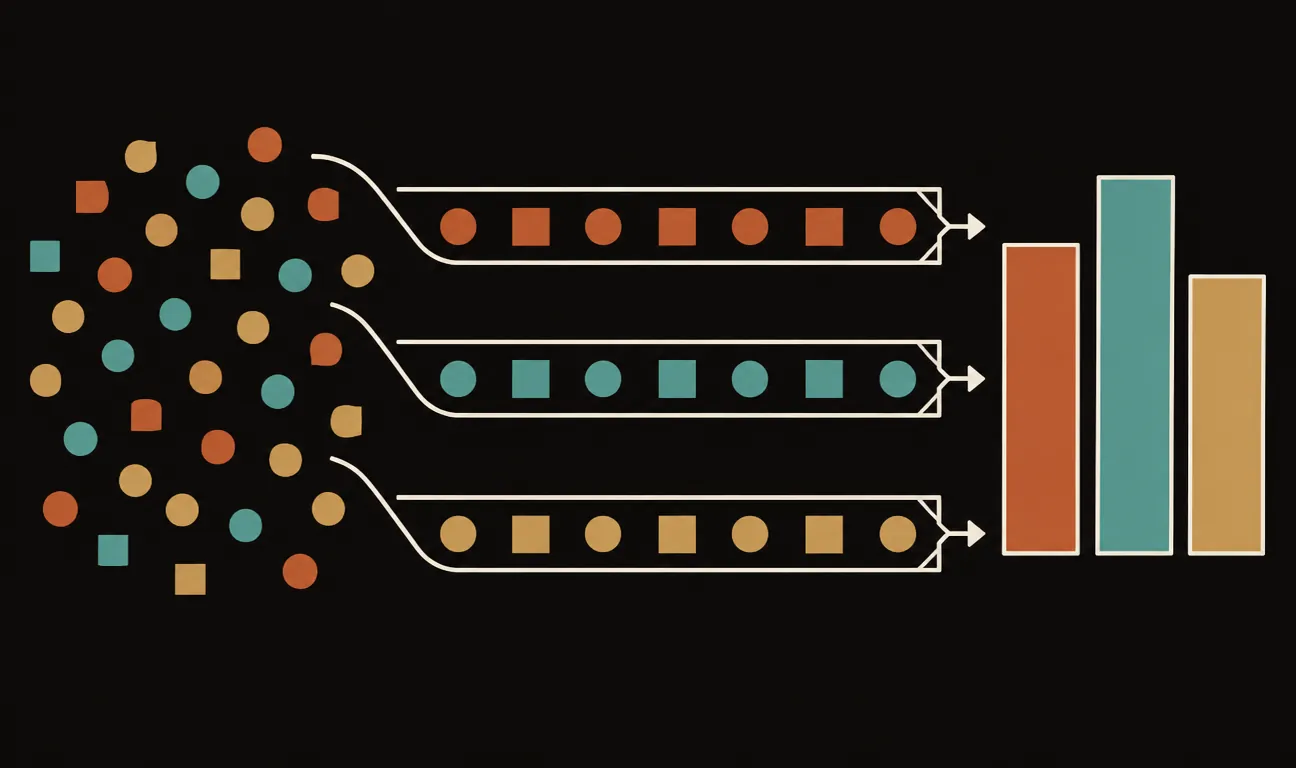
Ora la domanda vera: «quanto incassa in totale ogni prodotto?» Il pattern che la risolve si chiama split-apply-combine, e lo conosci già dalla vita quotidiana: è la raccolta differenziata degli scontrini. Hai una scatola di scontrini mescolati (la tabella intera); li dividi in mucchietti per negozio (split); su ogni mucchietto fai lo stesso calcolo, ad esempio la somma (apply); poi riporti i totali su un unico foglio riassuntivo, un negozio per riga (combine). groupby fa esattamente questo, in una riga.
# Split per prodotto, apply della somma sull'incasso, combine nel risultato
print(vendite.groupby("prodotto")["incasso"].sum())
# prodotto
# monitor     567.00
# mouse       298.50
# tastiera    299.40
# webcam      199.50

# Cambia la domanda, cambia solo l'aggregazione:
print(vendite.groupby("citta")["incasso"].mean())    # incasso medio per città
print(vendite.groupby("prodotto")["quantita"].max()) # vendita più grossa

# Raggruppare per PIÙ colonne: un livello per ogni chiave
print(vendite.groupby(["citta", "prodotto"])["incasso"].sum())
Split-apply-combine: la tabella viene divisa in gruppi (un colore per prodotto), su ogni gruppo si applica la stessa aggregazione, e i risultati si ricombinano in una tabella con una riga per gruppo.
Ogni volta che stai per scrivere un ciclo con un dizionario di accumulatori, fermati e chiediti: non è per caso un groupby? Nove volte su dieci lo è.
agg: più risposte in un colpo solo
Spesso di ogni gruppo vuoi più di un numero: totale, media, quante vendite. Il metodo agg ti fa dichiarare tutte le aggregazioni insieme, con nomi di colonna puliti in uscita.
# Named aggregation: nome_colonna_risultato=("colonna_origine", "funzione")
riassunto = vendite.groupby("prodotto").agg(
    incasso_totale=("incasso", "sum"),
    incasso_medio=("incasso", "mean"),
    n_vendite=("prodotto", "count"),
    pezzi_totali=("quantita", "sum"),
)
print(riassunto)
#           incasso_totale  incasso_medio  n_vendite  pezzi_totali
# prodotto
# monitor           567.00         283.50          2             3
# mouse             298.50          99.50          3            15
# tastiera          299.40          99.80          3             6
# webcam            199.50          99.75          2             5

# Ordina il risultato e hai la classifica pronta:
print(riassunto.sort_values("incasso_totale", ascending=False))
Nota che il risultato è a sua volta un DataFrame: puoi filtrarlo, ordinarlo, raggrupparlo ancora. È il momento in cui Pandas «clicca»: ogni operazione restituisce una struttura su cui puoi rifare tutto da capo, e le analisi diventano catene di trasformazioni leggibili dall’alto verso il basso.
Quando questi attrezzi non bastano (e quando sono troppi)
Onestà di fine lezione. Primo: se ti serve una trasformazione davvero contorta per gruppo, groupby(...).apply(funzione_tua) esiste ma è lento e spesso illeggibile — prima di usarlo, controlla se una combinazione di agg, transform o una colonna calcolata risolve. Secondo: su tabelle enormi (decine di milioni di righe) i groupby di Pandas mangiano RAM; Polars o DuckDB fanno lo stesso lavoro in una frazione del tempo. Terzo, in direzione opposta: se hai venti righe di dati e devi sommarle una volta sola, un ciclo for esplicito non è un peccato — è codice che chiunque legge. Gli attrezzi si scelgono in base al lavoro, non alla moda.
Prova tu
Esercizio concreto sul DataFrame vendite di questo articolo, senza scrivere nemmeno un ciclo: 1) trova tutte le vendite di Roma con incasso superiore a 50 euro; 2) calcola per ogni città l’incasso totale e il numero di vendite con una sola chiamata ad agg; 3) la domanda finale, che combina tutto: qual è il prodotto più redditizio per ogni città? (Suggerimento: raggruppa per due colonne, somma, poi guarda sort_values e ragiona su come tenere la prima riga di ogni città — groupby(...).head(1) dopo l’ordinamento è una strada elegante.) Se la terza ti riesce, i groupby non avranno più segreti quotidiani.
Per approfondire: la pagina «Group by: split-apply-combine» della guida ufficiale su pandas.pydata.org è sorprendentemente leggibile e copre casi che qui non ho toccato, come transform e filter sui gruppi. Il nome del pattern viene dal paper «The Split-Apply-Combine Strategy for Data Analysis» di Hadley Wickham (Journal of Statistical Software, 2011): sono una trentina di pagine piacevoli che ti fanno riconoscere questo schema ovunque, da SQL a Excel alle pipeline di ML.
I commenti sono riservati agli iscritti.
Accedi per commentare