
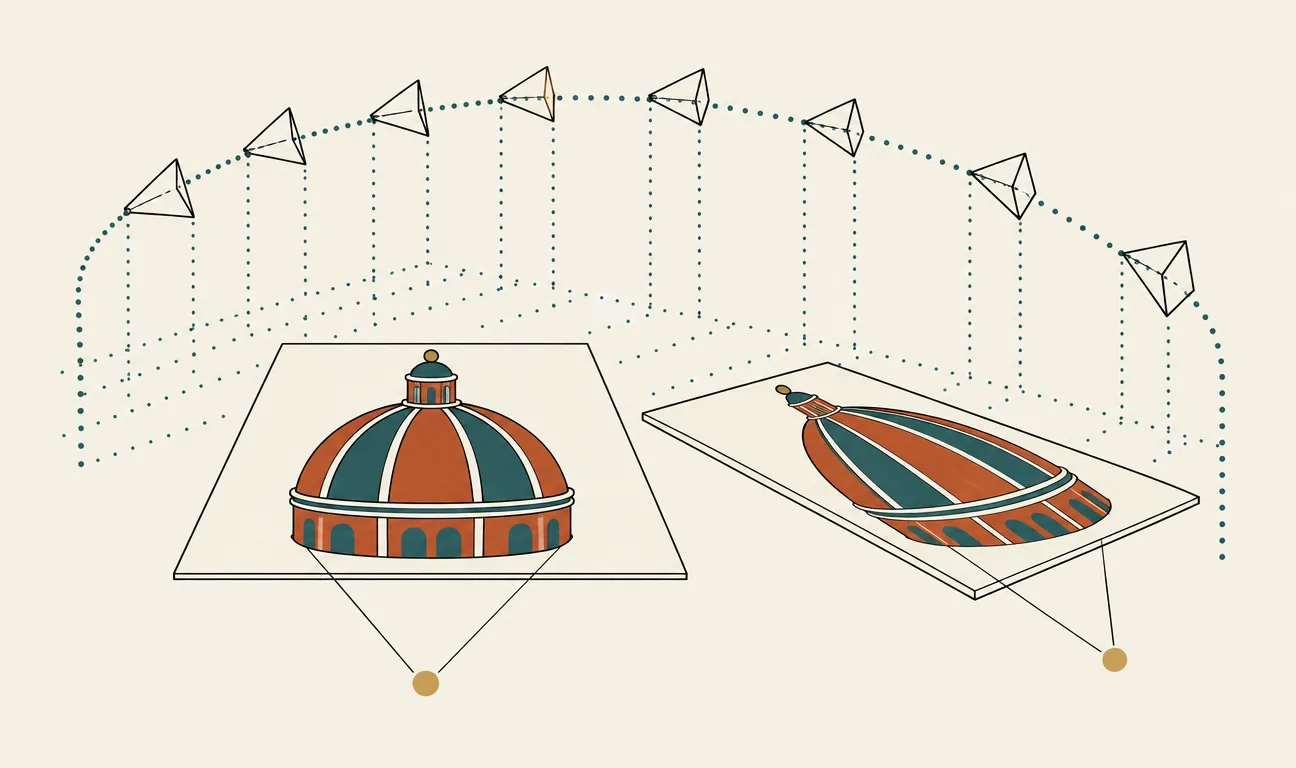
Nella chiesa di Sant’Ignazio, a Roma, c’è una cupola che non esiste. Andrea Pozzo la dipinse nel 1685 su una tela piatta, e dal disco di marmo segnato sul pavimento l’illusione è perfetta. Basta spostarsi di qualche passo lungo la navata perché l’architettura si pieghi e si allunghi, e si capisca che dietro non c’è nessuno spazio. Era una prospettiva costruita per un punto di vista solo.
I generatori video di oggi hanno un problema simile. Producono fotogrammi fotorealistici, ma se da quei fotogrammi si prova a ricostruire la scena, la geometria deriva e la camera non segue il percorso che le era stato chiesto. GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation, depositato su arXiv il 21 settembre 2026 (2609.24981) e in questi giorni fra i paper in tendenza su Papers with Code, attribuisce il difetto a un posto preciso: non al generatore, ma allo spazio in cui il generatore lavora. Lo firmano Jiahao Lu e Minghao Yin (primi autori a pari merito), Wenbo Hu, Hengyu Liu, Wang Zhao, Sai-Kit Yeung, Ying Shan e Yuan Liu, fra Hong Kong University of Science and Technology, ARC Lab di Tencent, University of Hong Kong e University of Texas at Austin.
Un problema di rappresentazione
Quasi tutti i generatori di immagini e video moderni non lavorano sui pixel ma su una versione compressa, lo spazio latente di un autoencoder. Lì il modello di diffusione, o di flow matching, trasforma rumore in un codice che il decoder riporta a immagine. La scelta di quel codice decide che cosa il generatore trova già pronto e che cosa deve dedurre da solo.
Perché si genera in uno spazio compresso invece che sui pixel, e che ruolo ha l’autoencoder in questo schema: è il cuore del capitolo su Stable Diffusion.
Un VAE sui pixel, come quello di Stable Diffusion, conserva l’aspetto: colori, texture, dettagli. Gli autoencoder «di rappresentazione», come RAEv2, costruiti su encoder semantici tipo DINO, organizzano il significato. Né l’uno né l’altro, osservano gli autori, rende leggibili in modo nativo la profondità, la posizione della camera e le corrispondenze fra viste diverse. Il rimedio abituale è aggiungere la geometria dopo, come controllo della camera, come uscita in più o come ricompensa in un post-addestramento. È la cupola di Pozzo: si decora l’aspetto e si spera che lo spazio regga.
Eppure esiste già una famiglia di modelli che quello spazio lo legge benissimo: i modelli fondazionali di geometria, che da poche foto della stessa scena ricostruiscono profondità, camere e mappe di punti in un sistema di riferimento comune. «Quello che la percezione sa leggere, la generazione fatica ancora a scriverlo», scrivono gli autori. La proposta è rovesciare il rapporto: far generare direttamente nello spazio delle feature di uno di questi modelli, Depth Anything 3 (DA3).
Perché non basta prendere le feature così come sono
L’idea non è nuova, e il paper è onesto nel dirlo: GLD genera in cascata alcuni livelli di feature di DA3 o VGGT, un altro lavoro i quattro livelli di VGGT insieme. Ma usare le feature grezze ha due difetti, che gli autori misurano su DA3.
Il primo è che la geometria non sta in un livello solo. La testa di DA3 che produce profondità e raggi legge una gerarchia di quattro livelli, ciascuno con un compito: il più superficiale conserva il dettaglio fine e le corrispondenze fra viste, quelli più profondi forniscono alla testa informazioni complementari. Generarli tutti vuol dire gestire più stati generativi accoppiati; sceglierne uno vuol dire buttare via informazione che la testa si aspetta.
Il secondo è che le feature sono pessime da modellare. Ogni livello ha 3.072 canali, ma la dimensione effettiva è di circa 11: quasi tutti i canali sono pressoché inattivi e l’informazione si concentra lungo poche direzioni, a scale diversissime. Il numero di condizionamento va da $10^8$ a $10^{16}$. La geometria c’è, conclude il paper, ma è parametrizzata male per chi deve generarla.
Il codec: comprimere senza toccare la testa
GAE, geometry-native autoencoder, mette un collo di bottiglia fra l’encoder di DA3 e la sua testa geometrica, entrambi congelati. I quattro livelli vengono normalizzati, concatenati lungo i canali e compressi in un unico latente che mantiene la griglia spaziale di DA3 ma riduce i canali a 64 o 128. Il decoder ricostruisce l’intera gerarchia, e da lì la testa originale di DA3 legge profondità, raggi della camera e mappe di punti. Una testa separata, addestrata apposta, legge dallo stesso latente l’immagine RGB.
Il dettaglio che conta è che la testa geometrica resta congelata. Se la si lasciasse imparare, potrebbe adattarsi all’informazione persa nella compressione e mascherarla; così invece il latente deve contenere davvero quello che il modello originale sa leggere. Aspetto e geometria diventano due letture dello stesso stato.
La ricostruzione dice che cosa il latente deve contenere, non come debba essere organizzato. E un latente che ricostruisce bene può comunque essere difficile da generare. Gli autori aggiungono quindi due obiettivi di forma, ciascuno con un modello-maestro congelato che viene poi scartato. Il primo allinea ogni token del latente alla feature di C-RADIO nella stessa posizione: migliora la regolarità del trasporto e l’organizzazione semantica, ma da solo distrugge le relazioni fra posizioni. Il secondo le ripristina, chiedendo che le somiglianze a coppie fra token del latente imitino quelle di DINOv2:
$$\mathcal{L}_{\text{struct}} = \frac{1}{VN(N-1)} \sum_{v} \sum_{i \neq j} \Big( \langle \hat{\mu}_{v,i}, \hat{\mu}_{v,j} \rangle – \langle \hat{d}_{v,i}, \hat{d}_{v,j} \rangle \Big)^2,$$
dove $\hat{\mu}_{v,i}$ è il token normalizzato del latente in posizione $i$ della vista $v$ e $\hat{d}_{v,i}$ quello di DINOv2. Non conta che i due vettori coincidano (non hanno nemmeno la stessa dimensione): conta che chi è vicino a chi resti uguale. È la differenza fra copiare una mappa e conservarne le distanze.
Il generatore: niente di esotico
Sopra il codec congelato gira un trasformatore standard di flow matching, 0,93 miliardi di parametri, che genera insieme i latenti di tutte le viste richieste. Le condizioni sono tre, e ognuna può essere spenta in addestramento: la vista di riferimento, i raggi della camera in coordinate metriche e il testo. Gli stessi pesi fanno quindi testo-immagine, video con camera controllata e sintesi di nuove viste da una foto. La vista di riferimento entra come token pulito e non come stato da denoisare, per un motivo sottile: l’encoder di DA3 codifica ogni immagine in funzione delle altre del gruppo, e in addestramento si avrebbe un contesto che in inferenza non esiste.
Il paper usa il flow matching come strumento, senza spiegarlo: che cosa sia il percorso lineare fra rumore e dati e come lo si percorre con un integratore di Euler è nel libro.
I numeri, a parità di tutto
La parte più convincente del paper è il protocollo. Sette spazi latenti vengono inseriti nello stesso generatore, con gli stessi dati (RealEstate10K e DL3DV), lo stesso budget di addestramento su otto GPU e lo stesso campionatore: due VAE sui pixel (quello di Stable Diffusion e quello video di WAN2.1), RAEv2, due livelli grezzi di DA3 e le due varianti di GAE. Cambia solo lo spazio.
Sulla qualità visiva, GAE-64 abbassa l’FVD del 12,7% su RealEstate10K e del 23,1% su DL3DV rispetto al miglior latente concorrente, che in entrambi i casi è il vecchio VAE di Stable Diffusion, non il VAE video di WAN2.1 né RAEv2. Sulla coerenza 3D, misurata ricostruendo le viste generate con VGGT, un modello indipendente da tutti i latenti in gara, l’errore assoluto di traiettoria della camera scende del 52,8% su RealEstate10K e del 23,3% su DL3DV. La geometria letta direttamente dai latenti generati è la migliore fra i metodi nativi in quasi tutte le metriche, confrontata con un riferimento esterno (Pi3 sulle immagini vere), non con DA3 stesso.
Anche il codec regge da solo: GAE-128 ricostruisce le immagini come il livello 0 grezzo di DA3 (PSNR 34,78 contro 34,70 sui video) con 24 volte meno canali. Le ablazioni dicono che ogni pezzo pesa: se se ne toglie o se ne cambia uno, l’FVD sale. Vale anche per l’addestramento congiunto testo-immagine, che dà al modello un repertorio visivo più ampio.
| Ablazione | Modello completo | Con l’ablazione |
|---|---|---|
| GAE-128, senza gli obiettivi di forma | 233,4 | 266,4 |
| GAE-64, pose normalizzate per scena invece che metriche | 225,7 | 350,7 |
| GAE-64, senza l’addestramento congiunto testo-immagine | 225,7 | 472,9 |
Che cosa resta da verificare
Il banco di prova è piccolo. Il confronto controllato usa 64 scene per dataset, nove viste a 252×252 e un solo riferimento. Bastano a isolare l’effetto del latente, non a dire come si comporti su clip lunghe ad alta risoluzione. Il modello finale, quello delle 81 viste a 672×378 addestrato su 80 GPU e dati in parte interni, è mostrato solo con esempi scelti: gli autori stessi lo tengono fuori dal confronto. Quando la conclusione afferma che i guadagni «persistono» con più dati, risoluzione più alta e sequenze più lunghe, è una dichiarazione che il paper sostiene con figure, non con numeri.
Scene ferme. RealEstate10K e DL3DV sono in larga parte riprese di ambienti statici. Un «world model» dovrà prima o poi fare i conti con oggetti che si muovono, e il paper non lo misura.
La geometria ha un maestro solo. Gli obiettivi geometrici del codec sono pseudo-etichette prodotte dalla testa di DA3, non misure vere: il latente eredita pregi e difetti di quel modello, e la sua generalità dipende da un backbone specifico, con due maestri in più (C-RADIO e DINOv2) in addestramento.
I sistemi esterni non perdono ovunque. Gen3R, che usa un latente geometrico separato, quando codifica e ricostruisce fotogrammi veri restituisce la profondità un po’ meglio, e sulle viste generate di RealEstate10K ha un MEt3R più basso (0,1157 contro 0,1208) e un FID in pratica uguale. Il paper lo riporta nelle tabelle, e va detto.
Niente sezione sui limiti. Il paper chiude con una conclusione, non con un elenco di cose che non funzionano. Papers with Code collega un repository ufficiale di Tencent ARC, ma il testo non dice che cosa verrà rilasciato, se il codice soltanto o anche i pesi.
Perché conta adesso
La corsa ai world model procede soprattutto per scala: più dati, più parametri, più fotogrammi. GAE sposta l’attenzione su una scelta a monte che quasi nessuno rimette in discussione, lo spazio latente e mostra che cambiarla, a parità di tutto il resto, migliora insieme l’aspetto e la geometria invece di scambiare l’uno con l’altra. E suggerisce che il modello che misura una scena e quello che la inventa possano leggere e scrivere lo stesso codice. Se il risultato reggerà su scene in movimento e fuori dal protocollo degli autori, i generatori smetteranno di dipingere cupole viste da un punto solo.
Che cosa si intende per world model, e perché generare video coerenti sia considerato un passo verso un simulatore del mondo, è discusso nel libro.
I commenti sono riservati agli iscritti.
Accedi per commentare