
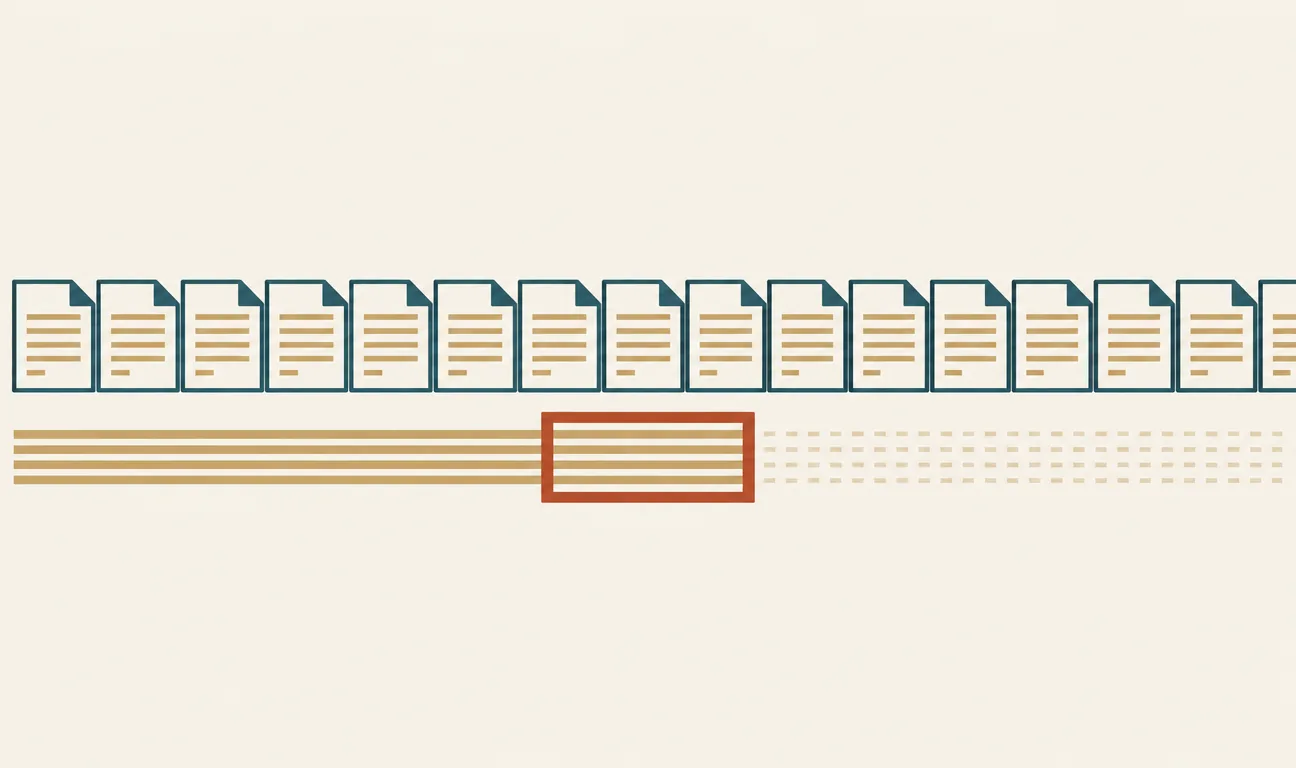
Un amanuense che copia un codice non rilegge da capo tutto quello che ha già scritto prima di tracciare la lettera successiva. Tiene l’originale aperto davanti a sé, dà un’occhiata alle ultime parole della sua copia per sapere dove è arrivato, e va avanti. Le pagine di tre ore prima sono ancora lì, ma non gli servono: lo sforzo per scrivere la riga cinquecento è lo stesso della riga cinque.
I modelli che oggi fanno OCR con un modello linguistico come decoder funzionano al contrario. Ogni nuovo token viene calcolato guardando l’immagine e anche tutto il testo già prodotto, e tutto quel testo va tenuto in memoria. Più il documento è lungo, più la memoria cresce e più ogni passo rallenta. Per questo, scrivono gli autori, nessun modello end-to-end riesce a leggere anche solo dieci pagine di fila: si procede pagina per pagina, dentro un ciclo for, azzerando la memoria a ogni giro.
È questo il problema di Unlimited OCR Works: Welcome the Era of One-shot Long-horizon Parsing, rapporto tecnico di Baidu uscito su arXiv il 22 giugno 2026 (2606.23050), firmato da un gruppo di Baidu che ha fra i contributori principali Youyang Yin e Huanhuan Liu, responsabile del progetto. Codice e pesi sono pubblici. La proposta è piccola da descrivere e ha conseguenze grandi: cambiare la regola con cui il decoder guarda indietro.
Il punto di partenza: DeepSeek-OCR
Il modello di base è DeepSeek-OCR, uscito a ottobre 2025, che aveva riportato l’OCR al centro dell’attenzione con un’idea di compressione: il suo encoder, DeepEncoder, mette in fila una parte a finestre locali (derivata da SAM) e una a attenzione globale (derivata da CLIP), e fra le due riduce di sedici volte il numero di token visivi. Una pagina a 1024×1024 pixel diventa 256 token. Il decoder è un Mixture-of-Experts da 3 miliardi di parametri totali, di cui circa mezzo miliardo attivi a ogni passo.
Baidu tiene l’encoder così com’è, congelato, e interviene solo sul decoder. Le pagine compresse entrano tutte insieme all’inizio, come prefisso; il problema resta a valle, in uscita. Gli autori fanno il conto: se un token visivo si decodifica in circa dieci token di testo, diecimila token visivi chiedono più di centomila token in uscita, e a quelle lunghezze la cache delle chiavi e dei valori, la KV cache, diventa il collo di bottiglia per memoria e per calcolo.
Che cos’è la KV cache, perché nasce dalla generazione un token alla volta e perché la sua crescita pesa su memoria e latenza: è spiegato nel capitolo sull’attenzione messa in opera.
Guardare tutto l’originale, solo l’ultima riga della copia
La modifica si chiama Reference Sliding Window Attention, R-SWA. Ogni token generato ha accesso a due insiemi: tutto il prefisso di riferimento (i token visivi e il prompt, lunghi $L_m$) e soltanto gli ultimi $n$ token di uscita, con $n = 128$ di default. In formule, l’insieme delle posizioni che il token $t$ può guardare è
$$\mathcal{N}(t) = \mathcal{P} \cup \mathcal{D}_n(t), \qquad \mathcal{P} = \{1, \dots, L_m\},$$
dove $\mathcal{D}_n(t)$ è la finestra causale che scorre sulle ultime $n$ posizioni generate. Il softmax dell’attenzione è quello solito, ristretto a quell’insieme. Tutti gli strati di attenzione del decoder vengono sostituiti, nessuno escluso.
La conseguenza sta in due righe. Con l’attenzione piena, dopo $T$ token generati la cache ha dimensione $L_m + T$; con R-SWA
$$C_{\text{R-SWA}}(T) = L_m + \min(n, T) \le L_m + n,$$
cioè un tetto fisso, che dipende da quante pagine si sono date in ingresso ma non da quanto testo si è scritto. La cache si gestisce come una coda: ogni token nuovo entra, il più vecchio della finestra esce.
La differenza con la finestra scorrevole ordinaria è nella parola reference. Una finestra normale, a un certo punto, lascerebbe uscire anche le pagine: il modello scriverebbe senza più vedere l’originale. Qui l’originale resta sempre visibile e intatto. Gli autori scartano anche l’altra strada per rendere lineare il costo, l’attenzione lineare, perché comprime la storia in uno stato che si aggiorna a ogni passo, e far passare i token visivi per quegli aggiornamenti ne sfocherebbe progressivamente i dettagli. Resta una domanda che il meccanismo non risolve da sé: come fa il modello a sapere a che punto della pagina è arrivato, se vede solo 128 token della sua copia? La risposta degli autori è empirica: quelle ultime righe bastano a orientarsi, come all’amanuense.
Come è stato addestrato
Il punto di partenza è il checkpoint di DeepSeek-OCR, addestrato per altri 4000 passi con batch da 256 e sequenze da 32 mila token, su 128 GPU A800. I dati sono circa 2 milioni di esempi di documenti, nove decimi a pagina singola e un decimo a più pagine. Le pagine singole sono annotate con PaddleOCR, lo strumento OCR della stessa Baidu. I documenti multipagina, circa 200 mila, sono sintetici: pagine singole incollate una dopo l’altra, da 2 a 50, separate da un marcatore di pagina.
I numeri
Sulla pagina singola. Su OmniDocBench v1.5, il banco di prova di riferimento per il parsing di documenti (testo, formule, tabelle, ordine di lettura), Unlimited OCR supera DeepSeek-OCR nel punteggio complessivo, e migliorano tutte le voci.
| Voce | DeepSeek-OCR | Unlimited OCR |
|---|---|---|
| Punteggio complessivo | 87,01 | 93,23 |
| Testo, distanza di edit | 0,073 | 0,038 |
| Formule | 83,37 | 92,61 |
| Tabelle (TEDS) | 84,97 | 90,93 |
| Ordine di lettura, errore | 0,086 | 0,045 |
Sulla versione 1.6, più recente e con 296 immagini in più, Unlimited OCR è primo con 93,92, ma di due centesimi: Qianfan-OCR fa 93,90, Logics-Parsing-v2 93,33. Ed è dietro ad altri su singole voci (FireRed-OCR ha un errore sul testo più basso, 0,037 contro 0,042; Qianfan-OCR fa meglio sulle tabelle). I numeri degli altri modelli vengono dal repository del benchmark, quelli di Unlimited OCR sono misurati dagli autori. Nel dettaglio per tipo di documento, rispetto a DeepSeek-OCR il miglioramento è su tutti e nove i tipi; rispetto a DeepSeek-OCR 2 gli autori dichiarano sette su nove, e nella tabella del paper è così per l’ordine di lettura, mentre sul testo sono sei, più un pareggio.
Perché i token visivi costano, e perché comprimere una pagina in 256 token è ciò che rende pensabile metterne decine nello stesso prefisso: il compromesso fra risoluzione e numero di token è spiegato nel capitolo sui modelli visione-linguaggio.
Sulla velocità. Su OmniDocBench, con 512 richieste in parallelo, Unlimited OCR produce 5580 token al secondo contro 4951, il 12,7% in più: poco, perché i documenti del benchmark sono corti. La tabella che conta è un’altra, un test «di tetto teorico» con prefisso di soli 10 token: a 256 token in uscita i due modelli sono appaiati, circa 7229 token al secondo. A 6144 DeepSeek-OCR è sceso a 5823, mentre Unlimited OCR è ancora a 7848, il 35% in più. Anche la latenza del kernel di attenzione (FlashAttention 3), misurata passo per passo, resta piatta, mentre quella del modello di partenza sale a ogni token.
Sui documenti lunghi. Qui la prova è su un insieme interno: romanzi, documenti e articoli divisi per numero di pagine, almeno dieci per categoria. La distanza di edit cresce con la lunghezza: 0,036 con 2 pagine, 0,057 con 20, 0,107 oltre le 40. Distinct-35, la quota di n-grammi di lunghezza 35 distinti sul totale (una misura di quanto il modello si inceppi ripetendo se stesso), resta sopra il 99% fino a 20 pagine e scende al 96,9% oltre le 40. Gli autori attribuiscono gli errori residui alla risoluzione, non al meccanismo: in modalità multipagina l’encoder lavora a 1024×1024, e i caratteri piccoli diventano illeggibili.
Che cosa il report non separa
Da dove viene il guadagno sulla pagina singola. I sei punti in più su OmniDocBench arrivano insieme a 4000 passi di addestramento aggiuntivo su 2 milioni di documenti annotati da PaddleOCR. Manca il confronto che isolerebbe l’effetto di R-SWA: lo stesso addestramento con l’attenzione piena. Gli autori parlano di «pranzo gratis», e sulla qualità è plausibile che la finestra non faccia danni; che sia lei a produrre il miglioramento, dai dati del paper non si può dire.
La prova lunga è fatta in casa. L’insieme multipagina è interno e il report non dice se verrà pubblicato. I numeri non crescono in modo regolare: 15 pagine vanno peggio di 20 (0,079 contro 0,057), segno di categorie piccole e rumorose; e la categoria da 15 pagine compare in tabella ma non nella descrizione del test. E l’addestramento multipagina usa pagine incollate a caso: il modello non ha mai visto un testo che continua da una pagina all’altra, che è il caso tipico di un libro.
«Illimitato» è un titolo, non una misura. Lo dicono gli stessi autori nella sezione sui limiti: l’uscita ha memoria costante, ma l’ingresso no. Le pagine stanno tutte nel prefisso, 256 token ciascuna, e il contesto massimo di addestramento è 32 mila. Il piano dichiarato è un modello a 128 mila token e, più avanti, un «archivio» di pagine precodificate da cui il modello impari a pescare, come chi sfoglia un libro.
Il confronto è con il proprio punto di partenza. Le misure di efficienza mettono Unlimited OCR accanto a DeepSeek-OCR, non ad altre strategie per contenere la cache, e il 35% viene da una condizione ideale con prefisso minimo, non da un documento reale di trenta pagine. Anche il numero dei parametri attivi oscilla fra testo e figure (500 milioni nel testo, 570 in uno schema).
Perché conta adesso
Chi oggi digitalizza archivi, manuali o fascicoli con un modello visione-linguaggio lo fa con un ciclo esterno che spezza il documento in pagine e le ricuce dopo. Funziona, ma ogni pagina riparte da zero, e il costo di ogni token dipende da quanto si è già scritto. Unlimited OCR mostra che, almeno per un compito di copia, un decoder può fare a meno di ricordare tutto ciò che ha scritto senza perdere qualità sul benchmark di riferimento, e che così la velocità smette di dipendere dalla lunghezza. Gli autori pensano già alla trascrizione del parlato e alla traduzione, gli altri lavori in cui c’è un originale da seguire riga per riga. Con pesi e codice pubblici, e il supporto in Transformers e SGLang, la prova che manca, quella su documenti lunghi veri e con un confronto alla pari, possono farla altri.
I commenti sono riservati agli iscritti.
Accedi per commentare