
Chi ha seguito una partita di calcio alla radio conosce tre voci diverse. Il telecronista dice che cosa succede in questo secondo: passaggio corto, stop di petto, tiro. Il commentatore tecnico, fra un’azione e l’altra, spiega che cosa la squadra sta cercando di fare da dieci minuti: allargare il gioco sulla fascia destra. E l’allenatore, in conferenza stampa, racconta la strategia della serata: aspettarli e ripartire. Sono tre descrizioni della stessa partita, e tutte e tre finiscono negli stessi piedi che toccano lo stesso pallone.
Un videogioco funziona allo stesso modo, ed è da qui che parte GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay, depositato su arXiv il 21 settembre 2026 (2609.25001) e in questi giorni fra i paper in tendenza su Papers with Code. Lo firmano quindici autori, in gran parte di ARC Lab di Tencent, con Great Bay University, National University of Singapore, Huazhong University of Science and Technology, la Chinese University of Hong Kong e l’Università di Macao; Yiran Wang guida il progetto, Xiaodong Cun è l’autore di riferimento. Raccogliere un oggetto richiede secondi, vincere uno scontro qualche minuto, portare avanti una strategia un’intera sessione: ma tutto passa per la stessa fila di tasti e movimenti del mouse.
Due famiglie che non si possono confrontare
Oggi i modelli che giocano si dividono in due famiglie, e secondo gli autori ciascuna sa fare metà del lavoro. Gli agenti nati per i videogiochi, come NitroGen, Open-P2P o JARVIS-VLA, sono architetture leggere addestrate a imitare traiettorie di comandi: reagiscono in fretta, ma a scapito della capacità di ragionare e pianificare. I grandi modelli generalisti, al contrario, pianificano bene, ma sull’azione concreta nessuno li ha mai misurati in modo sistematico. I casi noti, come Gemini o Claude alle prese con Pokémon, girano dentro impalcature costruite apposta e non si confrontano fra loro.
Gli strumenti esistenti non aiutano. Molti dataset stanno dentro un solo gioco (quasi sempre Minecraft) o in minigiochi semplificati; quasi nessuno ha istruzioni in linguaggio naturale, e quando ci sono sono rade, una ogni qualche minuto nel caso di Open-P2P. E i benchmark si basano su poche partite giocate dal vivo: tre tentativi per scena in Lumine, fra tre e venti casi in GameVerse. Con campioni così, notano gli autori, il confronto ha poca fiducia, dipende dall’impalcatura e dal gioco, e un tasso di successo aggregato non dice perché un modello ha sbagliato.
Perché misurare un agente è più difficile che misurare un modello, e perché il risultato dipende tanto dall’impalcatura che gli si costruisce intorno: se ne parla nel capitolo sulle architetture degli agenti e sulla loro valutazione.
Cento giocatori, tre scale di tempo
La proposta ha tre pezzi. Il primo sono i dati grezzi, e qui gli autori fanno una scelta costosa: invece di scaricare video dal web e ricostruire a posteriori i comandi con un modello che li indovina, reclutano cento giocatori esperti e registrano insieme il video a risoluzione 2K e ogni evento di tastiera e mouse con il suo istante. Il risultato sono 5.000 ore su 21 titoli, da Valorant (617,5 ore, la fetta più grande) a Honor of Kings: World (35,9 ore), passando per Minecraft, GTA V, Cyberpunk 2077, Elden Ring, Red Dead Redemption 2: 4.571 video a 60 fotogrammi al secondo e 411,03 milioni di eventi, circa 22,8 al secondo. Dopo aver tolto filmati senza azione e momenti fuori dalla finestra di gioco, restano per le istruzioni 4.341 ore, l’86,8%.
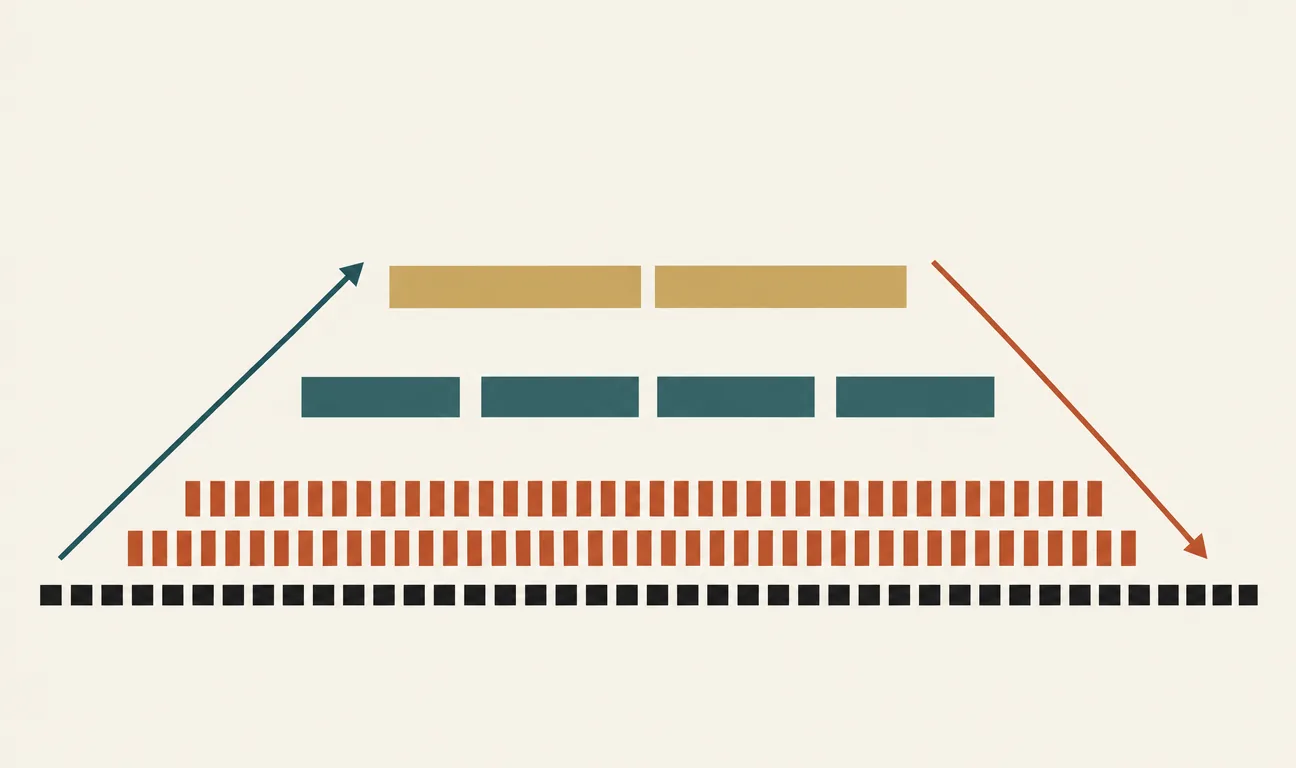
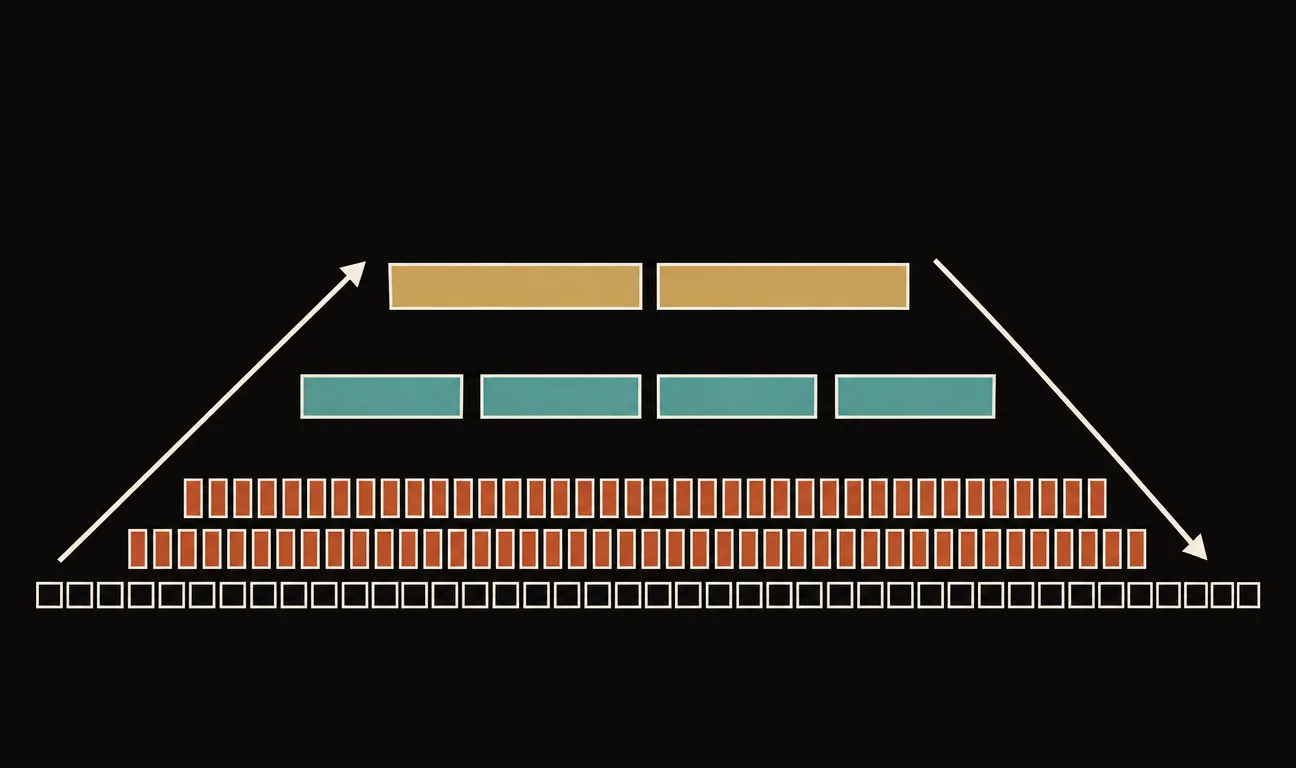
Il secondo pezzo è l’annotatore, ed è il cuore del lavoro. Un modello visivo, Gemini 3.5 Flash, scrive per ogni tratto di partita un’istruzione su tre livelli. In basso le operazioni di 1–5 secondi, del tipo «ricarica l’arma»; in mezzo gli obiettivi di 1–2 minuti; in cima le strategie di 5–8 minuti, del tipo «difendi il ponte». Il procedimento va dal basso verso l’alto: prima si taglia il video usando i comandi stessi, perché un cambio d’inquadratura veloce inganna gli strumenti che guardano solo le immagini, poi il modello unisce i tratti vicini quando perseguono lo stesso fine, e un algoritmo di programmazione dinamica tiene ogni livello dentro la sua finestra di durata. Alla strategia il modello arriva senza i comandi, solo dalle immagini e dagli obiettivi sottostanti: per non perdersi nei dettagli.
Il bilancio è di 6.184.036 istruzioni, e ogni fotogramma ha sopra di sé tutti e tre i livelli.
| Livello | Istruzioni | Durata media |
|---|---|---|
| Operazioni | 5.947.588 | 2,63 secondi |
| Obiettivi | 189.158 | 82,6 secondi |
| Strategie | 47.290 | 330,4 secondi |
La densità si legge in un conto semplice sulle ore annotate:
$$\frac{4341 \times 3600\ \text{s}}{5\,947\,588} \approx 2{,}63\ \text{s per operazione}.$$
Un benchmark a quiz, e uno a partite vere
Il terzo pezzo è GameHorizon-Bench, e ha due binari. Quello offline trasforma i dati in domande a scelta multipla con quattro opzioni, quindi con il 25% di probabilità di indovinare a caso. Tre compiti principali da 1.000 domande ciascuno: dati alcuni fotogrammi e un’operazione, scegliere la sequenza di comandi giusta (T1); dato un obiettivo, scegliere quali operazioni, e in che ordine, lo realizzano (T2); scegliere la combinazione coerente di strategia, obiettivo, operazione e comandi (T3). Più dieci varianti diagnostiche da 200 domande, per un totale di 5.000. Niente gioco da far girare, niente impalcatura: una volta rilasciati i dati, chiunque potrà rifare la misura.
Quello online serve a controllare che i quiz dicano qualcosa sul giocare davvero. Venti compiti lunghi in Minecraft, scelto perché nella maggior parte dei titoli AAA lo stato interno del gioco non è accessibile, spezzati in 62 sottocompiti verificabili: dieci «causali», dove l’ordine è obbligato (mungere la mucca, fare la torta, metterla in tavola), e dieci «tematici», dove non lo è (costruire piccone, ascia e pala per una cassetta degli attrezzi). Ogni sottocompito ha un tetto di 400 chiamate al modello; se fallisce, il gioco viene riportato allo stato in cui quel passo risulta riuscito, e si prosegue. Così si vede non solo se un modello ha fallito, ma dove.
Che cosa dicono i numeri
I modelli valutati sono 47, con oltre un milione di chiamate in tutto. I 44 capaci di rispondere a domande stanno fra il 44,6% e l’80,2%, con una media del 64,7%. Dei primi undici, dieci sono modelli chiusi.
| Modello | Accuratezza |
|---|---|
| GPT-6-Astra | 80,2% primo |
| Gemini 3.8 Flash | 77,3% |
| Gemini 3.7 Flash | 76,7% |
| Kimi-K3, l’unico a pesi aperti fra i primi undici | 74,5% sesto |
| I tre Claude, valutati come agenti di programmazione | |
| Fable 5 | 71,2% tredicesimo |
| Opus 4.8 | 64,8% |
| Sonnet 5 | 64,7% |
I difficili sono i comandi: la scelta della sequenza giusta (T1) si ferma al 57,3% di media, contro il 65,1% di T2 e il 71,6% di T3.
Il dato più netto riguarda gli agenti specializzati. Su giochi AAA mai visti stanno attorno al livello del caso, e due su tre persino sotto.
| Agente | Accuratezza |
|---|---|
| NitroGen | 22,0% |
| Open-P2P | 24,4% |
| JARVIS-VLA | 28,1% |
| Risposta a caso | 25% quattro opzioni |
JARVIS-VLA, sui dati di Minecraft (VPT) su cui è stato addestrato, arriva al 54,2%, quanto Gemma 4 31B senza alcun addestramento specifico (54,1%). Chi ha imparato a giocare a un gioco, per ora, ha imparato quel gioco.
Le varianti dicono dove sta il collo di bottiglia. Riconoscere l’azione in corso è più facile che decidere la prossima, per tutti e quattro i modelli provati. Aggiungere ai fotogrammi l’istruzione di breve termine alza il riconoscimento dal 44,5% al 58,6%, senza addestrare nulla; per pianificare le mosse successive, invece, serve la piramide intera, che porta l’accuratezza dal 34,6% al 41,8%. E riassumere dal basso è quasi banale (98,4%) mentre scomporre dall’alto no (69,5%): è la ragione per cui annotatore e benchmark vanno in direzioni opposte, come nella figura. Il ragionamento esplicito, infine, provato su quattro modelli, aiuta i più forti (Doubao-Seed-2.1-Pro guadagna 9,3 punti, quasi 20 sulla scomposizione) e danneggia i piccoli, che si inventano passaggi: UI-TARS-1.5-7B perde 8,2 punti.
Sulle partite vere i dodici modelli provati, tre per fascia della classifica offline, si dispongono esattamente nell’ordine delle fasce. Ma il compito lungo resta un muro: GPT-6-Astra completa il 66,1% dei sottocompiti e il 45% dei compiti interi, dieci modelli su dodici non vanno oltre il 10%. Una parte del motivo è aritmetica. Se un compito ha $n$ passi e ognuno riesce con probabilità $p_i$, senza aiuti
$$P(\text{compito}) = \prod_{i=1}^{n} p_i,$$
e con una media di $62/20 = 3{,}1$ passi anche un buon tasso sui singoli si sbriciola. Il prodotto è una semplificazione nostra, che tratta i passi come indipendenti: per GPT-6-Astra darebbe circa il 28%, meno del 45% osservato, segno che i suoi errori si addensano su alcuni compiti invece di spargersi.
Che cosa resta da verificare
Le istruzioni le ha scritte un modello, e il paper non dice quanto sono giuste. Tutta la piramide è prodotta da Gemini 3.5 Flash; il paper la dice «di alta qualità», ma nel testo non c’è una verifica umana su un campione. Non è un dettaglio, perché le risposte corrette dei compiti T2 e T3 sono fatte di quelle stesse istruzioni: e quattro Gemini, fra cui lo stesso 3.5 Flash, stanno fra i primi sette. Non è la prova di un vantaggio, ma è una domanda che il paper non si pone.
Un quiz non è una partita. Scegliere fra quattro sequenze è più facile che produrne una, e gli agenti specializzati, che non rispondono a domande, vengono giudicati allineando la loro uscita alle opzioni; per NitroGen serve anche tradurre i comandi del gamepad in tastiera e mouse. Il loro risultato vicino al caso misura anche la distanza dal formato, non solo dal gioco.
La verifica online è piccola, e in un gioco solo. Venti compiti in Minecraft, dodici modelli: la stessa ristrettezza di campione che gli autori rimproverano ai benchmark precedenti, e proprio fuori dai titoli AAA su cui il resto è costruito. Anche le varianti diagnostiche poggiano su quattro modelli e 200 domande. Infine, il rilascio di dati, annotatore e benchmark è per ora solo promesso, e il paper non discute come verranno distribuite ore di filmati di giochi commerciali.
Perché conta adesso
I videogiochi sono diventati un terreno su cui i laboratori misurano i loro agenti, ma finora ognuno lo faceva a casa propria, con le sue regole. GameHorizon propone un metro comune, economico e ripetibile, e porta nel conto un’idea che il settore tende a dimenticare: lo stesso gesto ha significati diversi a seconda della distanza da cui lo si guarda, e un agente utile deve saperli tenere insieme. I risultati dicono per ora che i generalisti riconoscono l’azione in corso meglio di quanto sappiano scegliere la successiva, e che gli specialisti, fuori dal proprio gioco, scendono al livello del caso. Se il dataset uscirà come promesso, la parte più interessante sarà vedere quanto di questo divario si chiude addestrando un modello proprio su quelle tre voci della stessa partita.
I commenti sono riservati agli iscritti.
Accedi per commentare