
Chi ha lavorato in una cucina di ristorante il sabato sera sa che un bravo cuoco non basta. Si può avere il miglior cuoco della città: se deve preparare da solo antipasti, secondi e dolci per ottanta coperti, a un certo punto il risotto aspetta il pesce, il pesce aspetta il forno, e nessuno si ricorda più quale tavolo aveva chiesto senza glutine. Le cucine che reggono il servizio non hanno cuochi più bravi. Hanno stazioni con compiti chiari, comande che dicono che cosa va fatto e in che ordine, e una lavagna dove si vede che cosa è uscito e che cosa è tornato indietro.
È la tesi di Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence, depositato su arXiv il 21 agosto 2026 (2608.21156) e aggiornato il 26 agosto; a settembre è comparso fra i paper in tendenza su Papers with Code. Lo firmano trentacinque autori; il responsabile del progetto è Qinggang Zhang, con un indirizzo email dell’Università di Jilin, e le risorse raccolte stanno in un repository del gruppo DEEP-JLU. È una survey: 64 pagine, 517 riferimenti, nessun esperimento proprio. Il suo contributo non è un metodo ma un modo di mettere in ordine il campo, e un nome nuovo da dargli.
La scala delle ingegnerie
Il paper parte da una genealogia che chi segue il settore riconoscerà. Prima si rendevano più capaci i modelli con pre-training e post-training. Poi si è imparato a usarli meglio al momento dell’inferenza: il prompt engineering decide come formulare il compito, il context engineering che cosa mettere davanti al modello. Insieme producono quella che gli autori chiamano intelligenza del modello. Il passo successivo è l’agente, che il paper riassume in una formula volutamente spoglia:
$$\mathrm{Agente} = \mathrm{Loop}(\mathrm{LLM} + \mathrm{Harness})$$
L’harness engineering collega il modello a strumenti, memoria, skill e ambiente di esecuzione; il loop engineering organizza il tutto in cicli di pianificazione, azione, osservazione e verifica. Il risultato è l’intelligenza individuale: un agente che persegue un obiettivo nel tempo.
Qui si dà per noto il ciclo dell’agente: un modello che ragiona, chiama uno strumento, legge il risultato e ripete. Come si costruisce, tool e memoria compresi, è spiegato da capo nel libro.
La tesi della survey è che questa scala abbia raggiunto un soffitto, e che il soffitto non si alzi aggiungendo capacità o contesto allo stesso agente. Gli autori elencano tre limiti strutturali. Il primo è lo scheduling: un singolo loop comprime in una sequenza compiti che potrebbero procedere in parallelo. L’esempio è la diagnosi di un guasto software, dove analisi dei log, riproduzione del guasto e ispezione del codice sono rami quasi indipendenti, mentre riparazione e test dipendono dai loro risultati. Il secondo è la verifica: quando lo stesso agente scrive e valuta il codice, rischia di scambiare il proprio giudizio per una prova, anche se il prompt gli assegna due ruoli diversi. Il terzo è lo stato: il contesto di un agente non è uno stato organizzato, e un piccolo errore commesso presto in un compito lungo può restare nascosto fino al fallimento finale, quando è ormai difficile dire dove sia entrato.
Da qui il concetto centrale, l’intelligenza di sistema: la capacità di un insieme di componenti di scomporre un obiettivo, distribuire le responsabilità, coordinare l’esecuzione e tenere uno stato comune. Gli autori formalizzano un sistema di agenti al tempo $t$ come
$$S^t = \langle A^t, R^t, E^t, \Pi^t, x^t \rangle$$
dove $A^t$ è la squadra, $R^t$ le risorse condivise, $E^t$ l’ambiente, $\Pi^t$ i meccanismi di coordinamento e $x^t$ lo stato del sistema, distinto dallo stato locale di ogni agente. E insistono su un punto che vale la pena sottolineare: intelligenza di sistema non significa più agenti. Un sistema multi-agente può avere più agenti capaci e mancare comunque di un’organizzazione del lavoro efficace, di confini di responsabilità chiari, di uno stato coerente.
Che mettere più agenti insieme abbia un prezzo, in token, latenza ed errori che si propagano, e quando quel prezzo vale la pena pagarlo, è l’argomento di un capitolo del libro.
Tre grafi e una lavagna
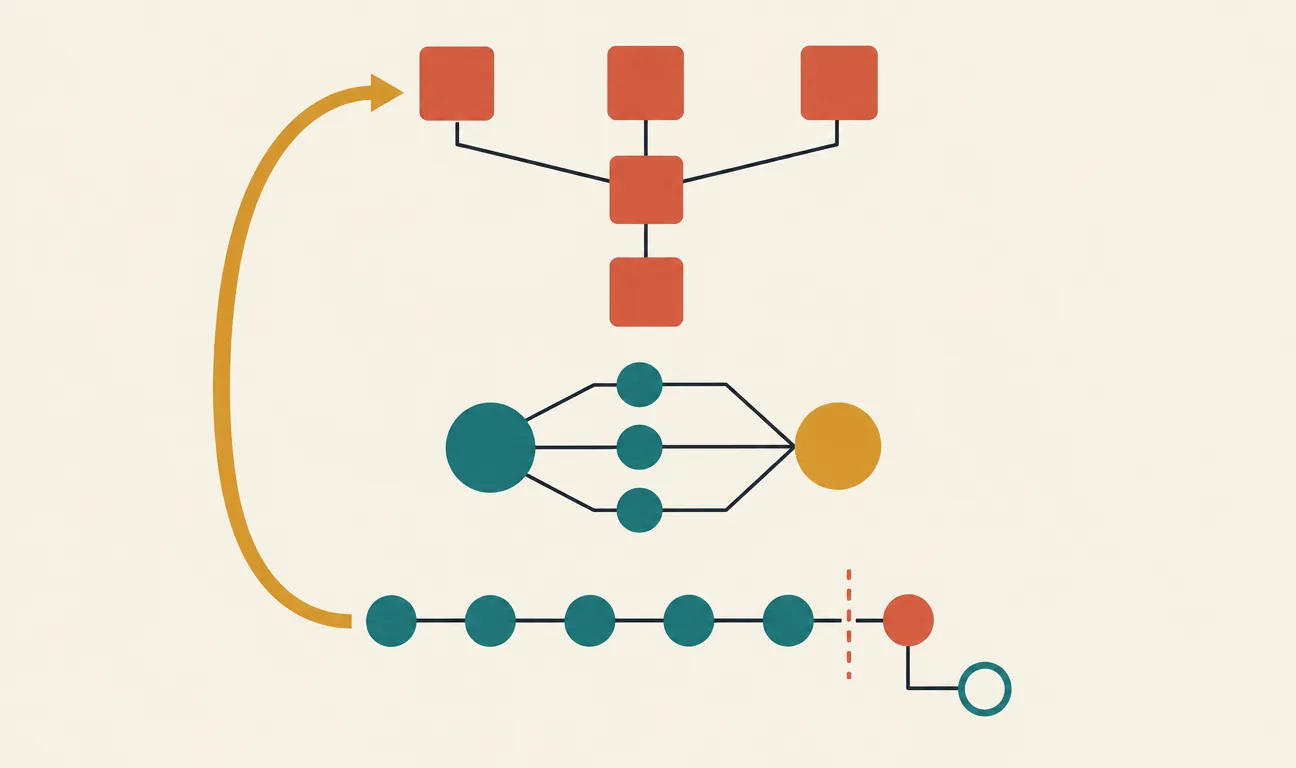
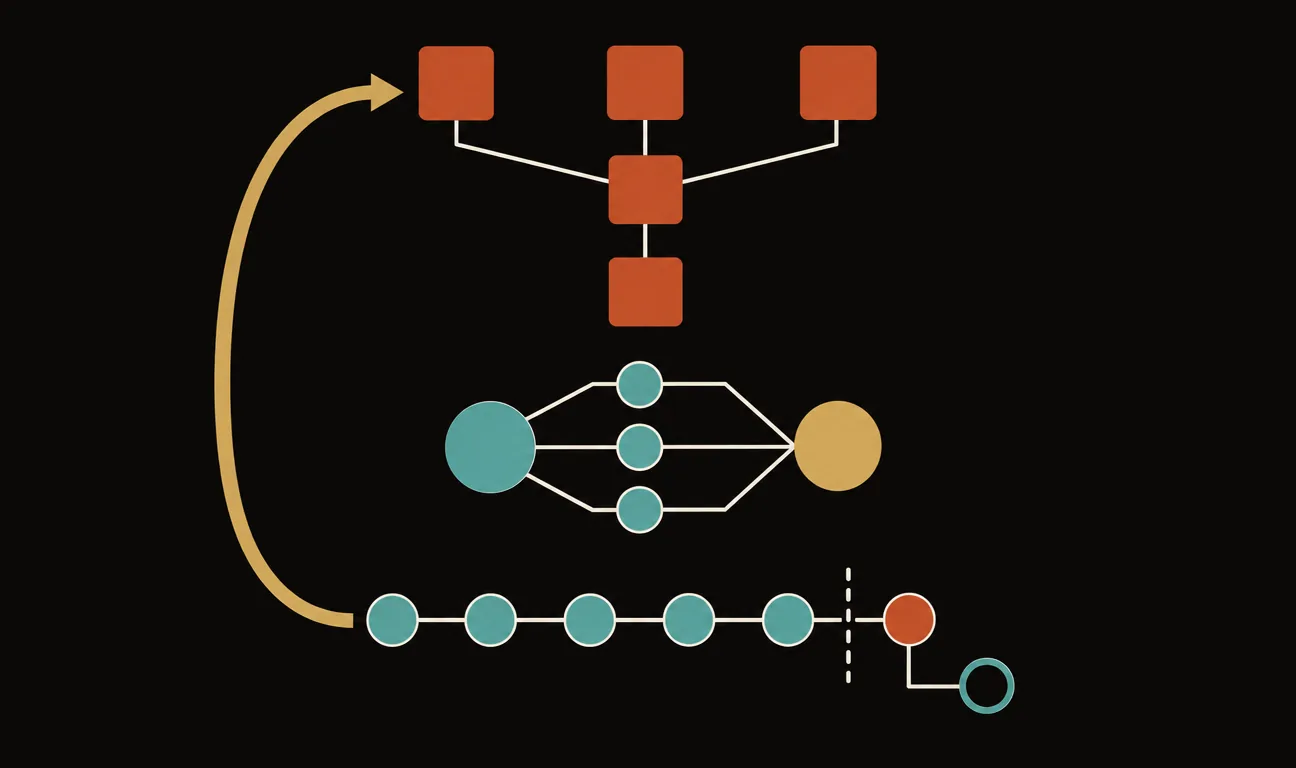
La Graph Engineering è la risposta proposta: usare grafi espliciti, e non il testo dentro un contesto, per rappresentare tre cose. Sono le stazioni, le comande e la lavagna della cucina.
La prima vista è l’organizzazione dei compiti: che cosa va fatto. L’obiettivo diventa un grafo di sotto-obiettivi, con archi che dicono chi deve aspettare chi. La linea che la survey ricostruisce va da HuggingGPT, che già scomponeva le richieste e le instradava a modelli specializzati, a LLMCompiler, che compila un piano di chiamate a funzione in un grafo aciclico e lancia in parallelo i nodi le cui dipendenze sono soddisfatte, fino ad AFlow e ai suoi successori, dove è la struttura stessa del flusso a diventare oggetto di ricerca automatica. I lavori più recenti, come DyFlow ed EvoFlow, adattano il grafo durante l’esecuzione invece di fissarlo prima: DyFlow decide i passi successivi dai risultati intermedi, EvoFlow fa evolvere al volo più flussi candidati.
La seconda è il coordinamento degli agenti: chi fa che cosa. Qui i grafi rappresentano capacità (quale agente sa fare cosa e con quali permessi), organigramma (catene come MetaGPT e ChatDev, un orchestratore che smista come in Magentic-One, strutture che si allargano e poi ricompongono come Mixture-of-Agents) e comunicazione. Su quest’ultima la survey raccoglie un risultato controintuitivo: più collegamenti non garantiscono una collaborazione migliore, perché la struttura decide anche come si propagano le informazioni sbagliate. Metodi come AgentPrune e AgentDropout riducono il costo della collaborazione togliendo archi e agenti che contribuiscono poco, non aggiungendone.
La terza, la più interessante per chi ha messo in produzione un agente, è la gestione dello stato in esecuzione: che cosa è successo davvero. Qui la survey attinge a idee che l’ingegneria dei database conosce da decenni. Registri espliciti dello stato di avanzamento, come i due «ledger» di Magentic-One. Un confine tra proposta, validazione e commit prima che la modifica di un agente diventi stato condiviso, come in PatchBoard e MemTX. Storici append-only da cui si può rigiocare o biforcare un’esecuzione. E per il ripristino, checkpoint combinati con azioni di compensazione per gli effetti che non si possono annullare, come in SagaLLM e RAC. L’avvertenza metodologica è giusta: una dipendenza nel grafo restringe la ricerca della causa di un guasto, ma non la dimostra.
Sopra le tre viste c’è l’evoluzione del sistema: usare l’esperienza delle esecuzioni per riscrivere i grafi stessi. È anche la parte più acerba, come mostra la rassegna delle applicazioni.
Che cosa mostrano le applicazioni
La sezione sulle applicazioni, che attraversa software, scienza, sanità, flussi aziendali, assistenti digitali personali e simulazioni sociali, arriva a una conclusione sobria. Scomporre gli obiettivi e dividere i ruoli è ormai prassi comune; la gestione esplicita dello stato si sta diffondendo, con checkpoint, bacheche di compiti condivise, flussi di eventi. L’evoluzione persistente della struttura invece è rara: la maggior parte dei sistemi si adatta dentro un’organizzazione decisa prima.
Da qui una distinzione che è forse la cosa più utile del paper: un sistema può essere strutturato a grafo senza essere ingegnerizzato a grafo. Gli agenti per il codice sono l’esempio più chiaro: nati attorno a una sola traiettoria, oggi espongono sotto-agenti, worktree paralleli, bacheche di compiti e squadre. Ma quelle strutture di solito sono scelte a mano o fissate prima dell’esecuzione.
I limiti
Il primo è di genere. Una survey che introduce un nome e una tassonomia non dimostra niente; organizza. Non ci sono numeri propri, e i risultati dei lavori citati non sono messi a confronto in una tabella comune. Chi cerca la prova che un agente con tre grafi espliciti batta un agente singolo con lo stesso budget non la troverà qui.
Gli autori, e va riconosciuto, lo dicono da soli. Il successo sul compito finale non basta a stabilire che un sistema abbia intelligenza di sistema: il guadagno potrebbe venire da un modello più forte, da un contesto più lungo, da più campioni o semplicemente da più calcolo. Chiedono benchmark con budget di esecuzione allineati, grafi versionati, tracce complete e perturbazioni strutturali controllate: cioè gli strumenti che servirebbero a verificare la loro stessa tesi, e che oggi mancano.
Il secondo limite è terminologico. Dopo prompt, context, harness e loop engineering, una quinta ingegneria rischia di aggiungere un’etichetta più che un concetto. Molto di ciò che la survey raccoglie sotto «gestione dello stato» si chiama da tempo transazioni, event sourcing, compensazione, e sono i nomi che la survey stessa usa: raccoglierli sotto un’etichetta nuova aiuta a costruire un campo, non necessariamente a capirlo. E il capitolo sulle direzioni future apre già un’ulteriore ingegneria, quella delle ontologie, necessaria perché agenti diversi possono ancora non essere d’accordo su che cosa significhi «compito finito» o «prova sufficiente».
Il terzo riguarda i rischi, che la survey tocca in poche righe: uno stato condiviso e persistente moltiplica i punti in cui un dato sensibile può essere copiato o dedotto dalle tracce; le decisioni distribuite rendono più difficile attribuire una responsabilità; e un flusso che si ripianifica da sé può essere spinto verso percorsi indesiderati da segnali manipolati, come mostra FlowSteer. Anche le simulazioni sociali ricevono un’avvertenza corretta: un comportamento emergente in una società di agenti dipende da modello, persona, topologia e regole, e non vale come prova di causalità nel mondo reale senza una calibrazione sui dati.
Perché conta adesso
La discussione sugli agenti degli ultimi due anni è stata quasi tutta individuale: prompt migliori, contesti più lunghi, harness più ricchi. Questa survey sposta la domanda sull’organizzazione, e lo fa nel momento in cui i prodotti hanno già preso quella strada senza aspettare la teoria. La sua lezione più solida non ha bisogno del nome nuovo: l’intelligenza di un sistema dipende meno dal numero di modelli e più da come sono scritte le relazioni fra lavoro, attori e stato. Come in cucina, dove il sabato sera lo reggono le comande e la lavagna, non il cuoco da solo. Resta da misurare quanto valgano, a parità di tutto il resto.
La raccolta di lavori, dati e progetti citati è su github.com/DEEP-JLU/Awesome-Graph-Engineering.
I commenti sono riservati agli iscritti.
Accedi per commentare