Ti è mai capitato? Hai addestrato un random forest, l’accuratezza non ti convince, e allora inizi il rituale: cambi max_depth da 5 a 10, riesegui, segni il risultato su un foglio. Poi provi n_estimators=300. Poi tutte e due insieme. Dopo un’ora hai sette numeri sparsi in un file di appunti, non ricordi più quale combinazione ha prodotto quale punteggio, e — dettaglio peggiore — hai valutato tutto sullo stesso test set, quindi ti stai lentamente overfittando a mano. C’è un modo migliore, e scikit-learn te lo regala in due varianti: grid search e random search. In questo tutorial le usiamo entrambe, e capiamo quando la seconda batte la prima.
Grid search, random search, successive halving e Hyperband: la ricerca degli iperparametri è nel libro.
Ripasso lampo: cosa stiamo cercando, esattamente
Se non ricordi la differenza, ti basta questo: i parametri li impara il modello dai dati durante il fit (i pesi, i coefficienti), gli iperparametri li scegli tu prima del fit (la profondità di un albero, il C di una SVM, il numero di vicini di un KNN). Il problema è che «li scegli tu» è una fregatura: come fai a sapere che C=1.0 è meglio di C=10? Non lo sai. Devi provare.
E qui serve il secondo richiamo: la cross-validation. Se non la ricordi, ti basta sapere che divide il training set in K fette e addestra K volte, usando a turno una fetta come validazione: il punteggio medio è una stima onesta di come il modello generalizza, senza mai toccare il test set. Ogni combinazione di iperparametri va valutata così, altrimenti stai scegliendo la combinazione che per caso piace al tuo test set — e il giorno del debutto in produzione la magia svanisce.
Grid search: la degustazione completa del menu
L’idea della grid search è brutale e onesta: definisci una griglia di valori per ogni iperparametro e provi tutte le combinazioni. È come entrare in una gelateria con 4 gusti e 3 formati di cono e assaggiarli tutti e dodici prima di decidere: costoso, ma alla fine sai per certo qual è il migliore tra quelli assaggiati. Con scikit-learn bastano poche righe, e conviene sempre cercare sopra una Pipeline, così lo scaling viene ri-fittato correttamente dentro ogni fold:
# ambiente 2026: Python 3.12 + uv, editor VS Code o PyCharm
# uv venv .venv && source .venv/bin/activate && uv pip install scikit-learn
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = load_breast_cancer(return_X_y=True)  # dataset incluso, nessun download
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("svm", SVC()),
])

# la griglia: nota la sintassi "passo__iperparametro" per entrare nella pipeline
param_grid = {
    "svm__C": [0.1, 1, 10, 100],          # 4 valori
    "svm__gamma": [0.001, 0.01, 0.1, 1],   # 4 valori
    "svm__kernel": ["rbf", "linear"],      # 2 valori
}
# totale: 4 x 4 x 2 = 32 combinazioni, x 5 fold = 160 addestramenti!

grid = GridSearchCV(pipe, param_grid, cv=5, scoring="accuracy", n_jobs=-1)
grid.fit(X_train, y_train)   # la ricerca vera e propria

print("Migliore combinazione:", grid.best_params_)
print(f"Accuratezza in cross-validation: {grid.best_score_:.3f}")
print(f"Accuratezza sul test (mai visto): {grid.score(X_test, y_test):.3f}")
Nota tre cose. Primo: n_jobs=-1 usa tutti i core della macchina, perché le combinazioni sono indipendenti e si valutano in parallelo. Secondo: dopo il fit, grid si comporta come il modello migliore già riaddestrato su tutto il training set — puoi chiamare grid.predict direttamente. Terzo, il conto che fa paura: 32 combinazioni per 5 fold sono 160 addestramenti. Aggiungi un quarto iperparametro con 5 valori e diventano 800. La griglia esplode in modo combinatorio: è la sua condanna.
Random search: le freccette intelligenti
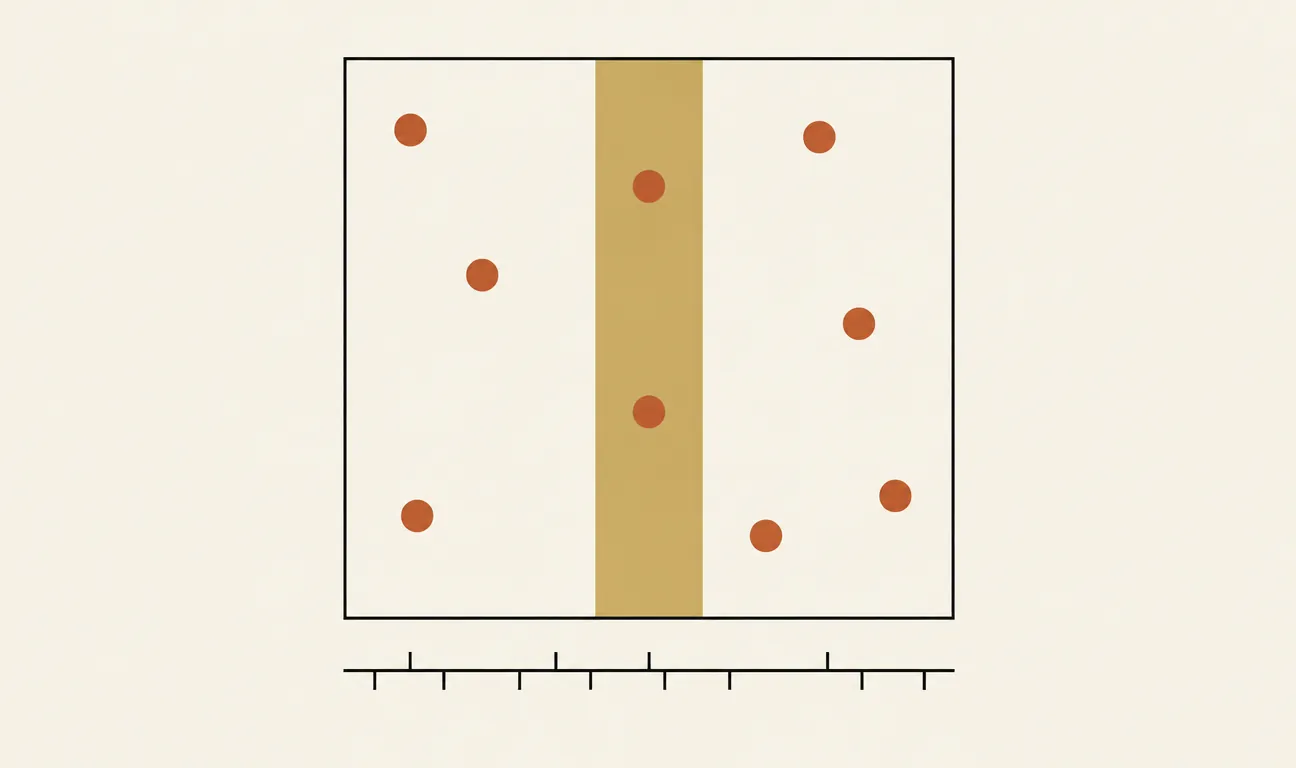
Nel 2012 Bergstra e Bengio hanno formalizzato un’osservazione controintuitiva: nella maggior parte dei problemi, solo uno o due iperparametri contano davvero — gli altri spostano poco. E la griglia, su questo, spreca in modo imbarazzante. Immagina di avere 16 tentativi su due iperparametri: la griglia 4×4 prova solo 4 valori distinti di ciascuno. Sedici lanci di freccette in posizioni casuali, invece, esplorano 16 valori diversi di ogni dimensione: se una delle due è quella che conta, la campioni quattro volte più fitta, gratis.
La griglia spende i suoi tentativi in modo democratico su tutte le dimensioni. Il caso li spende dove serve — anche senza sapere in anticipo dove serve.
RandomizedSearchCV ha un vantaggio in più: al posto di liste puoi passare distribuzioni, e per iperparametri come C e gamma — che vivono su scale che spaziano da 0.001 a 1000 — la distribuzione giusta è la log-uniforme:
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import loguniform

param_dist = {
    "svm__C": loguniform(1e-2, 1e3),      # campiona sulla scala logaritmica
    "svm__gamma": loguniform(1e-4, 1e1),
    "svm__kernel": ["rbf", "linear"],
}

rand = RandomizedSearchCV(
    pipe, param_dist,
    n_iter=32,          # STESSO budget della grid search di prima
    cv=5, scoring="accuracy", n_jobs=-1, random_state=42,
)
rand.fit(X_train, y_train)

print("Migliore combinazione:", rand.best_params_)
print(f"Accuratezza in cross-validation: {rand.best_score_:.3f}")
print(f"Accuratezza sul test: {rand.score(X_test, y_test):.3f}")
Perché la scala logaritmica? Pensa al volume di uno stereo: la differenza tra 1 e 2 si sente eccome, quella tra 91 e 92 no. Gli iperparametri moltiplicativi funzionano così: campionare uniformemente tra 0.01 e 1000 significherebbe sprecare quasi tutti i tentativi sopra 100. loguniform distribuisce i tentativi equamente tra gli ordini di grandezza. E il parametro n_iter è la vera libertà del metodo: il budget lo decidi tu, indipendentemente da quanti iperparametri esplori.
Con 16 prove, la griglia esplora solo 4 valori distinti della dimensione che conta davvero (striscia ocra); i punti casuali ne esplorano 16. È l’argomento di Bergstra e Bengio in un’immagine.
Leggere i risultati come un detective
Il campo cv_results_ contiene l’intero verbale della ricerca, e vale la pena guardarlo invece di fidarsi ciecamente di best_params_:
import pandas as pd

risultati = pd.DataFrame(rand.cv_results_)
colonne = ["param_svm__C", "param_svm__gamma", "param_svm__kernel",
           "mean_test_score", "std_test_score", "rank_test_score"]
print(risultati[colonne].sort_values("rank_test_score").head(8))
Due controlli che faccio sempre. Primo: guarda la std_test_score — se il «migliore» vince di 0.002 con una deviazione standard di 0.015, la differenza è rumore, e tra due combinazioni equivalenti scegli la più semplice. Secondo: se il valore migliore di un iperparametro sta sul bordo dell’intervallo che hai definito (ad esempio C=1000 quando il tuo massimo era 1000), l’ottimo probabilmente è fuori: allarga l’intervallo e rilancia.
Onestà: quando tutto questo non serve
Il tuning degli iperparametri è l’ultimo 5% del lavoro, non il primo 95%. Se il tuo modello ha un’accuratezza del 70% e ti serve il 90%, nessuna grid search ti ci porterà: il salto lo fanno dati migliori, feature migliori o un modello di famiglia diversa. Cerca gli iperparametri solo quando la pipeline è già solida e vuoi spremere gli ultimi punti percentuali. E su dataset piccoli con modelli veloci, i default di scikit-learn — scelti con cura da persone che hanno visto migliaia di dataset — sono spesso a un soffio dall’ottimo. Infine: se il budget è grande e gli iperparametri tanti, esistono metodi più furbi di entrambi (ottimizzazione bayesiana con Optuna, successive halving con HalvingRandomSearchCV), che spendono i tentativi dove i risultati precedenti suggeriscono di guardare. Ma nella pratica quotidiana, una random search con un budget onesto e distribuzioni log-uniformi è dura da battere.
Prova tu
Prendi il dataset load_wine di scikit-learn e un RandomForestClassifier. Definisci una distribuzione per n_estimators (da 50 a 500), max_depth (da 2 a 20) e min_samples_leaf (da 1 a 10) usando scipy.stats.randint, e lancia una RandomizedSearchCV con n_iter=25. Poi rispondi a due domande: quanto guadagni rispetto al modello con i default? E il miglior valore trovato tocca il bordo di qualche intervallo? Se sì, allargalo e osserva se cambia qualcosa.
Per approfondire: il paper che ha cambiato le abitudini di tutti è Random Search for Hyper-Parameter Optimization di James Bergstra e Yoshua Bengio (JMLR, 2012) — sorprendentemente leggibile. E la guida ufficiale di scikit-learn, sezione Tuning the hyper-parameters of an estimator, copre anche i metodi a dimezzamento successivo che qui abbiamo solo nominato.
I commenti sono riservati agli iscritti.
Accedi per commentare