Il tuo modello si ferma al 78% di accuratezza e tu vorresti di più. Che fai? Raccogli altri dati? Passi a un modello più potente? Aggiungi regolarizzazione? Ognuna di queste strade costa ore o giorni — e solo una è quella giusta. Procedere per tentativi è come prendere un antibiotico «per vedere se passa» senza sapere che malattia hai. La learning curve è l’esame diagnostico che ti dice di cosa soffre il modello prima di scegliere la cura. In questo tutorial impari a produrla con scikit-learn e, soprattutto, a leggerla.
L’idea: addestrare lo stesso modello con sempre più dati
Una learning curve risponde a una domanda semplice: come cambia la performance del modello man mano che gli do più esempi di addestramento? Si costruisce così: addestri il modello con il 10% del train set e misuri due punteggi, uno sugli stessi dati di addestramento e uno su dati di validazione mai visti. Poi ripeti con il 30%, il 50%, fino al 100%. Ne escono due curve — se non ricordi cos’è la validazione, ti basta sapere che è una porzione di dati tenuta da parte per simulare l’esame su esempi nuovi, come le prove d’esame degli anni passati che non hai usato per studiare.
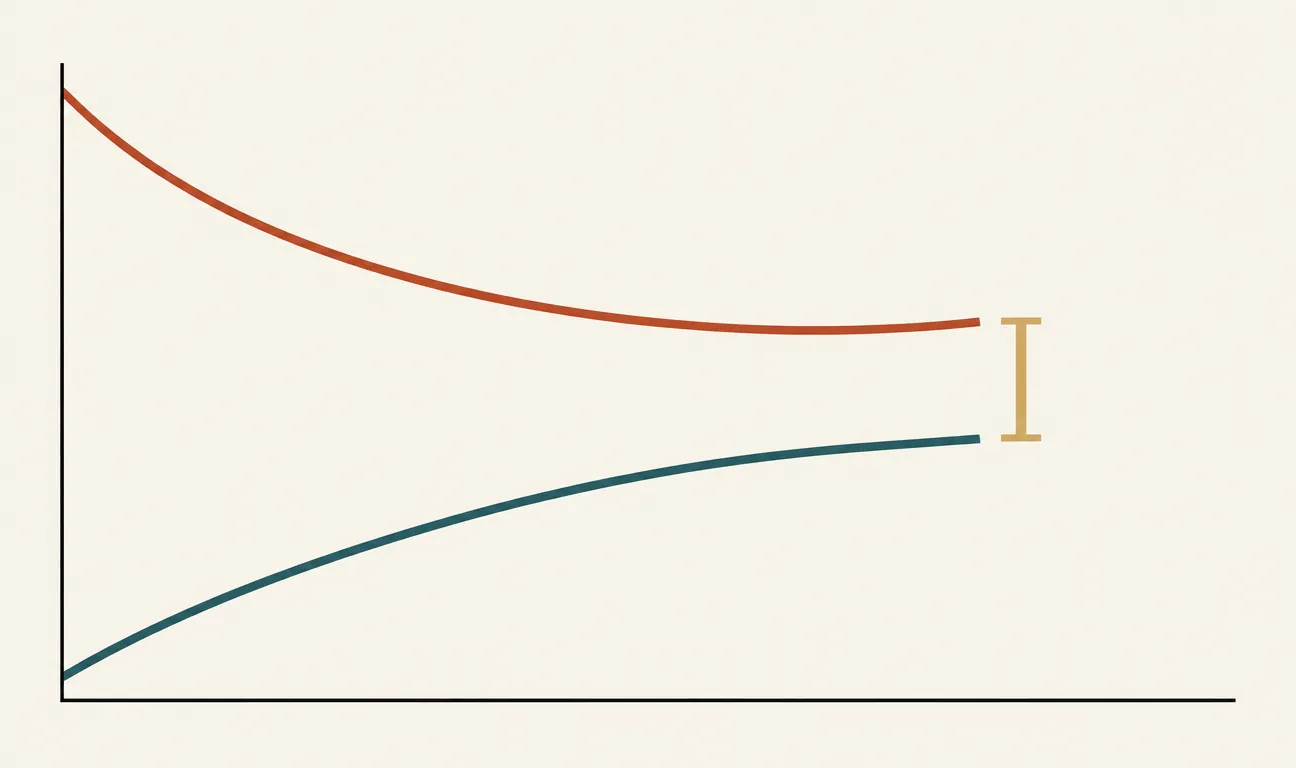
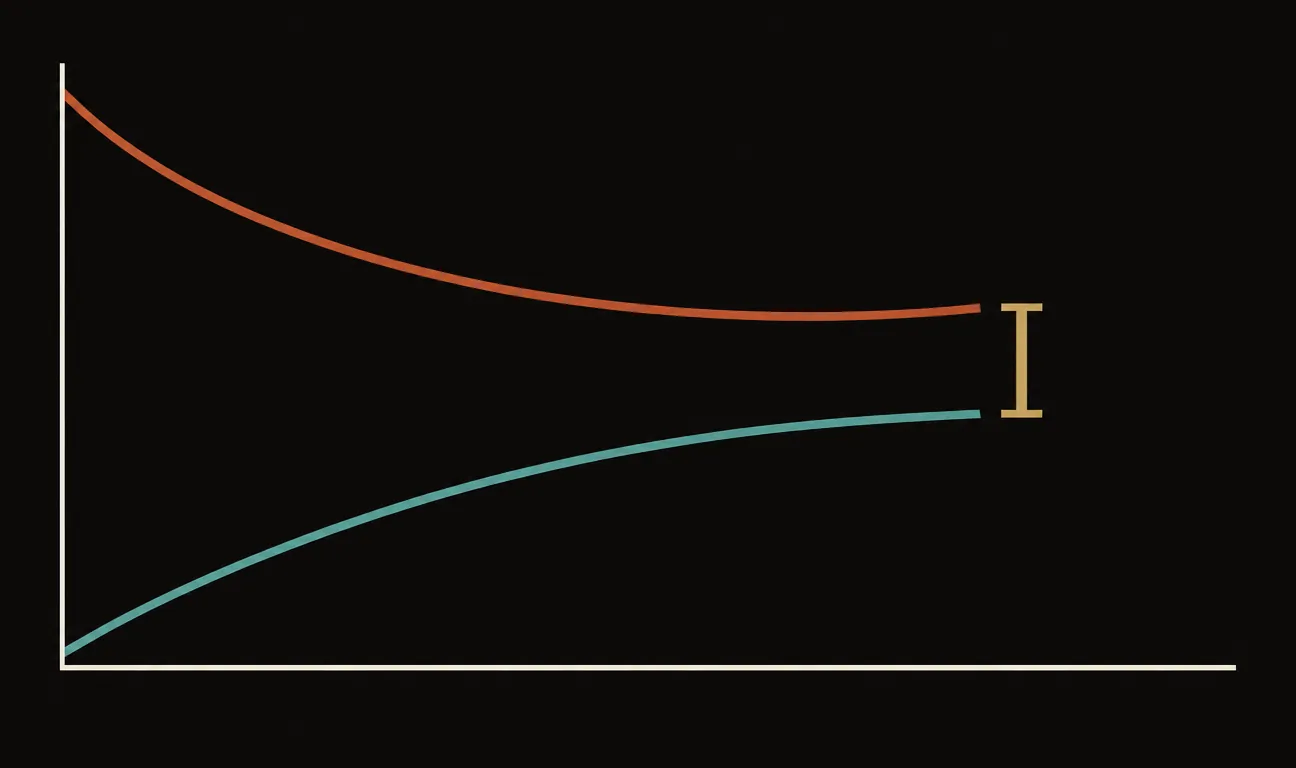
Le due curve hanno caratteri opposti. Quella di train parte altissima: con dieci esempi, quasi qualunque modello li impara a memoria. Poi scende, perché con mille esempi memorizzare non basta più. Quella di validazione parte bassa e sale: più esempi vede il modello, meglio generalizza. La diagnosi sta tutta in dove le due curve si incontrano — o non si incontrano.
# ambiente 2026: Python 3.12 + uv, editor VS Code o PyCharm
# uv venv .venv && source .venv/bin/activate
# uv pip install scikit-learn matplotlib
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

X, y = load_digits(return_X_y=True)  # 1797 cifre scritte a mano, 8x8 pixel

pipe = make_pipeline(StandardScaler(), LogisticRegression(max_iter=5000))

# learning_curve fa tutto lui: 5 taglie di train x 5 fold di cross-validation
sizes, train_scores, val_scores = learning_curve(
    pipe, X, y,
    train_sizes=np.linspace(0.1, 1.0, 8),  # dal 10% al 100% del train
    cv=5, n_jobs=-1, shuffle=True, random_state=42,
)

train_mean = train_scores.mean(axis=1)
val_mean = val_scores.mean(axis=1)
val_std = val_scores.std(axis=1)

plt.plot(sizes, train_mean, "o-", label="Train")
plt.plot(sizes, val_mean, "s-", label="Validazione")
plt.fill_between(sizes, val_mean - val_std, val_mean + val_std, alpha=0.2)
plt.xlabel("Esempi di addestramento")
plt.ylabel("Accuratezza")
plt.legend(); plt.grid(True); plt.show()

for n, tr, vl in zip(sizes, train_mean, val_mean):
    print(f"{n:5d} esempi -> train {tr:.3f} | validazione {vl:.3f}")
Nota il parametro cv=5: per ogni taglia di train la misura viene ripetuta su 5 fold e mediata, così la curva non balla per il caso di una singola divisione. E nota che passiamo una pipeline con lo scaler dentro: il preprocessing viene ri-fittato in ogni fold, senza contaminare la validazione.
Diagnosi 1 — le curve convergono in basso: high bias
Primo quadro clinico: le due curve si avvicinano presto e si appiattiscono entrambe su un punteggio deludente. Train al 75%, validazione al 74%, e da metà grafico in poi non si muove più niente. Questo è high bias, cioè underfitting: il modello è troppo semplice per il problema. È lo studente che affronta gli integrali contando sulle dita: puoi dargli mille esercizi in più, il metodo stesso non è all’altezza, e infatti sbaglia anche gli esercizi su cui si è allenato.
La conseguenza pratica è controintuitiva e preziosissima: raccogliere altri dati qui non serve a nulla. La curva di validazione ha già smesso di salire. Le cure giuste sono altre: un modello più espressivo (da lineare a random forest o gradient boosting), feature migliori (interazioni, trasformazioni non lineari), meno regolarizzazione.
Diagnosi 2 — le curve restano lontane: high variance
Secondo quadro: la curva di train resta altissima (98-100%) mentre quella di validazione arranca molto più in basso, e tra le due rimane un divario ampio. Questo è high variance, cioè overfitting: il modello sta imparando a memoria il train invece di estrarre regole generali. È lo studente che memorizza le soluzioni delle prove degli anni scorsi parola per parola: su quelle è perfetto, ma alla prima domanda riformulata crolla.
Qui la ricetta si ribalta: più dati aiutano davvero — se la curva di validazione sta ancora salendo quando i dati finiscono, è il segnale che con altri esempi continuerebbe a migliorare. In alternativa: più regolarizzazione, un modello più semplice, meno feature. Guarda la differenza dal vivo con un albero di decisione senza limiti di profondità:
from sklearn.tree import DecisionTreeClassifier

albero = DecisionTreeClassifier(random_state=42)  # nessun limite: memorizza
sizes, tr, vl = learning_curve(
    albero, X, y, train_sizes=np.linspace(0.1, 1.0, 8),
    cv=5, n_jobs=-1, shuffle=True, random_state=42,
)
print("Albero senza potatura:")
print(f"  train {tr.mean(axis=1)[-1]:.3f} | validazione {vl.mean(axis=1)[-1]:.3f}")
# train ~1.000, validazione ~0.79: il divario e' la firma dell'overfitting

albero_potato = DecisionTreeClassifier(max_depth=8, min_samples_leaf=5,
                                       random_state=42)
sizes, tr, vl = learning_curve(
    albero_potato, X, y, train_sizes=np.linspace(0.1, 1.0, 8),
    cv=5, n_jobs=-1, shuffle=True, random_state=42,
)
print("Albero potato (regolarizzato):")
print(f"  train {tr.mean(axis=1)[-1]:.3f} | validazione {vl.mean(axis=1)[-1]:.3f}")
Più dati curano solo la varianza, mai il bias. La learning curve ti dice quale dei due hai — prima che tu spenda una settimana a raccogliere dati che non serviranno.
A sinistra il quadro high bias: train e validazione convergono presto su un punteggio basso, e aggiungere dati non sposta nulla. A destra il quadro high variance: il train è quasi perfetto ma il divario con la validazione resta ampio — qui più esempi o più regolarizzazione fanno la differenza.
La cugina: validation curve, per un iperparametro alla volta
La learning curve varia la quantità di dati; la sua cugina validation_curve varia invece un iperparametro e ti mostra dove il modello passa da underfitting a overfitting. Insieme sono il kit diagnostico completo:
from sklearn.model_selection import validation_curve

profondita = range(1, 21)
tr, vl = validation_curve(
    DecisionTreeClassifier(random_state=42), X, y,
    param_name="max_depth", param_range=profondita, cv=5, n_jobs=-1,
)
for d, t, v in zip(profondita, tr.mean(axis=1), vl.mean(axis=1)):
    print(f"max_depth={d:2d}: train {t:.3f} | validazione {v:.3f}")
# all'inizio salgono entrambe (bias cala), poi il train continua
# a salire e la validazione si ferma: da li' in poi e' solo varianza
Quando la learning curve non ti serve
Onestà intellettuale: la learning curve costa. Addestra il modello decine di volte (taglie × fold), quindi su un dataset enorme o con un modello lento può richiedere ore — in quei casi falla su un campione, o affidati al confronto train/validazione a taglia piena, che è una diagnosi più grezza ma quasi gratis. E se il tuo modello ha già un punteggio eccellente e stabile, non c’è nulla da diagnosticare: la learning curve è un esame per pazienti con sintomi, non uno screening da fare a tappeto.
Prova tu
Prendi il dataset load_wine e traccia le learning curve di tre modelli: LogisticRegression con regolarizzazione fortissima (C=0.001), la stessa con C=1, e un DecisionTreeClassifier senza limiti. Prima di eseguire, scrivi su un foglio la tua previsione: quale mostrerà high bias, quale high variance, quale un buon equilibrio? Poi verifica. Indovinare la diagnosi prima di vedere il grafico è il modo più rapido per interiorizzare la lettura delle curve.
Per approfondire: la pagina Validation curves and learning curves della documentazione ufficiale, e il capitolo sulla diagnosi bias/varianza di Machine Learning Yearning di Andrew Ng (disponibile gratuitamente online), che dedica alle learning curve alcune delle pagine più chiare mai scritte sull’argomento.
I commenti sono riservati agli iscritti.
Accedi per commentare