Ti è mai capitato? Hai scalato i dati con StandardScaler, addestrato il modello, ottenuto un’accuratezza splendida in cross-validation… e poi in produzione i risultati crollano. Oppure, più banalmente: hai scritto scaler.fit_transform(X_test) invece di scaler.transform(X_test), e il tuo test set ha smesso di essere un vero esame. Sono gli infortuni classici di chi gestisce il preprocessing «a mano», un passaggio alla volta. In questo tutorial vediamo lo strumento che scikit-learn ha inventato apposta per eliminarli: la Pipeline, una catena di trasformazioni che si comporta come un unico stimatore.
Il problema: troppi pezzi da coordinare
Un flusso di machine learning realistico non è mai solo «modello». Prima ci sono i valori mancanti da riempire, le scale da uniformare, magari le categorie da codificare — se non ricordi cos’è lo scaling, ti basta sapere che porta tutte le feature su ordini di grandezza confrontabili, così nessuna domina le altre solo perché misurata in unità più grandi. Ogni passaggio è uno stimatore con il suo fit e il suo transform, e le regole d’oro sono due: si impara solo dal train, e si applica la stessa trasformazione al test.
Finché i passaggi sono uno o due, te la cavi con la disciplina. Ma quando diventano quattro o cinque, gestirli a mano è come preparare un caffè passando manualmente il macinato da un barattolo all’altro: prima o poi rovesci qualcosa. La Pipeline è la macchina del caffè: metti i chicchi da una parte, esce la tazzina dall’altra, e tutti i passaggi intermedi avvengono nell’ordine giusto, sempre.
# ambiente 2026: Python 3.12 + uv, editor VS Code o PyCharm
# uv venv .venv && source .venv/bin/activate && uv pip install scikit-learn
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression

X, y = load_breast_cancer(return_X_y=True)  # incluso in sklearn, zero download
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

pipe = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="median")),   # 1. riempie i mancanti
    ("scaler", StandardScaler()),                    # 2. porta tutto in scala
    ("model", LogisticRegression(max_iter=5000)),    # 3. il predittore, ultimo
])

pipe.fit(X_train, y_train)                 # UN solo fit per tutta la catena
print(f"Accuratezza test: {pipe.score(X_test, y_test):.3f}")  # ~0.98
Nota cosa è successo con quel singolo fit: l’imputer ha imparato le mediane dal train e ha trasformato i dati; il risultato è passato allo scaler, che ha imparato medie e deviazioni e ha trasformato a sua volta; e solo alla fine il modello ha ricevuto dati puliti su cui addestrarsi. Quando poi chiami predict o score sul test, la Pipeline applica automaticamente transform (mai fit!) a ogni passaggio intermedio. La regola «impara dal train, applica al test» è cablata nell’oggetto: non puoi più sbagliarla per distrazione.
Il vero regalo: niente più data leakage
Il data leakage è quando informazioni del test set filtrano nell’addestramento — come uno studente che prepara l’esame avendo sbirciato le domande: il voto sarà ottimo, ma non misura più niente. L’esempio più subdolo è la cross-validation fatta male: se scali tutto il dataset prima di dividerlo in fold, le statistiche di scaling contengono anche i dati che poi userai per validare. L’errore è invisibile, e gonfia i punteggi quel tanto che basta a illuderti.
from sklearn.model_selection import cross_val_score

# SBAGLIATO (leakage): lo scaler vede anche i fold di validazione
# X_scaled = StandardScaler().fit_transform(X)
# cross_val_score(LogisticRegression(max_iter=5000), X_scaled, y, cv=5)

# GIUSTO: la pipeline viene ri-fittata da zero dentro OGNI fold
scores = cross_val_score(pipe, X_train, y_train, cv=5)
print(f"CV: {scores.mean():.3f} ± {scores.std():.3f}")
Passando la Pipeline intera a cross_val_score, scikit-learn la clona e la ri-addestra dentro ciascun fold: imputer e scaler imparano ogni volta solo dalla porzione di train di quel fold. È la garanzia che il punteggio che leggi sia onesto.
Una Pipeline non ti fa risparmiare righe di codice: ti fa risparmiare gli errori che non sapevi di stare commettendo.
Colonne diverse, trattamenti diversi: ColumnTransformer
Nei dati reali le colonne non sono tutte uguali: quelle numeriche vanno scalate, quelle categoriche codificate — se non ricordi il one-hot encoding, ti basta sapere che trasforma una categoria come «Roma/Milano/Napoli» in tre colonne di 0 e 1. Il ColumnTransformer è lo smistatore che manda ogni gruppo di colonne alla sua sotto-catena, come i nastri dell’aeroporto che dirigono le valigie fragili verso un percorso e quelle normali verso un altro, per poi ricongiungerle sullo stesso carrello.
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

df = pd.DataFrame({
    "eta": [25, 32, 47, None, 51, 38],
    "reddito": [28_000, 41_000, 39_000, 52_000, None, 61_000],
    "citta": ["Roma", "Milano", "Roma", "Napoli", "Milano", None],
    "acquista": [0, 1, 0, 1, 1, 1],
})
X, y = df.drop(columns="acquista"), df["acquista"]

num_cols = ["eta", "reddito"]
cat_cols = ["citta"]

preprocess = ColumnTransformer(transformers=[
    ("num", Pipeline([("imp", SimpleImputer(strategy="median")),
                      ("sc", StandardScaler())]), num_cols),
    ("cat", Pipeline([("imp", SimpleImputer(strategy="most_frequent")),
                      ("oh", OneHotEncoder(handle_unknown="ignore"))]), cat_cols),
])

full = Pipeline([("prep", preprocess),
                 ("model", LogisticRegression(max_iter=5000))])
full.fit(X, y)
print(full.predict(pd.DataFrame(
    {"eta": [29], "reddito": [35_000], "citta": ["Torino"]}
)))  # città mai vista: handle_unknown="ignore" evita il crash
Osserva l’ultima riga: «Torino» non esisteva nel train, ma la pipeline non esplode, perché l’encoder è stato configurato per ignorare le categorie ignote. Sono questi dettagli, dichiarati una volta sola dentro la catena, che in produzione fanno la differenza tra un servizio robusto e una notte di debug.
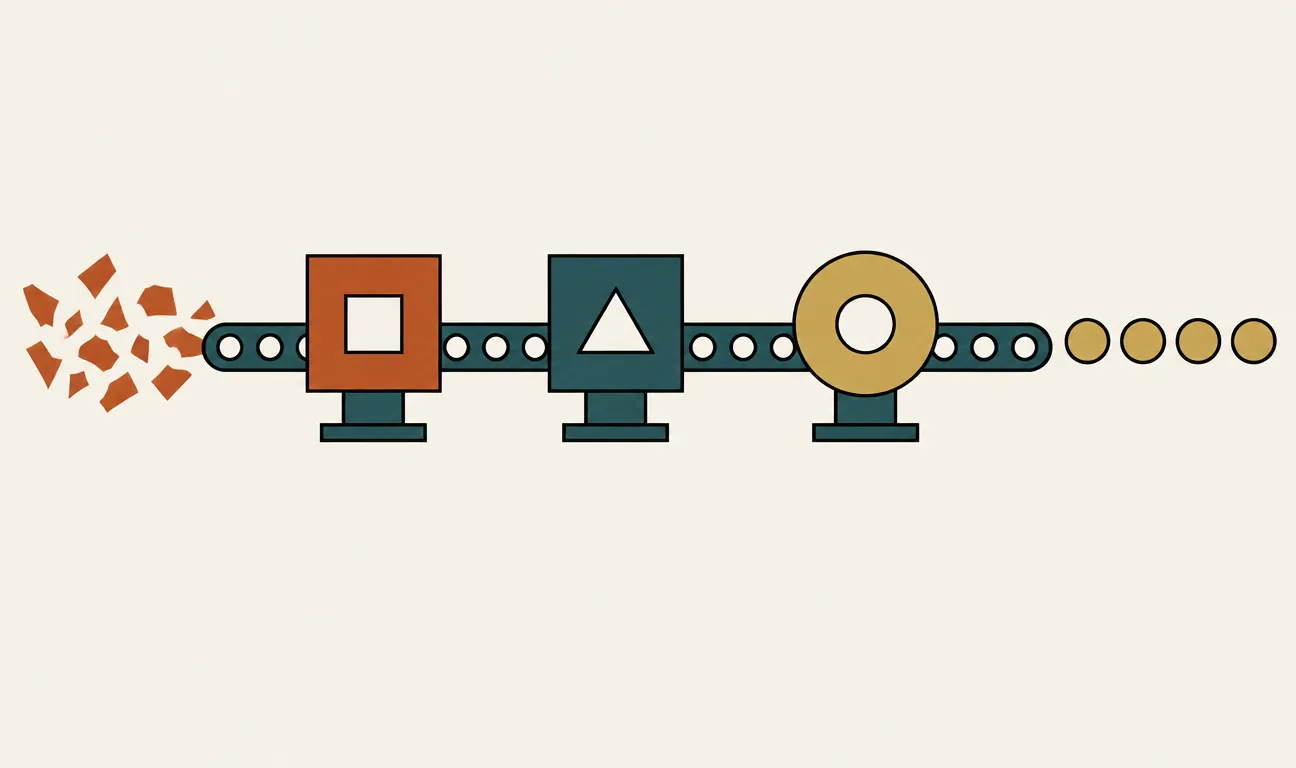
La Pipeline incatena i trasformatori e chiude con il predittore: sul train ogni anello impara e passa i dati al successivo, sul test ogni anello si limita ad applicare ciò che ha imparato. Dall’esterno resta un unico stimatore con fit e predict.
Ottimizzare tutta la catena con la grid search
Siccome la Pipeline è uno stimatore come gli altri, puoi passarla a GridSearchCV e ottimizzare in un colpo solo gli iperparametri di qualsiasi anello, dal preprocessing al modello, con la sintassi nome_step__parametro (doppio underscore):
from sklearn.model_selection import GridSearchCV

griglia = {
    "imputer__strategy": ["mean", "median"],
    "model__C": [0.01, 0.1, 1, 10],
}
ricerca = GridSearchCV(pipe, griglia, cv=5, n_jobs=-1)
ricerca.fit(X_train, y_train)
print(ricerca.best_params_)
print(f"Miglior CV: {ricerca.best_score_:.3f}")
Ci pensi? Stai facendo tuning anche della strategia di imputazione, e ogni combinazione viene valutata senza leakage perché l’intera catena si ri-addestra in ogni fold. A mano sarebbe un piatto di spaghetti di cicli annidati.
Quando la Pipeline non serve
Onestà intellettuale: se stai esplorando i dati in un notebook, guardando gli istogrammi e provando trasformazioni una per volta, la Pipeline può rallentarti — nasconde i passaggi intermedi proprio quando vorresti ispezionarli (anche se pipe.named_steps["scaler"] ti riapre lo sportello). E se il tuo preprocessing vive fuori da Python, per esempio in SQL su un data warehouse, incatenarlo in scikit-learn non ha senso. La regola pratica: esplora libero, ma nel momento in cui compare una cross-validation o la parola «produzione», metti tutto in Pipeline.
Prova tu
Prendi il dataset Titanic (lo trovi con fetch_openml("titanic", version=1, as_frame=True)): ha colonne numeriche con mancanti (age) e categoriche (sex, embarked). Costruisci un ColumnTransformer con due sotto-pipeline come quello visto sopra, chiudi con un classificatore a tua scelta e valuta con cross_val_score. Poi prova a ottimizzare con GridSearchCV almeno un iperparametro del preprocessing e uno del modello: quale dei due sposta di più il punteggio?
Per approfondire: la pagina Pipelines and composite estimators della documentazione ufficiale, e il capitolo 2 di Hands-On Machine Learning di Aurélien Géron (3ª edizione, O’Reilly), dove una pipeline completa accompagna un progetto end-to-end.
I commenti sono riservati agli iscritti.
Accedi per commentare