
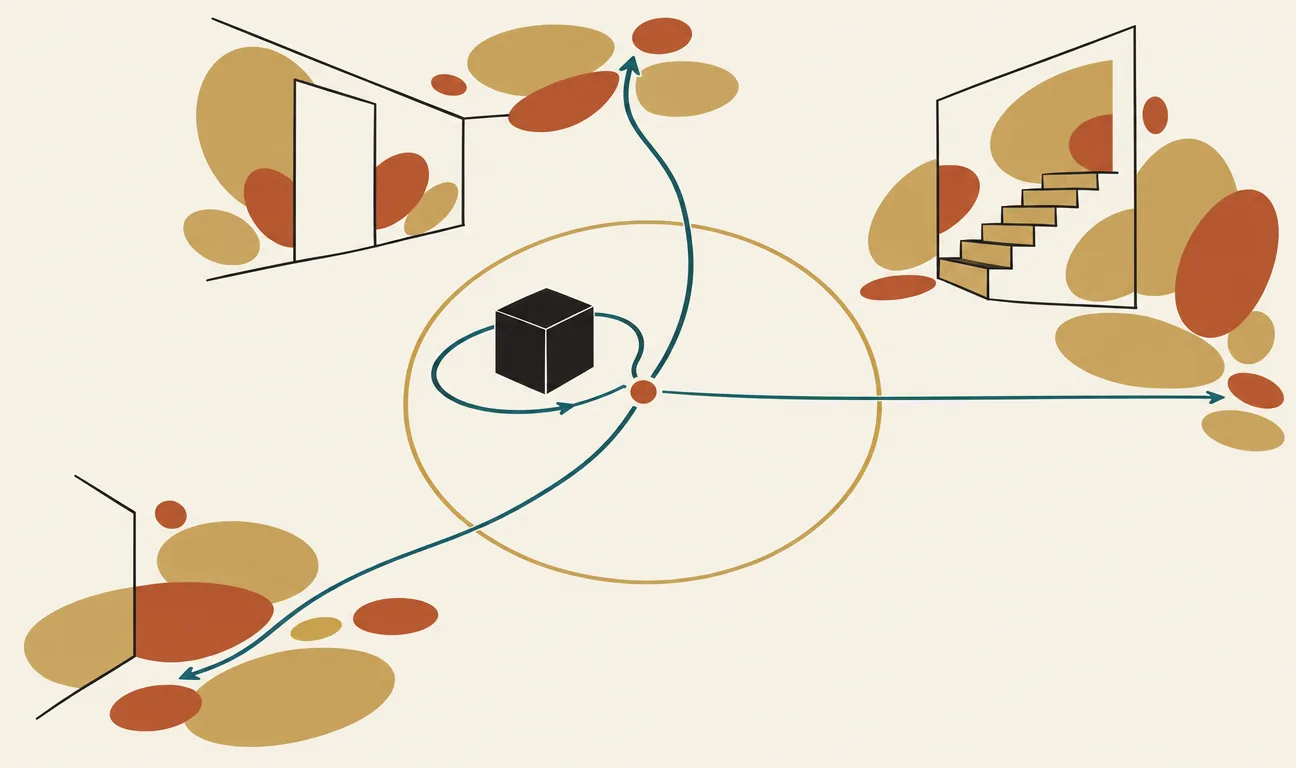
Chi ha fatto un sopralluogo con un geometra conosce il metodo. Non si comincia prendendo misure a caso: ci si mette al centro della stanza e si guarda tutto attorno, poi si decide il giro da fare (lungo le pareti, dietro al divano, sotto la scala), si scattano le foto lungo quel giro, e solo alla fine, in studio, si rimette insieme la pianta. Il sopralluogo è la parte che si vede; il lavoro vero è sapere dove camminare e come far combaciare le foto.
È, quasi alla lettera, lo schema di HY-World 2.0: A Multi-Modal World Model for Reconstructing, Generating, and Simulating 3D Worlds, il rapporto tecnico che il gruppo Hunyuan di Tencent ha depositato su arXiv il 15 aprile 2026 (2604.14268), con Chunchao Guo e Tengfei Wang come responsabili del progetto. Solo che qui la stanza non esiste: la si inventa a partire da una frase o da una foto, e poi la si trasforma in una scena 3D in cui un personaggio può muoversi, salire le scale e sbattere contro i muri. Ciò che lo distingue sta in una riga dell’abstract: pesi, codice e dettagli tecnici sono rilasciati tutti.
Due mestieri che di solito non si parlano
Il campo dei mondi 3D sintetici, osservano gli autori, è diviso in due. Da una parte i metodi generativi: partono da poco (un testo, un’immagine) e inventano una scena esplorabile, ma la geometria che producono è approssimativa. Dall’altra i metodi di ricostruzione: partono da molte foto o da un video e recuperano profondità, normali, nuvole di punti con precisione, ma non sanno immaginare ciò che non è stato ripreso. Fra i prodotti chiusi c’è chi ha già unito le due cose (il riferimento dichiarato è Marble di World Labs), mentre nel mondo aperto, secondo il rapporto, mancava un sistema che lo facesse.
HY-World 2.0 prova a colmare quel vuoto cambiando comportamento secondo l’ingresso. Con testo o una foto sola genera; con più viste o un video ricostruisce. E la ricostruzione non è un modulo a parte: è lo stesso modello, WorldMirror 2.0, che nella catena generativa serve a trasformare in geometria le immagini appena inventate. È il seguito di HY-World 1.0, che generava mondi 3D offline, e di HY-World 1.5, che puntava invece al video interattivo in tempo reale; la versione 2.0 torna al 3D esplicito, compatibile con le pipeline grafiche standard, ma usa i modelli video per allargare la scena.
«World model» qui vuol dire soprattutto un generatore di ambienti 3D, non il modello interno con cui un agente prevede le conseguenze delle proprie azioni. Le diverse accezioni del termine, e il dibattito su che cosa debbano saper fare, sono nel libro.
La catena in quattro stadi
Il primo stadio, HY-Pano 2.0, produce un panorama a 360° dall’ingresso. La novità rispetto alla versione precedente è che non serve più conoscere la focale della foto di partenza: la versione 1.0 proiettava l’immagine sul panorama con una trasformazione geometrica esplicita, che richiede i parametri della camera e sbaglia quando mancano. Ora l’immagine e il panorama da generare sono messi nella stessa sequenza di token di un diffusion transformer multimodale, e la corrispondenza fra i due la impara l’attenzione. Per evitare la cucitura visibile fra il bordo sinistro e quello destro del panorama, il latente viene imbottito in modo circolare durante la generazione e i pixel dei bordi vengono poi mescolati linearmente.
Il secondo stadio, WorldNav, è il giro del geometra. Dal panorama si ricavano una nuvola di punti, una mesh grossolana, le maschere degli oggetti (Qwen3-VL li nomina, SAM3 li ritaglia) e una mappa delle zone calpestabili. Poi WorldNav traccia cinque famiglie di percorsi di camera: orbite regolari attorno a tre punti del panorama, giri attorno agli oggetti principali, percorsi mirati ai buchi della ricostruzione, passeggiate verso i punti più lontani raggiungibili, e versioni rialzate a volo d’uccello. La pianificazione vera e propria non impara nulla: sono euristiche, ray-casting contro gli ostacoli e cammini minimi di Dijkstra.
Il terzo stadio, WorldStereo 2.0, cammina lungo quei percorsi e genera le viste che il panorama non contiene. È un modello di diffusione video addomesticato con due scelte. La prima: invece di generare video continui, che il VAE comprime anche nel tempo producendo sbavature quando la camera si muove in fretta, genera solo fotogrammi chiave distanziati, compressi uno per uno. La seconda: una memoria doppia per non contraddirsi fra un percorso e l’altro. Da una parte una nuvola di punti globale che fissa la struttura grossolana della scena, dall’altra un archivio delle viste già generate da cui si recuperano le più pertinenti, affiancate alla vista da produrre perché il modello ne copi i dettagli. Una distillazione finale porta la generazione a quattro passi.
Il quarto stadio compone il mondo: WorldMirror 2.0 stima profondità e normali dei fotogrammi generati, le profondità vengono allineate alla nuvola del panorama con una regressione lineare robusta (una scala e uno spostamento per fotogramma, stimati con RANSAC), e il tutto inizializza una scena in Gaussian splatting, da cui si estrae anche una mesh per le collisioni.
Il Gaussian splatting rappresenta una scena come una nuvola di ellissoidi colorati e semitrasparenti, ottimizzati finché le loro proiezioni non riproducono le foto. Come si costruisce, e in che cosa differisce dai NeRF, è spiegato nel libro.
WorldMirror 2.0 e il problema della risoluzione
La parte del rapporto che si regge meglio da sola è il modello di ricostruzione, che prende una serie di immagini (nei test fino a 256, con camere, focali e profondità facoltative) e restituisce in un passaggio solo nuvole di punti, profondità, normali, camere e gaussiane. Dei tre difetti della versione 1.0 elencati nel rapporto, il più netto è che funzionava male a risoluzioni diverse da quella di addestramento. La causa è la codifica posizionale. Ogni pezzetto dell’immagine riceveva come coordinate il proprio indice intero di riga e colonna; se in addestramento la griglia arrivava a 8 e al test a 16, gli indici da 8 a 15 non erano mai stati visti. La correzione, presa da DINOv3, è normalizzare:
$$\hat x_i = \frac{2i+1}{H_p} – 1, \qquad \hat y_j = \frac{2j+1}{W_p} – 1$$
dove $H_p$ e $W_p$ sono le dimensioni della griglia di patch. Qualunque sia la risoluzione, le coordinate cadono in $[-1, 1]$: un’immagine più grande è solo un campionamento più fitto dello stesso intervallo, e l’estrapolazione diventa interpolazione.
I numeri mostrano che la correzione conta. Nella stima delle camere su RealEstate10K (AUC@30) la versione 1.0 faceva 86,13 alla risoluzione nativa e crollava a 66,29 ad alta risoluzione (756×1036); la 2.0, ad alta risoluzione, fa 86,89. Sull’accuratezza delle nuvole di punti in 7-Scenes l’errore medio ad alta risoluzione passa da 0,079 a 0,037. Nella sintesi di nuove viste la 1.0 scendeva da 21,34 a 17,78 dB di PSNR; la 2.0 resta attorno ai 20 dB a tutte le risoluzioni, oltre un decibel sotto il picco della 1.0 ma senza il crollo. Precisione mista, parallelismo di sequenza e pesi ripartiti fra le schede portano 128 viste da 18 a 5,6 secondi su quattro GPU H20; la sola precisione mista rende possibili 256 viste, che in FP32 su una GPU esaurivano la memoria.
I risultati della generazione
Qui i numeri sono più sparsi. Sulla ricostruzione da una sola vista, misurata contro nuvole di punti ricostruite dalle foto reali di Tanks-and-Temples e MipNeRF360, lungo percorsi di camera che gli autori hanno reso più difficili di quelli originali, WorldStereo 2.0 supera il miglior concorrente su ciascun insieme; la versione distillata a quattro passi fa anzi meglio sul primo e resta vicina sul secondo.
| Metodo | Tanks-and-Temples | MipNeRF360 |
|---|---|---|
| WorldStereo 2.0 | 41,43 | 51,27 |
| WorldStereo 2.0 distillato, quattro passi | 43,16 | 50,52 |
| Miglior concorrente | 36,73 SEVA | 42,60 FlashWorld |
Sul controllo della camera l’errore di rotazione scende a 0,492 contro 0,762 del predecessore. Nella composizione, la configurazione completa (sottocampionamento, niente gaussiane nuove nel cielo, potatura probabilistica MaskGaussian) usa il 77% di gaussiane in meno rispetto a una base di 6 milioni, perdendo 0,15 dB di PSNR, e l’allineamento lineare delle profondità impiega meno di due minuti contro le circa cinque ore per scena dell’alternativa basata su ICP (video2world), con qualità che gli autori giudicano paragonabile (su figure, non su una metrica).
Per i panorami, HY-Pano 2.0 è primo su tutte e cinque le metriche nel passaggio da immagine a panorama, mentre da testo lo è su tre metriche su cinque: sulla qualità percepita della proiezione equirettangolare e sull’estetica delle viste prospettiche la versione 1.0 resta davanti di poco, e sulla prima anche DiT360.
I limiti
Il primo riguarda la frase più citata dell’abstract, quella secondo cui i risultati sono «comparabili» a Marble. Il confronto con il prodotto di World Labs (versione 1.0, al 30 marzo 2026) è interamente qualitativo: due figure con viste affiancate, nessun numero. Può darsi che la conclusione sia giusta, ma il rapporto non offre modo di verificarla.
Il secondo è la natura delle metriche. Qualità ed estetica dei panorami le giudica un modello (Q-Align, tarato su voti umani), non delle persone; lo studio con utenti che guida le scelte sul controllo della camera è citato senza dire quanti partecipanti e quante valutazioni. L’ablazione sul Gaussian splatting è una media su dieci scene. E i dati di addestramento sono descritti come «una vasta raccolta» di panorami reali e scene sintetiche in Unreal Engine, senza cifre; non è nominato nemmeno il modello video di partenza su cui è costruito WorldStereo 2.0.
Il terzo è un’assenza. L’abstract presenta WorldLens, una piattaforma di rendering con illuminazione automatica, collisioni e personaggi, ma nel corpo del rapporto non ha una sezione: compare di nuovo solo nelle conclusioni. Manca anche una sezione sui limiti. E il testo parla di «soli 10 minuti» per generare un mondo, mentre la tabella dei tempi somma 712 secondi, quasi dodici, su GPU H20 di cui non si dice il numero.
Perché conta adesso
La corsa ai «world model» ha preso due strade. Una, quella di Genie 3 e dei modelli video interattivi, genera il mondo fotogramma per fotogramma mentre lo si attraversa, e il mondo esiste solo finché il modello continua a disegnarlo. L’altra produce un oggetto 3D che si salva, si apre in un motore grafico, si usa per simulare un robot o costruire un livello di un videogioco. HY-World 2.0 sta nella seconda, e la sua lezione è che i modelli video più potenti servono anche lì, come fonte di viste da trasformare in geometria. Il valore principale del rapporto non è un singolo numero ma il fatto che l’intera catena (panorami, percorsi, espansione, ricostruzione) sia aperta e riproducibile, in un settore dove il riferimento dichiarato è un prodotto chiuso. Resta da vedere, con misure e non con figure, come regga davvero il confronto.
Codice e pesi sono su github.com/Tencent-Hunyuan/HY-World-2.0.
I commenti sono riservati agli iscritti.
Accedi per commentare