
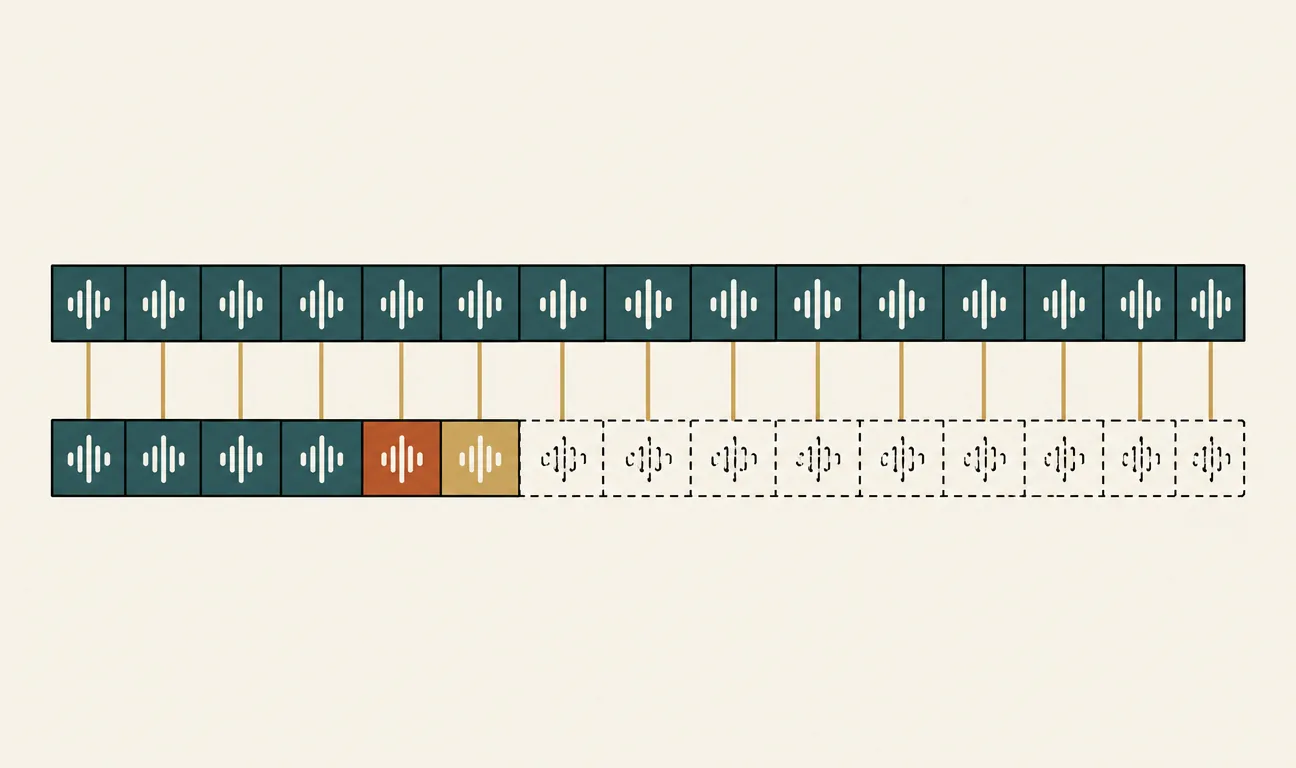
Chi ha lavorato ai sottotitoli di una televisione conosce due mestieri che sembrano lo stesso e non lo sono. C’è chi sottotitola la diretta: scrive mentre il politico parla, sente mezza frase e deve già decidere se quel «però» apre un’obiezione o chiude una concessione. E c’è chi prepara i sottotitoli della replica: ha la registrazione intera, può tornare indietro, ascoltare la fine della frase prima di scriverne l’inizio. Per anni le redazioni hanno pagato due persone diverse. Sarebbe più comodo averne una sola, brava in entrambi i ruoli, ma chi si abitua a riascoltare tende a scrivere male in diretta, e viceversa.
Con i riconoscitori vocali succede la stessa cosa, ed è il problema affrontato da Reducing the Offline-Streaming Gap for Unified ASR Transducer with Consistency Regularization, uscito su arXiv il 21 aprile 2026 (2604.19079). Lo firmano sei ricercatori di NVIDIA: Andrei Andrusenko e Vladimir Bataev a pari merito, Lilit Grigoryan e Nune Tadevosyan dalla sede armena, Vitaly Lavrukhin e Boris Ginsburg da quella statunitense. Il lavoro è costruito su NeMo, il toolkit di NVIDIA, e il paper arriva con un checkpoint già pubblico su Hugging Face, nvidia/parakeet-unified-en-0.6b.
Il costo di avere due modelli
Chi mette in servizio un sistema di trascrizione di solito ne vuole due: uno offline, che legge il file intero e punta alla massima precisione, e uno in streaming, che trascrive mentre l’audio arriva, con un ritardo di frazioni di secondo. Due modelli significano due addestramenti, due validazioni, due catene di deploy. Unificarli è un obiettivo vecchio, e il paper parte da un’architettura che sembra fatta apposta: il Transducer (RNNT), il cui decodificatore dipende solo dai token già emessi e quindi si presta a lavorare a pezzi.
Che cosa sono CTC e Transducer, e perché il secondo si presta alla trascrizione in diretta: le famiglie di riconoscitori sono messe a confronto nel libro.
Il guaio sta nell’encoder. Quello più diffuso, il Conformer, ha due componenti che in addestramento guardano volentieri al futuro: l’attenzione, che vede tutta la sequenza, e le convoluzioni, che leggono anche i fotogrammi successivi. In diretta quel futuro non c’è. Le soluzioni classiche, attenzione limitata a blocchi e convoluzioni causali, funzionano anche con ritardi minimi, ma costano precisione. E più il ritardo concesso si stringe, più le due modalità tirano i pesi condivisi in direzioni opposte: sotto il mezzo secondo, dicono gli autori, i modelli unificati tendono a crollare in una delle due.
Tre finestre sull’audio
La prima metà della proposta è di mestiere, e mette insieme idee già note. In streaming l’attenzione è vincolata da una maschera in tre parti: un contesto sinistro $L$, il blocco corrente $C$ e un contesto destro $R$, cioè qualche fotogramma di futuro che il sistema aspetta prima di pronunciarsi. Il ritardo teorico nel caso peggiore è $C + R$. Dopo il sottocampionamento iniziale un fotogramma vale 80 millisecondi; il contesto sinistro è fisso a 70 fotogrammi (5,6 secondi), mentre $C$ e $R$ vengono estratti a ogni passo da due elenchi, così che lo stesso modello impari a lavorare con molti ritardi diversi. Le convoluzioni diventano dinamiche a blocchi (DCConv, da un lavoro del 2023): in streaming lo stato nascosto viene ritagliato secondo il blocco corrente, con gli stessi parametri usati offline.
Poi c’è la scelta di come alternare le modalità. Nel regime a modalità singola ogni passo di addestramento ne estrae una a caso. Nel regime duale ogni lotto passa due volte, offline e in streaming, e le due perdite si sommano con un peso $\alpha$. Il duale costa il doppio per passo; per confrontarlo alla pari gli autori dimezzano il lotto.
Chiedere alle due modalità di essere d’accordo
Maschere e convoluzioni riducono il divario, ma non bastano sotto il mezzo secondo. L’ingrediente nuovo è la regolarizzazione di consistenza fra modalità, che gli autori chiamano MCR-RNNT: oltre a trascrivere bene ciascuna per conto suo, le due passate dello stesso audio devono produrre distribuzioni di probabilità simili. Il confronto avviene sull’uscita completa del Transducer, la griglia che per ogni fotogramma $t$ e ogni posizione del testo $u$ assegna una probabilità a ciascuno dei $V$ token del vocabolario. In ogni cella, con $p$ la distribuzione offline e $q$ quella in streaming, la versione simmetrica è
$$\mathcal{L}_{\mathrm{MCR\text{-}Sym}} = \frac{1}{2}\big[\mathrm{KL}(p \,\|\, q) + \mathrm{KL}(q \,\|\, p)\big] = \frac{1}{2}\sum_{v=1}^{V} (p_v – q_v)(\log p_v – \log q_v),$$
normalizzata sulle celle valide della griglia. La perdita complessiva dell’addestramento duale diventa
$$\mathcal{L}_{\mathrm{DM}} = \alpha\,\mathcal{L}^{\mathrm{off}}_{\mathrm{RNNT}} + (1-\alpha)\,\mathcal{L}^{\mathrm{str}}_{\mathrm{RNNT}} + \lambda\,\mathcal{L}_{\mathrm{MCR}},$$
dove $\lambda$ regola quanto pesa l’accordo.
La divergenza di Kullback-Leibler fra la distribuzione di un «maestro» e quella di un «allievo» è lo stesso strumento della distillazione: che cosa misura, e perché non è simmetrica, è spiegato nel libro.
Due dettagli rendono la proposta più interessante della formula. Il primo è un tentativo fallito, raccontato con onestà: gli autori hanno provato prima a estendere CR-CTC, applicando la consistenza a una testa CTC ausiliaria. L’offline restava buono, lo streaming del Transducer peggiorava sempre. La loro spiegazione è che CTC premia previsioni sicure fotogramma per fotogramma e spinge l’encoder verso allineamenti comodi offline ma inadatti a chi ha poco futuro. Da qui la scelta di lavorare sulla griglia completa del Transducer: un lavoro precedente, TCR, applicava la consistenza a una griglia potata, ma fra offline e streaming gli allineamenti possono divergere parecchio.
Il secondo è ingegneristico. La griglia ha dimensioni $T \times (U+1) \times V$ per ogni esempio del lotto, e tenerne in memoria i log-softmax sarebbe proibitivo. La perdita è quindi scritta come kernel fuso in Triton, che calcola softmax e divergenza al volo e li ricalcola nel passaggio all’indietro, come già fa la perdita RNNT di NeMo. Secondo gli autori il costo in memoria è quasi nullo e quello di calcolo minimo, ma il paper non riporta misure. Non esisteva, precisano, un’implementazione pubblica per questo uso.
I numeri
Il banco di prova principale è un FastConformer-Transducer da 128 milioni di parametri, addestrato su circa 120.000 ore di inglese con trascrizioni normalizzate prese dal dataset pubblico Granary, su 32 GPU A100. La metrica è il tasso di errore sulle parole (WER) medio dell’Open ASR Leaderboard, calcolato su più insiemi di test fra riunioni, conference call finanziarie, talk, audiolibri e discorsi parlamentari.
La tabella del paper racconta bene il dilemma di partenza. Il modello solo offline, appena gli si toglie il futuro, peggiora in fretta: 13,56% con 0,56 secondi di ritardo, 26,51% con 0,40, e con 0,16 non trascrive più. Il modello solo streaming regge fino in fondo, ma sul file intero resta indietro: attenzione a blocchi e convoluzioni causali gli impediscono di sfruttarlo. L’unificazione classica sta nel mezzo e cede presto: a modalità singola fa 10,96% con 0,32 secondi e 17,16% con 0,16; il duale senza consistenza, a parità di calcolo, fa peggio del singolo quasi ovunque.
Con MCR-RNNT il modello unificato, sul file intero, fa praticamente come l’unificato a modalità singola e poco sopra il modello solo offline. In streaming fa 7,47% con 0,56 secondi, 8,24% con 0,32 e 9,04% con 0,24: meglio del modello dedicato allo streaming su tutti i ritardi fino a 0,24 secondi. Solo all’ultimo gradino, 0,16 secondi, il dedicato resta davanti.
| Modello | File intero | 0,16 secondi |
|---|---|---|
| Solo offline | 6,47% | 94,05% non trascrive più |
| Solo streaming | 7,75% | 9,84% |
| Unificato con MCR-RNNT | 6,63% | 10,51% |
Poi la scala: un modello da circa 600 milioni di parametri, addestrato su Granary con punteggiatura e maiuscole, in due versioni. Sul file intero la versione con più contesto destro batte Parakeet-TDT-0.6b-v2, addestrato sullo stesso dataset, e si avvicina a Canary-Qwen-2.5B, un modello solo offline quattro volte più grande.
| Modello | WER |
|---|---|
| Unificato, versione con più contesto destro | 5,76% |
| Unificato, versione con contesti destri più piccoli | 5,91% |
| Parakeet-TDT-0.6b-v2, stesso dataset | 6,04% |
| Canary-Qwen-2.5B, solo offline, quattro volte più grande | 5,63% |
Contro Nemotron-Speech-Streaming, il modello di NVIDIA dedicato alla diretta, la prima versione vince fino a 0,32 secondi (7,72% contro 7,78%) e poi cede. La seconda, addestrata con contesti destri più piccoli, rinuncia a un po’ di offline, batte Nemotron fino a 0,24 secondi e a 0,16 resta poco dietro (8,44% contro 7,92%). Quali contesti destri usino le due versioni, il paper non lo specifica.
Le ablazioni indicano la versione simmetrica come la più equilibrata: usare solo l’offline come maestro fa esplodere lo streaming a 0,32 secondi (15,86%). Il compromesso migliore, secondo gli autori, si ha con $\lambda = 0{,}3$, e per $\alpha$ consigliano di partire da 0,5.
Che cosa resta da verificare
Il ritardo è teorico, la velocità non è misurata. Tutte le latenze della tabella sono la somma $C + R$, non tempi di risposta osservati. E gli autori ammettono che oggi il contesto sinistro viene ricalcolato a ogni blocco, il che rallenta la decodifica: il meccanismo di cache che lo eviterebbe è lavoro futuro. Inoltre, lo mostrano loro stessi, blocchi più piccoli allungano i tempi di decodifica. Per un modello che vuole servire la diretta non è un dettaglio.
Qualche imprecisione nei dettagli. I dati del modello grande sono 280.000 ore nel testo e 240.000 nella tabella; gli insiemi di test sono «otto» ma l’elenco ne nomina sette. Il codice del framework, che l’abstract dà per rilasciato, in nota è «in arrivo»; il checkpoint invece è pubblico. Non ci sono ripetizioni con semi diversi né barre d’errore, e i parametri di $C$ e $R$ vengono da una ricerca iniziale che il paper non documenta.
Solo inglese, solo media. Tutti i risultati sono su una media di benchmark inglesi, senza il dettaglio per dominio (fa eccezione una figura su LibriSpeech), e i confronti esterni sono tutti con modelli della stessa casa. Come si comporti in italiano, o su lingue con meno dati, resta da vedere.
Perché conta adesso
La trascrizione in diretta sta diventando un’infrastruttura: assistenti vocali, sottotitoli, verbali di riunione. Chi la mette in servizio oggi mantiene spesso due modelli, uno per l’archivio e uno per la diretta. Il lavoro di NVIDIA non inventa l’unificazione, ma mostra che con una perdita semplice, scritta con attenzione alla memoria, un solo modello può coprire entrambi i ruoli fino a circa un quarto di secondo di ritardo perdendo poco offline (6,63% contro 6,47%), e che la cosa regge salendo di scala. È la risposta a una domanda da redazione più che da laboratorio: se si possa avere un sottotitolista solo. Sui benchmark del paper la risposta è sì, a patto di non scendere sotto il quarto di secondo e di aspettare che qualcuno gli insegni a non rileggere ogni volta gli ultimi cinque secondi e mezzo.
I commenti sono riservati agli iscritti.
Accedi per commentare