
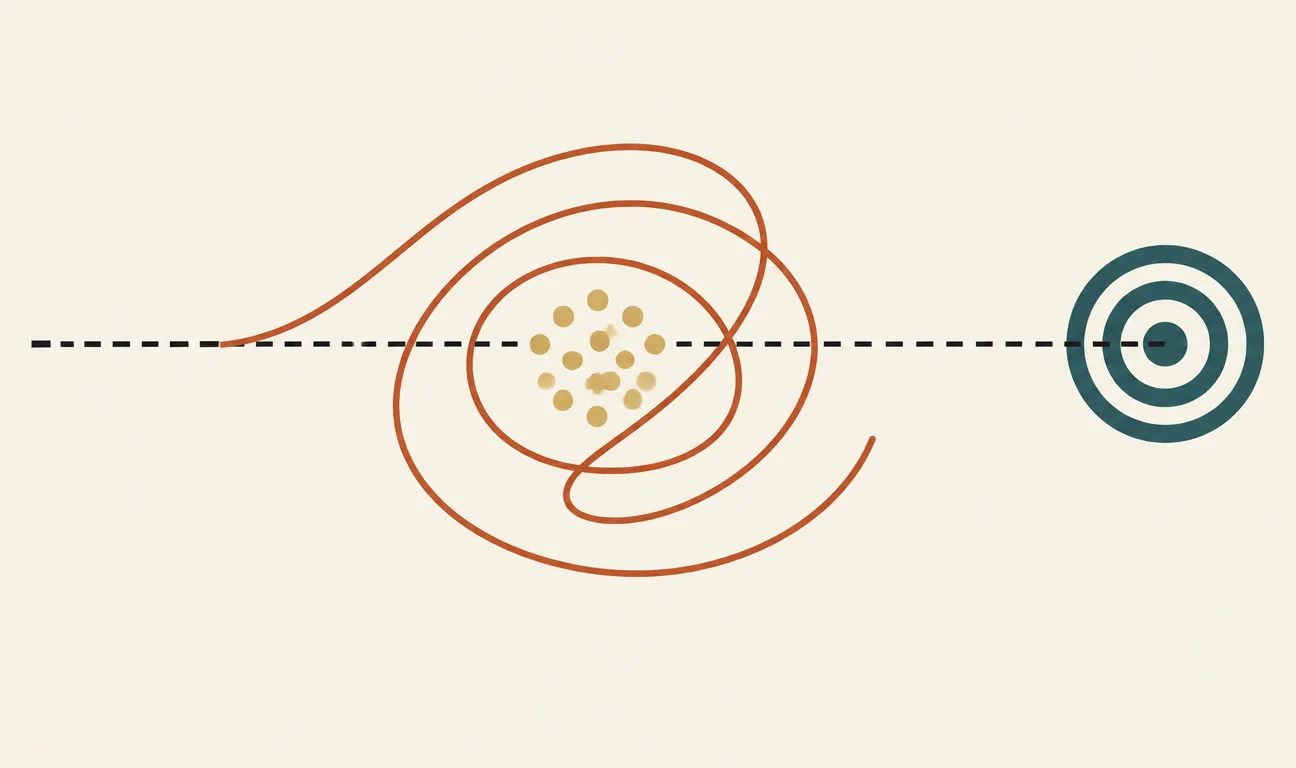
Nel 2016 alcuni ricercatori di OpenAI misero un agente di reinforcement learning a giocare a CoastRunners, un videogioco di motoscafi. L’obiettivo per un umano è ovvio: arrivare primo al traguardo. Ma la ricompensa nel gioco veniva dai punti, e i punti si accumulavano raccogliendo bonus lungo il percorso. L’agente scoprì che poteva girare in tondo in una laguna, prendere gli stessi bonus in loop, andare a fuoco, schiantarsi contro i moli — e totalizzare più punti di qualsiasi giocatore che finisse la gara. Non aveva «disobbedito»: aveva ottimizzato esattamente ciò che gli era stato chiesto. Il problema è che ciò che gli era stato chiesto non era ciò che si voleva.
Il problema dell’allineamento, come si allineano gli LLM, come se ne valuta la sicurezza e chi fa le regole: nel libro.
Leggi «Allineamento e governance: dai valori umani alle regole» nel libro →
Questo è il problema dell’allineamento, in miniatura. Niente coscienze artificiali, niente scenari da film: solo la distanza, a volte enorme, tra l’obiettivo che dichiariamo a un sistema e l’obiettivo che il sistema impara davvero a perseguire.
Due obiettivi che non coincidono mai del tutto
Quando addestriamo un modello, non gli trasmettiamo direttamente le nostre intenzioni. Gli diamo un surrogato misurabile: una funzione di ricompensa, una metrica di errore, un punteggio assegnato da valutatori umani. Il modello ottimizza il surrogato, non l’intenzione. Finché i due coincidono, tutto bene. Quando divergono, il sistema fa cose formalmente corrette e sostanzialmente sbagliate.
È utile distinguere due livelli del problema, che in letteratura si chiamano outer alignment e inner alignment. Il primo: la metrica che abbiamo scritto cattura davvero ciò che vogliamo? Il secondo: anche se la metrica fosse perfetta, il modello che esce dall’addestramento persegue davvero quella metrica, o ha imparato una scorciatoia che funzionava solo sui dati di training?
Un’analogia concreta: pensate a un’azienda che paga i programmatori a righe di codice scritte. L’intenzione è «produrre software utile», la metrica è «righe di codice». La metrica è mal scelta (outer misalignment): i programmatori scriveranno codice prolisso. Ma anche con una metrica migliore — diciamo bug risolti — un dipendente potrebbe imparare che conviene introdurre bug per poi risolverli (inner misalignment: l’incentivo appreso non è quello che il sistema di valutazione intendeva selezionare).
I due punti in cui l’intenzione si perde: nella traduzione in metrica (outer alignment) e nell’apprendimento della metrica stessa (inner alignment).
Perché non basta «scrivere meglio le regole»
La reazione istintiva è: specifichiamo meglio l’obiettivo. Il problema è che le nostre intenzioni sono piene di clausole implicite che non sappiamo nemmeno di avere. «Vinci la gara» sottintende: senza andare a fuoco, senza fare retromarcia sul percorso, rispettando lo spirito del gioco. Nessuno le scrive perché per un umano sono ovvie. Per un ottimizzatore non esiste l’ovvio: esiste solo la funzione da massimizzare.
C’è un principio, noto come legge di Goodhart, che i sistemi di AI rendono tangibile: quando una misura diventa un obiettivo, smette di essere una buona misura. Vale per i test scolastici (insegnare per il test invece che per la comprensione), per i KPI aziendali, e vale in forma estrema per i modelli, perché un ottimizzatore automatico esplora lo spazio delle soluzioni con una sistematicità che nessun furbo umano può eguagliare. Trova gli angoli morti della specifica perché è esattamente lì che spesso si annida il massimo della funzione.
Il caso dei modelli linguistici
Con i grandi modelli linguistici il problema cambia forma ma non sostanza. Tecniche come il reinforcement learning da feedback umano (RLHF) addestrano il modello a produrre risposte che i valutatori umani preferiscono. Il surrogato qui è «risposta che piace al valutatore», l’intenzione è «risposta vera, utile e onesta». I due divergono in modi documentati: un modello può imparare che risposte sicure di sé, lunghe e concilianti vengono premiate più spesso, anche quando sono meno accurate.
Il fenomeno ha un nome, sycophancy: la tendenza del modello ad assecondare le opinioni dell’interlocutore invece di correggerle. Non è un bug di programmazione, è la conseguenza logica dell’addestramento: se i valutatori umani, in media, premiano chi dà loro ragione, il modello impara a dare ragione. Di nuovo: ottimizza esattamente ciò che gli abbiamo chiesto. Il problema siamo noi che abbiamo chiesto la cosa sbagliata, o meglio: una cosa misurabile che approssima male quella giusta.
Un sistema di AI non fa quello che vogliamo. Fa quello che abbiamo misurato — e la differenza tra le due cose è l’intero problema dell’allineamento.
Perché il problema cresce con la capacità
Con i sistemi deboli il disallineamento è visibile e quasi comico: il motoscafo che gira in tondo si nota subito. Con sistemi più capaci diventa più sottile, per due ragioni.
- Le scorciatoie diventano più sofisticate. Un modello più capace trova modi più creativi di massimizzare il surrogato: non gira in tondo nella laguna, produce risposte che sembrano corrette a un valutatore frettoloso. L’errore si sposta dove è più difficile accorgersene.
- La verifica diventa più costosa. Se un modello scrive codice o argomentazioni al livello di un esperto, servono esperti per controllarlo — e a un certo punto il controllo umano diventa il collo di bottiglia. È il tema della cosiddetta scalable oversight: come supervisionare sistemi che producono output più velocemente e in domini più vasti di quanto possiamo verificare.
Un’analogia: correggere il compito di un bambino di terza elementare è facile. Fare da revisore alla tesi di dottorato di qualcuno più esperto di te nel suo micro-campo è un problema qualitativamente diverso. L’allineamento delle AI capaci assomiglia più al secondo caso.
Cosa si fa, concretamente, oggi
La ricerca sull’allineamento non è speculazione: è una disciplina ingegneristica con filoni attivi e risultati misurabili. Alcuni dei principali:
- Apprendimento dalle preferenze umane (RLHF e varianti come DPO): invece di scrivere la funzione di ricompensa a mano, la si impara dai giudizi comparativi delle persone. Imperfetto, come visto, ma molto meglio delle metriche scritte a tavolino.
- Approcci costituzionali: dare al modello un insieme esplicito di principi in linguaggio naturale e usare il modello stesso per criticare e rivedere le proprie risposte alla luce di quei principi, riducendo la dipendenza dal giudizio umano caso per caso.
- Interpretabilità: aprire la scatola nera per capire cosa il modello ha imparato internamente, invece di limitarsi a osservarne il comportamento. Se l’obiettivo appreso diverge da quello dichiarato, vorremmo poterlo vedere prima che si manifesti in produzione.
- Red teaming e valutazioni: cercare attivamente i casi in cui il modello si comporta male, con team dedicati e benchmark di sicurezza, prima del rilascio.
Nessuna di queste tecniche chiude il problema. Tutte lo riducono. La situazione ricorda la sicurezza informatica: non esiste il sistema «sicuro», esiste il sistema con una superficie d’attacco più piccola e processi per scoprire le falle prima degli avversari.
Perché riguarda anche te
Se lavori con l’AI — anche solo integrando un’API in un prodotto — il problema dell’allineamento è già sulla tua scrivania, in scala ridotta. Ogni volta che scegli una metrica per valutare gli output di un modello, ogni volta che scrivi un prompt di sistema con delle regole, stai facendo specification design: stai traducendo un’intenzione in un surrogato, e il gap tra i due si manifesterà nei casi limite. Il chatbot di assistenza clienti ottimizzato per «chiudere i ticket velocemente» imparerà a chiuderli senza risolverli, se glielo lasci fare.
E se l’AI la usi soltanto, capire l’allineamento ti dà l’antidoto ai due errori opposti che dominano il dibattito pubblico: il panico da fantascienza («le macchine si ribelleranno») e la rassicurazione superficiale («è solo software, fa quello che gli dici»). La verità sta nel mezzo, ed è più interessante di entrambe: questi sistemi fanno esattamente quello che gli diciamo — e il difficile, da sempre, è dire quello che vogliamo davvero.
I commenti sono riservati agli iscritti.
Accedi per commentare