
Misura l’altezza di mille persone e disegna quante ne trovi per ogni centimetro: ottieni una campana. Somma i punteggi di due dadi per qualche migliaio di lanci: una campana. Registra gli errori di uno strumento di misura, i pesi di una rete neurale appena inizializzata, il rumore che un diffusion model aggiunge a un’immagine: campane, campane, campane. La stessa curva, con la stessa formula, in contesti che non hanno niente in comune tra loro.
Variabili aleatorie, centro e larghezza di una distribuzione, gaussiana e teorema di Bayes stanno per esteso nel libro.
Leggi «Probabilità e statistica: convivere con l’incertezza» nel libro →
Questa insistenza ha qualcosa di sospetto. Perché la natura — e il machine learning — dovrebbero preferire proprio quella forma? La risposta è uno dei risultati più belli della matematica, e capirla cambia il modo in cui leggi metà delle scelte tecniche che trovi nel codice di un modello moderno.
Non è una curva, è un punto di arrivo
L’idea chiave è questa: la gaussiana non descrive un fenomeno particolare, descrive cosa succede quando tanti fenomeni piccoli e indipendenti si sommano. È il contenuto del teorema del limite centrale: sommando molte variabili casuali indipendenti, ciascuna con effetto limitato, la distribuzione della somma tende a una campana — quasi indipendentemente dalla forma delle singole variabili di partenza.
L’analogia più concreta è la macedonia. Il sapore di una macedonia fatta con trenta frutti diversi non dipende quasi più da nessun frutto in particolare: gli eccessi si compensano, e macedonie preparate da persone diverse finiscono per assomigliarsi. Con le somme di variabili casuali succede lo stesso: le fluttuazioni individuali si mediano, e la forma della somma converge sempre verso lo stesso profilo. L’altezza di una persona è la somma di migliaia di piccoli contributi genetici e ambientali: ecco perché le altezze sono gaussiane. L’errore di uno strumento è la somma di mille micro-disturbi indipendenti: ecco perché Gauss trovò quella curva studiando gli errori delle osservazioni astronomiche.
La campana non è la forma di qualcosa: è la forma verso cui tende la somma di tante piccole cause indipendenti.
L’esperimento più semplice: lanciare monete
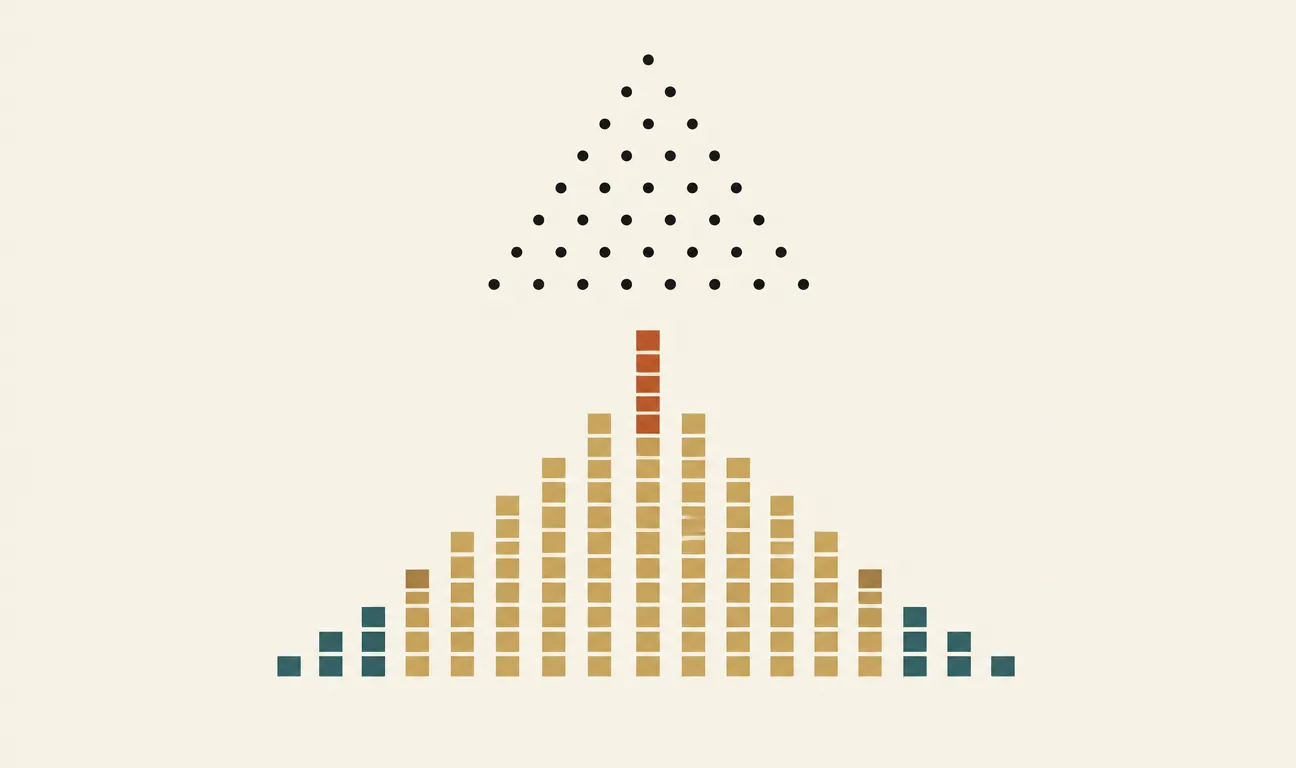
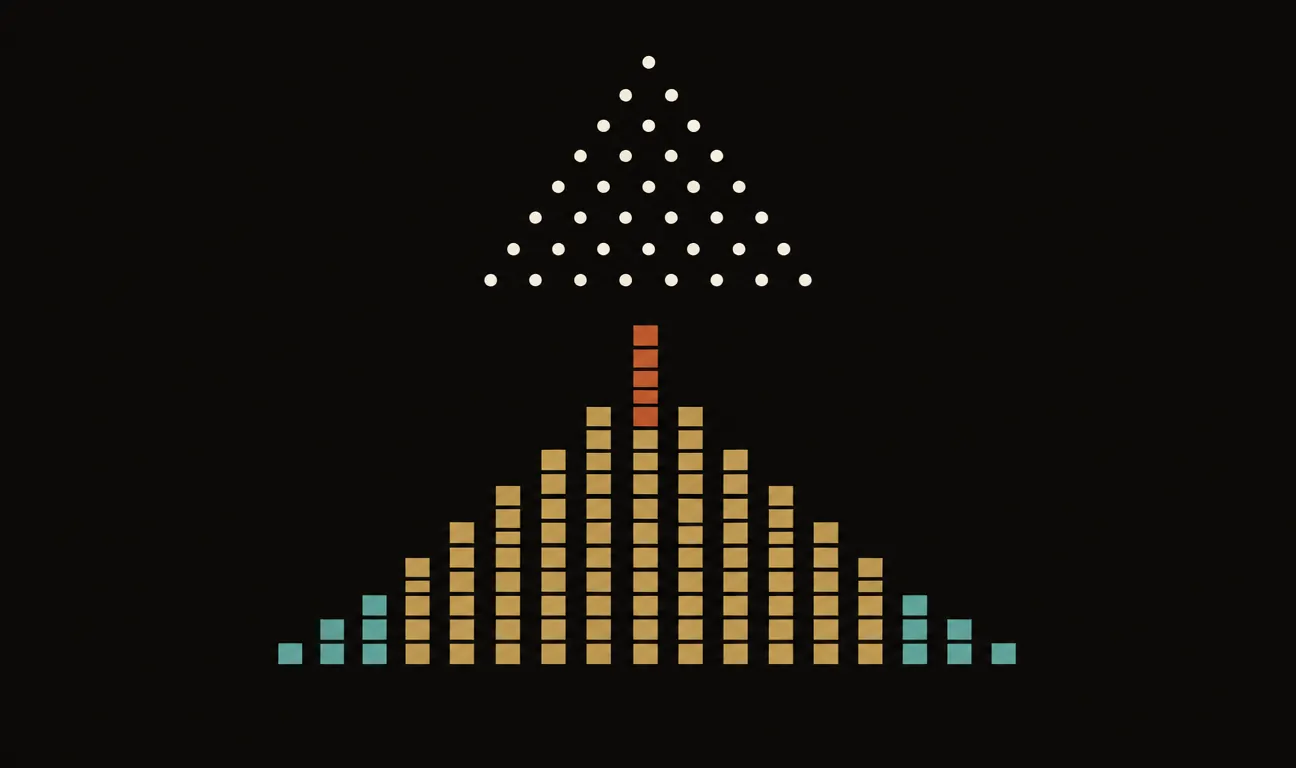
Il modo più pulito di vedere il teorema all’opera è la distribuzione binomiale. Lancia 20 monete eque e conta le teste: puoi ottenere da 0 a 20, ma non con la stessa probabilità. Dieci teste è l’esito più frequente; nove o undici poco meno; zero o venti sono rarissimi. Se disegni le probabilità come barre, ottieni un istogramma a gradini che ha già un’aria familiare.
Ora sovrapponi una gaussiana con media 10 e deviazione standard √5 ≈ 2,24 (cioè np e √(np(1−p)) con n=20 e p=0,5): la curva passa quasi esattamente per la cima di ogni barra. Con 100 monete l’accordo diventa quasi perfetto. È il risultato che Abraham de Moivre dimostrò nel Settecento, ben prima che la curva prendesse il nome di Gauss: la binomiale, all’aumentare dei lanci, diventa una gaussiana. Ogni moneta è una piccola causa indipendente; il conteggio delle teste è la loro somma; la campana è l’inevitabile punto di arrivo.
Le barre ocra mostrano la probabilità di ottenere k teste su 20 lanci di moneta; la curva terracotta è la gaussiana con la stessa media e la stessa deviazione standard. Già con 20 lanci la campana continua passa quasi esattamente per la cima delle barre discrete.
Dove la incontri quando fai AI
Aperto un progetto di machine learning qualsiasi, la gaussiana compare entro le prime righe di codice, spesso senza farsi annunciare.
- Inizializzazione dei pesi. I pesi di una rete neurale partono spesso da valori estratti da una gaussiana centrata in zero, con varianza calibrata sul numero di connessioni (gli schemi noti come Xavier e He, che esistono anche in variante uniforme). L’obiettivo è che i segnali attraversino la rete senza esplodere né spegnersi: ciò che conta è la varianza, e la campana è una scelta naturale per ottenerla.
- Rumore nei diffusion model. Modelli come quelli dietro i generatori di immagini imparano letteralmente a togliere rumore gaussiano aggiunto passo dopo passo. Tutta la matematica del processo — la possibilità di saltare avanti di molti passi con una sola formula — funziona perché la somma di gaussiane è ancora una gaussiana.
- Spazi latenti. Nei variational autoencoder lo spazio latente viene spinto verso una gaussiana standard: così campionare un punto a caso e decodificarlo produce qualcosa di sensato, invece di cadere in una zona vuota.
- Ipotesi sugli errori. Minimizzare l’errore quadratico medio — la loss più comune per la regressione — equivale ad assumere che gli errori del modello siano gaussiani. Non è un dettaglio: se gli errori veri non lo sono, quella loss dà pesi sproporzionati agli outlier.
Il filo comune è pragmatico: la gaussiana è la distribuzione con cui si riesce a fare matematica in forma chiusa. Media e varianza la descrivono completamente, somme e trasformazioni lineari la lasciano gaussiana, e queste proprietà trasformano problemi intrattabili in formule di due righe.
Quando la campana mente
Proprio perché è comoda, la gaussiana viene usata anche dove non c’entra. Il teorema del limite centrale ha condizioni precise: tante cause, indipendenti, nessuna dominante. Quando saltano, salta la campana.
I redditi non sono gaussiani: una singola persona può guadagnare diecimila volte la mediana, cosa impossibile per le altezze. I ritorni dei mercati finanziari hanno «code grasse»: eventi estremi molto più frequenti di quanto una campana preveda, come le crisi ricordano periodicamente a chi aveva modellato il rischio con troppa fiducia. Le dimensioni dei file, la popolarità dei contenuti online, la frequenza delle parole in un corpus seguono leggi di potenza, non campane.
Anche dentro l’AI la campana ha i suoi limiti: i gradienti durante l’addestramento di modelli grandi producono occasionalmente valori estremi che una gaussiana giudicherebbe impossibili — è uno dei motivi per cui esiste il gradient clipping, che taglia d’autorità i picchi. L’analogia utile è la differenza tra il traffico di una strada normale e quello di un’autostrada con incidenti: nel primo caso i ritardi si mediano, nel secondo un singolo evento domina tutto. La gaussiana descrive il primo mondo, non il secondo.
Il riflesso condizionato da sviluppare
La gaussiana è ovunque per una ragione strutturale — le somme di piccole cause indipendenti convergono lì — e per una ragione pratica: è la distribuzione su cui i conti tornano. Ma le due ragioni vanno tenute separate. Quando la campana emerge dai dati, sta raccontando qualcosa di vero sul processo che li genera. Quando viene assunta per comodità, è un’ipotesi come un’altra, da verificare.
Ecco perché ti riguarda: la prossima volta che incontri randn() in uno script di inizializzazione, una loss quadratica, un termine di rumore in un diffusion model, saprai leggere la scelta che c’è dietro — e chiederti la domanda giusta. Le cause in gioco sono davvero tante, piccole e indipendenti? Se sì, la campana è tua alleata. Se no, gli eventi estremi che il modello dichiara impossibili sono esattamente quelli che prima o poi arriveranno.
I commenti sono riservati agli iscritti.
Accedi per commentare