
Immagina di fare uno screening per una malattia rara. Il test è buono: individua il 99% dei malati e sbaglia solo nel 5% dei casi sui sani. Il risultato arriva: positivo. Quanto è probabile che tu sia davvero malato? La maggior parte delle persone — inclusi, in studi ormai classici, molti medici — risponde «circa il 99%». La risposta corretta, con i numeri che vedremo tra poco, è vicina al 2%.
Variabili aleatorie, centro e larghezza di una distribuzione, gaussiana e teorema di Bayes stanno per esteso nel libro.
Leggi «Probabilità e statistica: convivere con l’incertezza» nel libro →
Non è un trucco da quiz. È il teorema di Bayes, una formula del Settecento che oggi regge filtri antispam, sistemi di diagnosi assistita e, in forma più o meno esplicita, gran parte del machine learning. Capirla con i test medici è il modo più concreto che esista: perché lì l’errore di ragionamento si vede a occhio nudo, e costa caro.
La domanda giusta e la domanda sbagliata
Il test risponde a una domanda: se sei malato, quanto è probabile che il test risulti positivo? Il 99%, in questo caso. Ma a te interessa la domanda inversa: se il test è positivo, quanto è probabile che tu sia malato? Sono due probabilità diverse, e confonderle è così comune da avere un nome: la fallacia del condizionale trasposto.
Un’analogia aiuta. La probabilità che un calciatore di Serie A sia alto più di un metro e ottanta è ragionevolmente elevata. La probabilità che una persona alta più di un metro e ottanta giochi in Serie A è quasi zero. Stessa coppia di eventi, direzione opposta, risultati lontanissimi. Il teorema di Bayes è esattamente lo strumento che permette di passare da una direzione all’altra senza sbagliare.
In notazione: il test ci dà P(positivo | malato), a noi serve P(malato | positivo). Bayes le collega così:
P(malato | positivo) = P(positivo | malato) × P(malato) / P(positivo)
Il termine decisivo, quello che quasi tutti dimenticano, è P(malato): quanto è diffusa la malattia prima di fare il test. Si chiama probabilità a priori, ed è il cuore di tutta la faccenda.
Facciamo i conti con 10.000 persone
Le formule si dimenticano, le persone no. Prendiamo 10.000 individui e una malattia che colpisce una persona su mille: nella nostra popolazione ci sono quindi 10 malati e 9.990 sani.
- Dei 10 malati, il test ne individua il 99%: circa 10 positivi veri.
- Dei 9.990 sani, il test sbaglia nel 5% dei casi: circa 500 falsi positivi.
- I restanti 9.490 sani ricevono correttamente un risultato negativo.
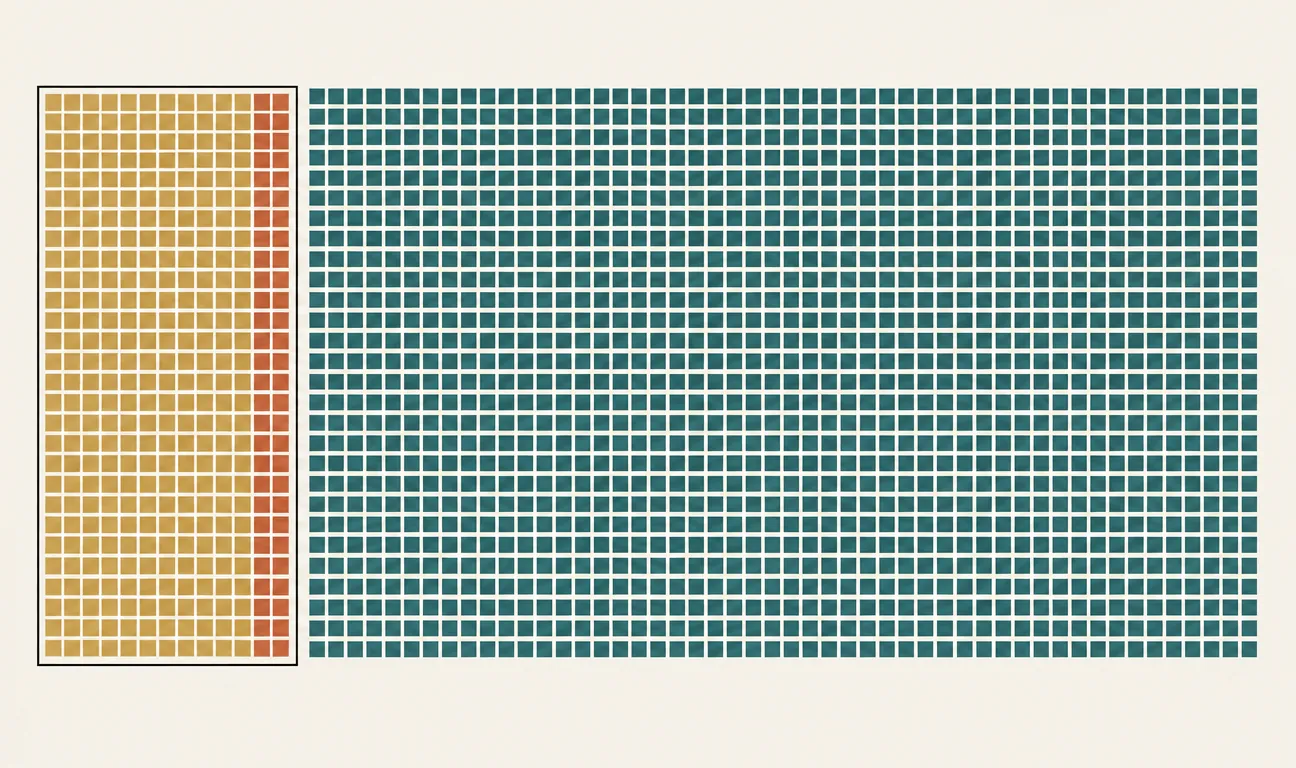
Ora mettiti nei panni di chi ha ricevuto un risultato positivo. I positivi totali sono circa 510: dieci malati veri e cinquecento sani etichettati per errore. La probabilità di essere davvero malato è 10 su 510, cioè poco meno del 2%. Il test non è cattivo: è la rarità della malattia a schiacciare il risultato. Quando cerchi un ago in un pagliaio, anche un metal detector eccellente suona soprattutto per le graffette.
Il diagramma ad albero dei falsi positivi: su 10.000 persone testate, i positivi veri (terracotta) sono sommersi dai falsi positivi (ocra). Chi riceve un esito positivo ha circa il 2% di probabilità di essere malato.
Il prior è l’ingrediente che nessuno vuole guardare
Il risultato cambia radicalmente se cambia la probabilità a priori. Se il medico ti prescrive il test perché hai già sintomi compatibili, non appartieni più alla popolazione generale: il tuo prior non è più 1 su 1.000, magari è 1 su 10. Rifai i conti con quel numero e il positivo diventa improvvisamente molto più allarmante. Stesso test, stessa accuratezza, conclusione opposta.
Un’evidenza non ha un significato assoluto: vale solo in rapporto a quanto era plausibile l’ipotesi prima di osservarla.
Questa è la lezione profonda di Bayes, e vale ben oltre la medicina. È il motivo per cui gli screening di massa su popolazioni a basso rischio producono valanghe di falsi allarmi, e per cui i test vengono ripetuti: un secondo test positivo parte da un prior aggiornato (il 2% calcolato prima, non più lo 0,1% iniziale) e sposta la probabilità molto più in alto. Il ragionamento bayesiano è iterativo: ogni evidenza diventa il punto di partenza della successiva.
Cosa c’entra tutto questo con l’AI
Moltissimo, e su più livelli. Il più diretto è storico: i primi filtri antispam efficaci erano classificatori «naive Bayes» che stimavano P(spam | parole del messaggio) esattamente come noi abbiamo stimato P(malato | positivo), con le frequenze delle parole al posto di sensibilità e specificità.
Il secondo livello riguarda qualunque classificatore moderno, rete neurale inclusa. Quando un modello di visione dice «tumore con confidenza 0,93», quella cifra è utile solo se sai su quale popolazione è stato addestrato e su quale viene usato. Un modello addestrato su un dataset dove metà delle immagini mostra tumori, applicato a uno screening dove i casi veri sono uno su mille, produce lo stesso identico effetto del nostro test: una marea di falsi positivi con confidenze altissime. In gergo si chiama prior shift o squilibrio tra distribuzione di training e di deployment, ed è una delle cause più comuni di modelli che funzionano benissimo in laboratorio e deludono in produzione.
Il terzo livello è concettuale: metriche come precision e recall, la curva ROC, la calibrazione delle probabilità di un modello sono tutte figlie della distinzione bayesiana tra le due direzioni del condizionale. Ogni volta che valuti un classificatore su un dataset sbilanciato, stai rifacendo il conto delle 10.000 persone.
Una formula postuma che non smette di lavorare
Thomas Bayes, pastore presbiteriano inglese, non pubblicò mai il suo teorema: il saggio uscì postumo nel 1763, curato dall’amico Richard Price. Per due secoli la statistica dominante lo guardò con sospetto, proprio per quel prior che sembra introdurre soggettività nei calcoli. Oggi il quadro si è rovesciato: l’inferenza bayesiana è ovunque, dalla localizzazione GPS ai sistemi di raccomandazione, e «aggiornare le proprie credenze in base all’evidenza» è diventato il modo standard di descrivere cosa fa un sistema che apprende.
Perché ti riguarda? Perché il teorema di Bayes è un vaccino contro un errore che commettiamo tutti, ogni giorno: scambiare la forza di un’evidenza per la probabilità di un’ipotesi. Vale quando leggi l’esito di un esame medico, quando un modello ti restituisce una confidenza al 93%, quando un titolo di giornale dice che «il test individua il 99% dei casi». La prossima volta che un numero ti sembra schiacciante, chiediti sempre la stessa cosa: quanto era probabile l’ipotesi prima? Su 10.000 persone, quante stanno davvero nel ramo terracotta dell’albero?
I commenti sono riservati agli iscritti.
Accedi per commentare