
Girate la manopola del gas sotto una pentola. La fiamma si alza, l’acqua si scalda, la pasta cuoce prima. Tre passaggi, tre relazioni di causa ed effetto in fila. Ora la domanda interessante: se giro la manopola di un millimetro, di quanti secondi si accorcia la cottura? Nessuno dei tre passaggi, da solo, sa rispondere. Ma se so quanto la fiamma risponde alla manopola, quanto la temperatura risponde alla fiamma e quanto la cottura risponde alla temperatura, la risposta è il prodotto delle tre sensibilità. Questa idea — che gli effetti si propagano lungo una catena moltiplicandosi — ha un nome tecnico, chain rule, e regge da sola l’intero addestramento delle reti neurali.
Derivate, gradiente, regola della catena e discesa del gradiente sono trattati per esteso nel libro, formule comprese.
Leggi «Analisi e ottimizzazione: derivate e discesa del gradiente» nel libro →
Funzioni dentro funzioni
In matematica la catena della pentola si scrive come composizione di funzioni: l’uscita di una diventa l’ingresso della successiva. Se f trasforma la manopola in fiamma, g la fiamma in temperatura e h la temperatura in tempo di cottura, il sistema completo è h(g(f(x))) — funzioni annidate come matrioske.
La chain rule dice come si deriva una cosa del genere: la derivata della composizione è il prodotto delle derivate dei singoli anelli, ciascuna calcolata nel punto giusto della catena. Se la fiamma risponde alla manopola con fattore 2, la temperatura alla fiamma con fattore 3 e la cottura alla temperatura con fattore 0,5, allora la cottura risponde alla manopola con fattore 2 × 3 × 0,5 = 3. Nessun anello conosce la catena intera; ognuno conosce solo il proprio tratto. Eppure il prodotto delle conoscenze locali dà la sensibilità globale.
Perché il prodotto, e non la somma
L’intuizione è quella degli ingranaggi. Se un ingranaggio raddoppia la velocità di rotazione e il successivo la triplica, la velocità finale è sei volte quella iniziale: i rapporti si moltiplicano perché ogni passaggio agisce sul risultato del precedente, non in parallelo ad esso. Le derivate sono rapporti — quanto si muove l’uscita per ogni unità di movimento dell’ingresso — e per la stessa ragione si compongono per moltiplicazione.
Questo dettaglio, apparentemente da manuale, ha una conseguenza enorme: in una catena lunga basta un anello con derivata molto piccola per azzerare quasi tutto il prodotto, e basta qualche anello con derivata grande per farlo esplodere. Teniamolo da parte: ci torneremo.
Una rete neurale è una catena (molto ramificata)
Una rete neurale è esattamente una composizione di funzioni: uno strato riceve numeri, li trasforma, li passa allo strato dopo. Dieci strati sono dieci matrioske; alla fine della catena c’è la loss, il numero che misura quanto la previsione è sbagliata. Addestrare la rete significa capire come ogni parametro — ogni peso, in ogni strato — influenza quel numero finale. È la domanda della pentola, posta miliardi di volte: se tocco questa manopola, la loss come cambia?
La chain rule risponde per ogni parametro: la sensibilità della loss a un peso dello strato tre è il prodotto delle derivate lungo il percorso che va da quel peso fino all’uscita. L’unica differenza rispetto alla pentola è che una rete non è una catena singola ma un grafo: da un parametro all’uscita esistono più percorsi, e i loro contributi si sommano. Prodotto lungo ogni percorso, somma tra percorsi. Tutto qui.
Backpropagation: la chain rule organizzata bene
Applicare la chain rule separatamente per ciascuno dei miliardi di parametri sarebbe uno spreco colossale: percorsi diversi condividono quasi tutti gli anelli. La backpropagation è il modo furbo di organizzare il calcolo: si parte dalla loss e si percorre la rete all’indietro, strato per strato, portandosi dietro un unico valore accumulato — «quanto la loss è sensibile a ciò che esce da qui». Ogni strato moltiplica quel valore per la propria derivata locale e lo passa allo strato precedente. Un solo passaggio all’indietro, e ogni parametro conosce il proprio gradiente.
È lo stesso trucco di chi calcola il resto in cascata invece di rifare il conto da capo per ogni moneta. La matematica è del Seicento — Leibniz la conosceva — ma l’organizzazione efficiente del calcolo su un grafo è ciò che ha reso addestrabili le reti profonde.
Nessuno strato sa cosa fa la rete. Ognuno sa solo quanto amplifica ciò che lo attraversa. L’apprendimento è il prodotto di queste conoscenze locali.
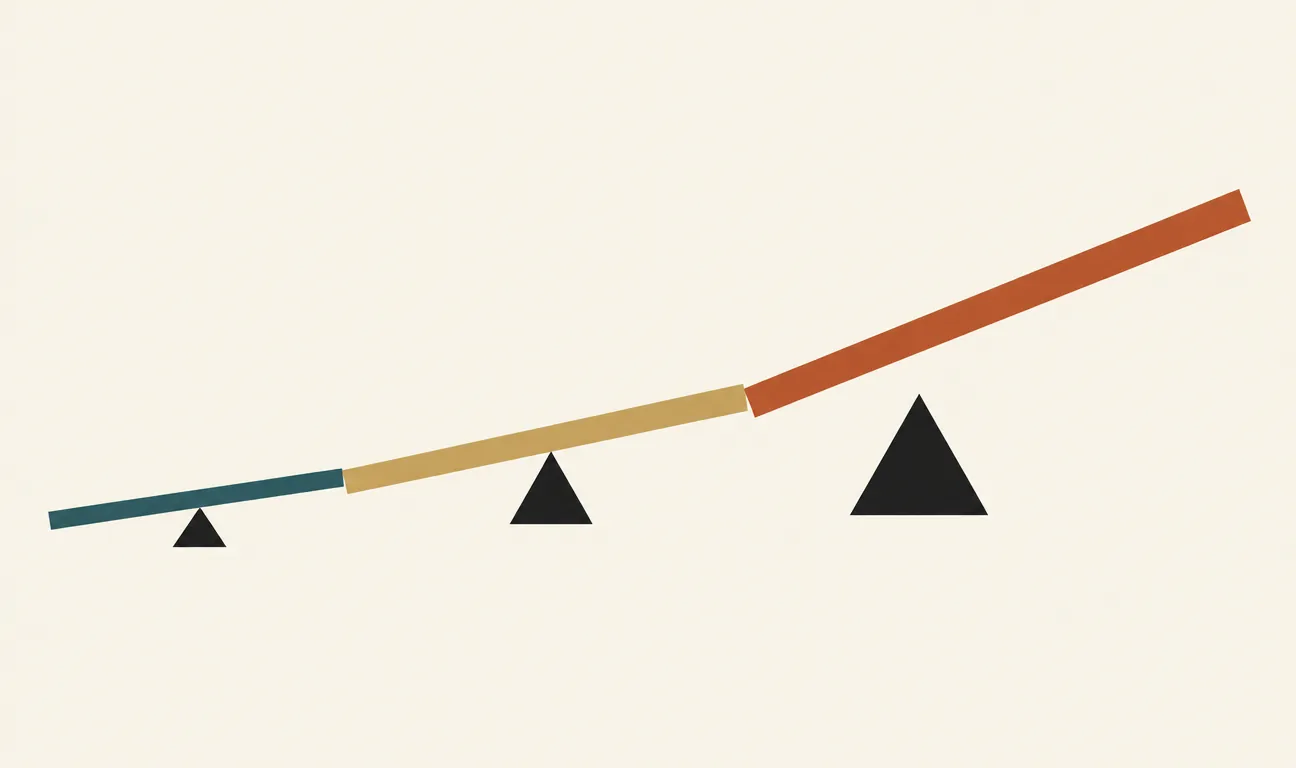
La chain rule in un’immagine: tre funzioni annidate, tre derivate locali. La sensibilità dell’uscita all’ingresso è il prodotto degli anelli, e l’errore la percorre a ritroso.
Quando la catena si spezza: gradienti che svaniscono
Riprendiamo il dettaglio messo da parte. In una rete di cinquanta strati, il gradiente che arriva ai primi strati è un prodotto di decine di fattori. Se questi fattori sono in media minori di uno, il prodotto crolla verso lo zero: è il vanishing gradient, il motivo per cui per anni le reti profonde non imparavano. I primi strati ricevevano un segnale d’errore così flebile da restare di fatto congelati — come un ordine sussurrato di bocca in bocca lungo una fila di cinquanta persone: all’ultimo arriva un soffio indistinguibile dal silenzio. Il problema opposto, fattori maggiori di uno che fanno esplodere il prodotto, si chiama exploding gradient.
Buona parte dell’ingegneria delle architetture moderne è una risposta a questa aritmetica: le connessioni residue delle ResNet (e dei Transformer) aggiungono scorciatoie in cui il gradiente passa senza essere moltiplicato; funzioni di attivazione come ReLU hanno derivata 1 dove sono attive, invece dei fattori piccoli delle sigmoidi; la normalizzazione tiene i valori intermedi in un intervallo in cui le derivate non degenerano. Non sono trovate estetiche: sono manutenzione della catena.
Perché vi riguarda
Se lavorate con il deep learning, la chain rule non è un prerequisito d’esame: è il meccanismo che gira ogni volta che chiamate loss.backward() in PyTorch. Le librerie di differenziazione automatica non fanno altro che costruire il grafo delle funzioni annidate e applicare la chain rule all’indietro, esattamente come descritto qui. Quando un addestramento non converge, quando i gradienti esplodono o svaniscono, quando qualcuno vi spiega perché le connessioni residue funzionano, la risposta sta sempre nello stesso punto: una catena di derivate che si moltiplicano. E anche fuori dal codice, l’idea resta un buon attrezzo mentale: in ogni sistema fatto di cause in cascata — un prezzo che sale, una filiera, un contagio — l’effetto complessivo di un piccolo intervento è il prodotto delle sensibilità locali. Basta un anello indifferente per assorbire tutto, o un anello nervoso per amplificare ogni tocco.
I commenti sono riservati agli iscritti.
Accedi per commentare