
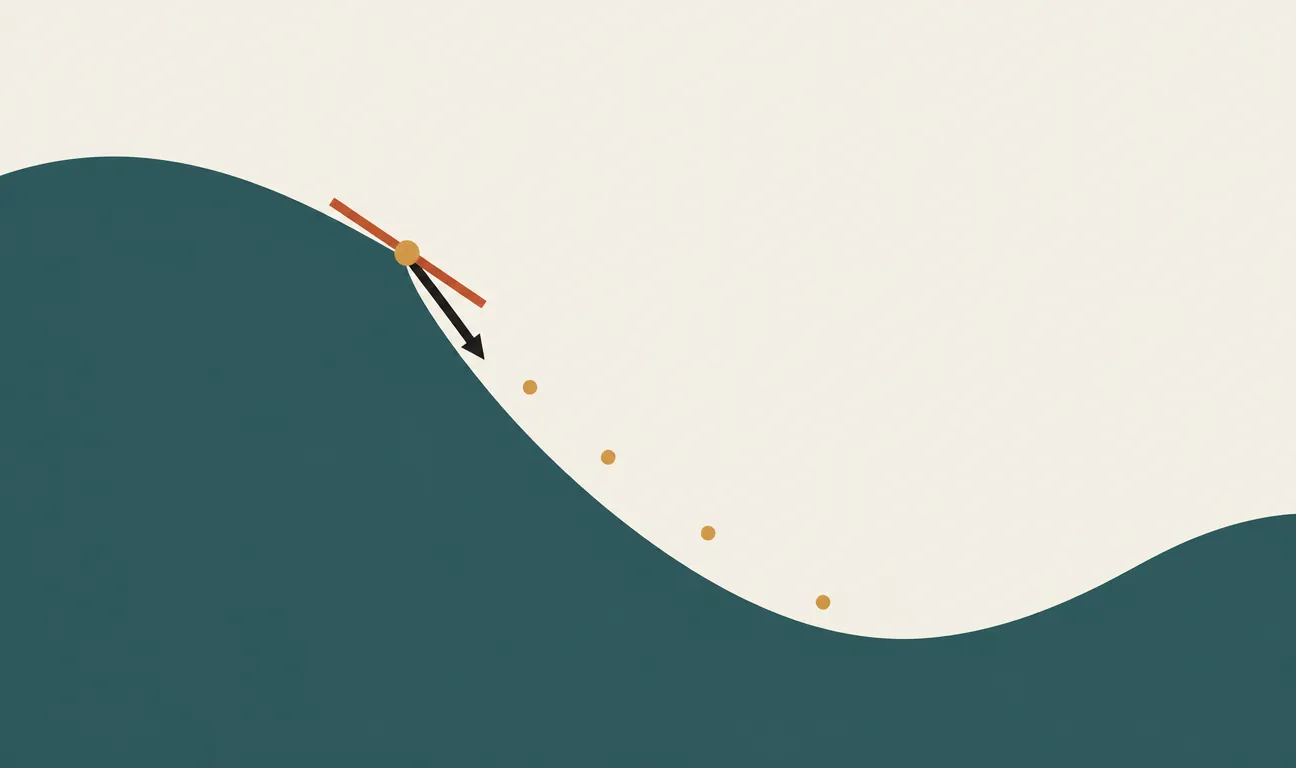
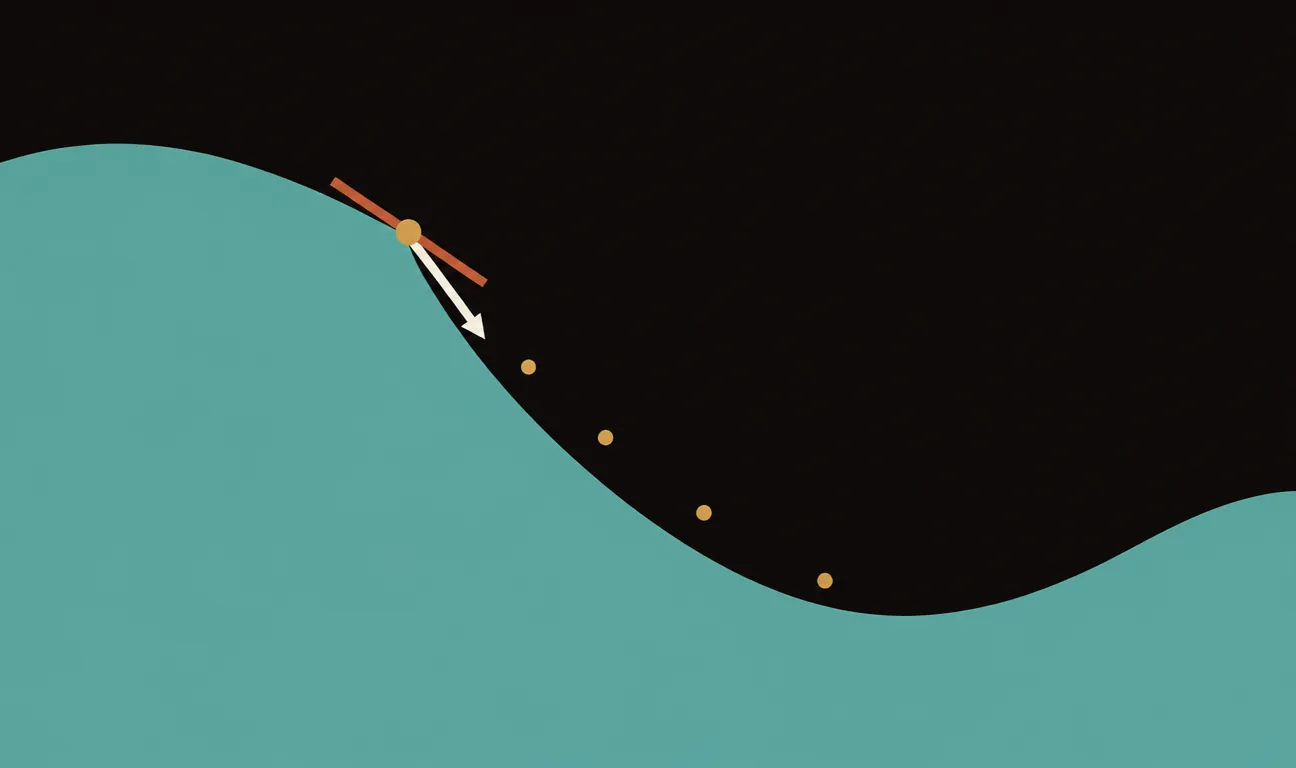
Immaginate di essere su un versante di montagna, di notte, nella nebbia. Non vedete la valle, non avete mappa, non sapete nemmeno da che parte sia il basso. Avete un solo strumento: i vostri piedi, che sentono la pendenza del terreno nel punto esatto in cui vi trovate. La strategia è ovvia — un passo nella direzione in cui il terreno scende di più, poi risentire la pendenza, poi un altro passo. Questa scena, ripetuta miliardi di volte in uno spazio con miliardi di dimensioni, è l’addestramento di un modello di intelligenza artificiale. Lo strumento che fa da piedi si chiama gradiente, e per capirlo bisogna partire da un’idea più semplice: la derivata.
Derivate, gradiente, regola della catena e discesa del gradiente sono trattati per esteso nel libro, formule comprese.
Leggi «Analisi e ottimizzazione: derivate e discesa del gradiente» nel libro →
La derivata: quanto cambia l’uscita se tocco l’ingresso
Una funzione è una macchina: entra un numero, esce un numero. La derivata risponde a una domanda pratica: se muovo l’ingresso di pochissimo, di quanto si muove l’uscita? Se la derivata in un punto vale 3, aumentare l’ingresso di un millesimo aumenta l’uscita di circa tre millesimi. Se vale −0,5, aumentare l’ingresso fa scendere l’uscita, della metà dello spostamento.
Geometricamente, la derivata è la pendenza della funzione in quel punto: l’inclinazione della retta che meglio la approssima lì. E questa è l’idea da portare a casa: la derivata è un’informazione locale. Non sa nulla della forma complessiva della funzione, non sa dov’è il minimo, non sa cosa succede dieci passi più in là. Sa solo com’è fatto il terreno sotto i piedi. Che una conoscenza così miope basti ad addestrare sistemi con centinaia di miliardi di parametri è, a pensarci, il fatto più notevole di tutto il deep learning.
Il problema: milioni di manopole
Un modello di machine learning è una funzione con tante manopole, i parametri. Per un dato input, il modello produce una previsione; una seconda funzione, la loss, misura quanto la previsione è sbagliata. Addestrare il modello significa girare le manopole in modo da rendere la loss più piccola possibile.
Con una manopola sola basterebbe la derivata: se è positiva, girare a sinistra; se è negativa, a destra. Ma un modello linguistico ha miliardi di manopole, e la loss dipende da tutte insieme. Provarle a caso è fuori discussione: è come cercare la combinazione di una cassaforte con miliardi di rotelle. Serve un modo per sapere, per ogni manopola simultaneamente, in che verso girarla e con quanta decisione.
Il gradiente: tutte le pendenze in un colpo solo
La risposta è il gradiente, che si scrive ∇L. È il vettore che raccoglie le derivate parziali della loss: una per parametro, ognuna calcolata tenendo ferme tutte le altre manopole. Un modello con un miliardo di parametri ha un gradiente con un miliardo di componenti — la pagella completa, manopola per manopola, di come ciascuna influenza l’errore in questo istante.
Il gradiente ha una proprietà geometrica che è il perno di tutto: come vettore, punta nella direzione in cui la loss cresce più rapidamente. Di conseguenza la direzione opposta, −∇L, è quella in cui la loss scende più in fretta. Il gradiente è una bussola che, invece di indicare il nord, indica la salita: per scendere basta leggerla al contrario.
L’apprendimento automatico non cerca il minimo: cerca solo, in ogni istante, la direzione in cui l’errore diminuisce di più. Il minimo è dove quella ricerca si esaurisce.
La superficie della loss vista dall’alto: le curve di livello (teal) collegano punti con lo stesso errore, come le isoipse di una carta topografica. Dal punto di partenza, ogni passo della discesa (terracotta) segue la direzione opposta al gradiente, −∇L, fino ad assestarsi sul minimo.
La discesa: pendenza, passo, ripetere
L’algoritmo che ne segue è la discesa del gradiente, e sta in una riga: i nuovi parametri sono i vecchi, meno il gradiente moltiplicato per un numero piccolo. Quel numero, il learning rate, decide la lunghezza del passo, ed è la manopola più delicata di tutto il mestiere.
Funziona come la manopola di una doccia sconosciuta. Girate troppo poco alla volta e passerete dieci minuti a raggiungere la temperatura giusta: passi minuscoli, convergenza esasperante. Girate con troppa foga e oscillerete in eterno tra gelo e ustione, saltando la temperatura giusta a ogni correzione: passi troppo lunghi, e la discesa scavalca il minimo o addirittura diverge. In pratica non si usa quasi mai un passo fisso: metodi come Adam adattano la lunghezza del passo parametro per parametro, e gli scheduler la riducono man mano che ci si avvicina a destinazione — falcate all’inizio, passetti alla fine.
C’è un secondo compromesso pratico: calcolare la loss su tutto il dataset per fare un solo passo è uno spreco. La versione stocastica della discesa stima il gradiente su un piccolo lotto di esempi alla volta. La bussola diventa rumorosa — ogni singola lettura è imprecisa — ma le letture sono così tante ed economiche che in media si scende comunque, e più in fretta.
Perché una strategia così miope funziona
Resta il sospetto legittimo: seguire la pendenza locale su una superficie con miliardi di dimensioni, senza mai vedere la mappa, non dovrebbe finire male? Un escursionista nella nebbia può infilarsi in una conca e credere di essere arrivato a valle.
La risposta onesta è duplice. Primo: la discesa del gradiente non garantisce affatto di trovare il minimo globale, e nessuno lo pretende. Secondo, e più interessante: nelle reti neurali di grandi dimensioni questo si è rivelato molto meno grave del temuto. In spazi con tantissime dimensioni, i punti critici davvero bloccanti sono più rari di quanto l’intuizione tridimensionale suggerisca — per intrappolare la discesa, il terreno deve salire in tutte le direzioni contemporaneamente, e con miliardi di direzioni disponibili quasi sempre almeno una via di fuga esiste. Inoltre i minimi raggiungibili tendono a essere tanti e di qualità simile: non serve il fondovalle perfetto, basta una valle abbastanza buona. (Ai plateau, ai punti di sella e alle loro insidie dedicheremo un articolo a parte.)
Manca un ultimo tassello: come si calcola, concretamente, un gradiente con miliardi di componenti senza impiegare un’era geologica? La risposta è la backpropagation, un’applicazione sistematica della regola della catena che ottiene tutte le derivate parziali al costo di circa due passaggi attraverso la rete. È l’argomento del prossimo articolo di questa serie.
Perché vi riguarda
Ogni volta che leggete «il modello è stato addestrato», la scena è questa: una superficie d’errore invisibile, una bussola locale, miliardi di passetti. Capirlo cambia il modo in cui interpretate il lavoro quotidiano: un addestramento che diverge è quasi sempre un passo troppo lungo; uno che ristagna, un passo troppo corto o una superficie piatta; le «curve di loss» che vedete nei report sono il diario di bordo di questa discesa. E ridimensiona un mito: il modello non «capisce» ciò che impara più di quanto l’escursionista nella nebbia veda la valle. Segue una pendenza, un millesimo alla volta — e la cosa sorprendente, che merita di essere capita invece che mitizzata, è quanto lontano si arrivi così.
I commenti sono riservati agli iscritti.
Accedi per commentare