
Nel 1998 un dottorando di Stanford, Larry Page, deposita un brevetto che descrive come ordinare le pagine web per importanza. Il cuore matematico di quell’idea, che diventerà Google, è un singolo autovettore: il vettore che, applicata la matrice dei link del web, resta uguale a se stesso. Non è un caso isolato. Quando comprimete un dataset con la PCA, quando vi chiedete se l’addestramento di una rete neurale convergerà o esploderà, quando un motore di raccomandazione fattorizza una matrice di valutazioni, state sempre facendo la stessa domanda: quali direzioni questa trasformazione lascia in pace?
Vettori, prodotto scalare, matrici come trasformazioni, autovalori e autovettori: la trattazione completa, con la notazione, sta nel libro.
Leggi «Algebra lineare: vettori, matrici, prodotti» nel libro →
Una matrice è una trasformazione, non una tabella
Il primo passo è smettere di pensare a una matrice come a una griglia di numeri. Una matrice 2×2 è una macchina che prende ogni punto del piano e lo sposta da qualche altra parte, in modo regolare: le linee restano linee, l’origine resta ferma. Immaginate il piano come un impasto di pizza steso sul tavolo: la matrice è il gesto delle mani che lo stira in una direzione e lo comprime in un’altra. Ogni punto dell’impasto si muove, ma il movimento non è caotico — segue una regola precisa e uguale ovunque.
Quando scriviamo y = A x, stiamo dicendo: prendi il punto x, passalo nella macchina A, ottieni il punto y. La domanda interessante non è dove finisce un singolo punto, ma qual è la forma complessiva del gesto. Stira? Ruota? Schiaccia? Ribalta?
Le direzioni fedeli
Dentro quasi ogni trasformazione si nascondono direzioni speciali. Prendete un vettore lungo una di queste direzioni e applicategli la matrice: il risultato punta esattamente nella stessa direzione di prima. Può essere più lungo, più corto, perfino ribaltato — ma la retta su cui giace non cambia. Questi vettori si chiamano autovettori. Il fattore di allungamento (o accorciamento) si chiama autovalore, e si indica con λ.
In formula è una riga sola: A v = λ v. Applicare la matrice al vettore v equivale a moltiplicarlo per un semplice numero. Tutta la complessità della trasformazione, lungo quella direzione, collassa in una moltiplicazione scalare.
L’analogia più onesta è la venatura del legno. Un’asse di legno si comporta in modo diverso a seconda della direzione: lungo la venatura si piega e si spacca facilmente, di traverso resiste. La venatura è una proprietà intrinseca del materiale, non del coltello che usate. Allo stesso modo gli autovettori sono le «venature» di una matrice: le direzioni lungo cui la trasformazione agisce nel modo più semplice possibile, e che rivelano la sua natura profonda.
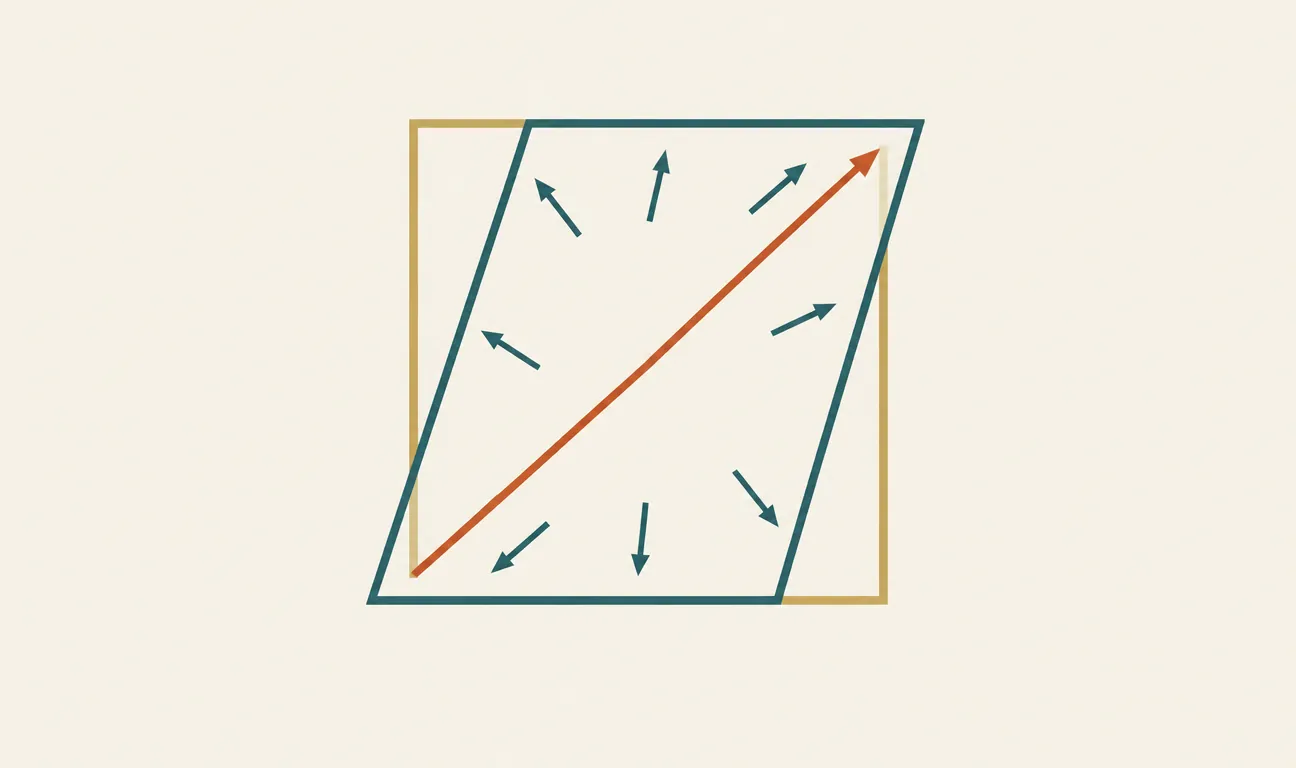
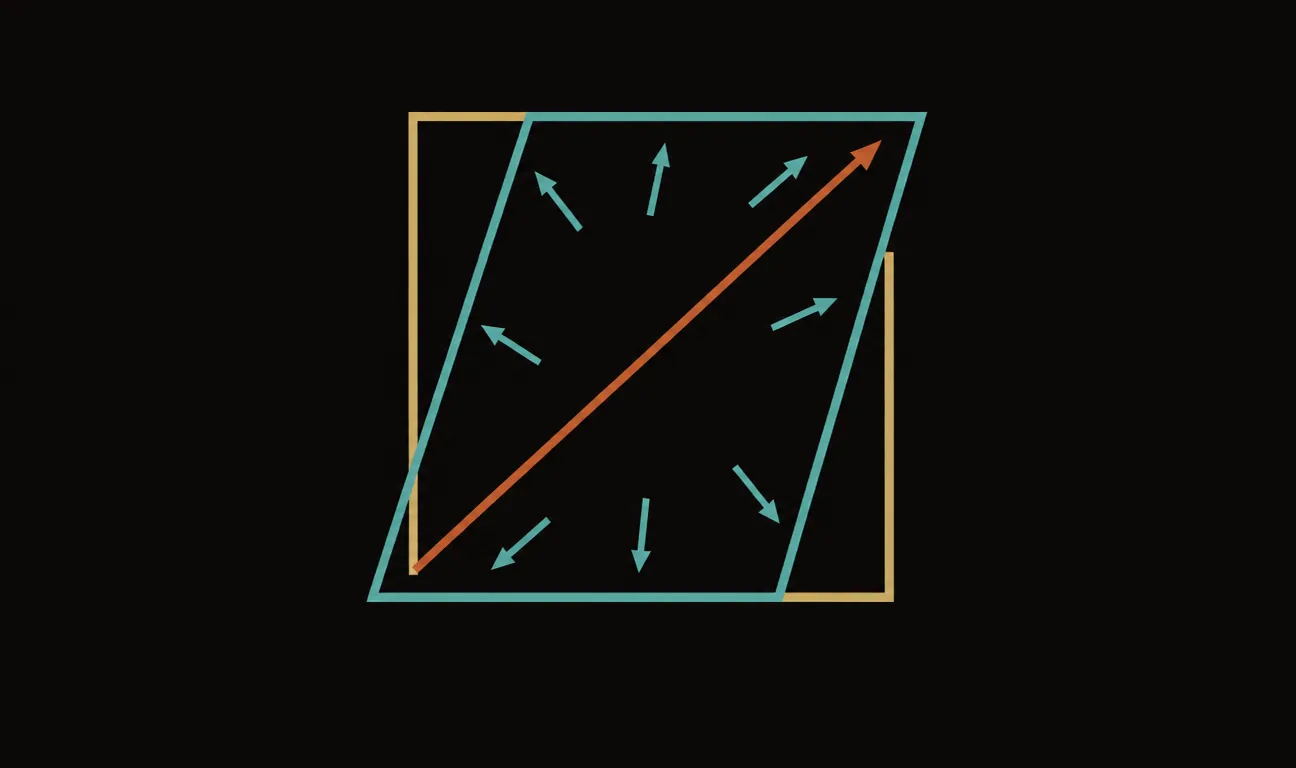
La trasformazione A stira il piano: aumenta le distanze del 50% in orizzontale e le dimezza in verticale. Gli autovettori v₁ e v₂ mantengono la loro direzione (cambiano solo lunghezza, secondo gli autovalori 1,5 e 0,5), mentre un vettore generico w viene deviato dalla sua retta originale.
L’autovalore racconta il destino della direzione
Il numero λ associato a ogni autovettore è una specie di oroscopo per quella direzione. Se λ è maggiore di 1, tutto ciò che punta da quella parte viene amplificato ogni volta che la trasformazione si applica. Se λ è compreso tra 0 e 1, viene attenuato. Se λ è negativo, viene ribaltato. E se applicate la matrice non una ma cento volte — come accade a un segnale che attraversa cento strati di una rete, o a una passeggiata casuale che itera cento passi su un grafo — l’effetto si accumula: λ elevato alla centesima potenza. Un autovalore di 1,1 diventa un fattore 13.780; un autovalore di 0,9 diventa 0,00003.
Un autovalore appena sopra 1 significa esplosione, appena sotto 1 significa estinzione: iterare una trasformazione trasforma differenze minuscole in destini opposti.
È esattamente il motivo per cui le reti neurali ricorrenti soffrivano di gradienti che esplodevano o svanivano: retropropagare l’errore attraverso il tempo significa moltiplicare ripetutamente per la stessa matrice, e il comportamento a lungo termine è dettato dai suoi autovalori. Molte tecniche di stabilizzazione dell’addestramento — dall’inizializzazione ortogonale dei pesi al gradient clipping — sono, in fondo, modi per tenere gli autovalori vicini alla zona di sicurezza.
PCA: lasciare che i dati scelgano gli assi
L’applicazione più diretta in machine learning è l’analisi delle componenti principali. Prendete una nuvola di punti in mille dimensioni — per esempio mille misurazioni per ogni paziente di uno studio clinico. La matrice di covarianza di quei dati descrive come le misurazioni variano insieme. I suoi autovettori sono le direzioni lungo cui la nuvola si allunga di più; i suoi autovalori dicono quanto si allunga.
Tenere le prime dieci componenti principali significa proiettare i dati sulle dieci direzioni con gli autovalori più grandi, buttando via le altre 990. È come fotografare una scultura: non potete conservare le tre dimensioni, ma potete scegliere l’angolo che perde meno informazione. Gli autovettori della covarianza sono quell’angolo, calcolato invece che indovinato.
Lo stesso schema torna ovunque: lo spectral clustering raggruppa i nodi di un grafo usando gli autovettori della sua matrice laplaciana; i sistemi di raccomandazione classici scomponevano la matrice utenti-per-film nelle sue direzioni dominanti; il PageRank citato in apertura è l’autovettore con autovalore 1 della matrice che descrive un navigatore casuale che clicca link a caso.
Come si trovano, in pratica
Sui libri di testo gli autovalori si calcolano risolvendo il polinomio caratteristico, det(A − λI) = 0. È utile per capire la teoria e impraticabile oltre le dimensioni giocattolo: nessuno risolve un polinomio di grado un milione.
Il metodo che si usa davvero, nella sua forma più semplice, è quasi imbarazzante: si prende un vettore a caso e gli si applica la matrice, ancora e ancora, rinormalizzando a ogni passo. A ogni applicazione la componente lungo l’autovettore dominante viene amplificata più di tutte le altre, e dopo poche decine di iterazioni il vettore si è allineato alla direzione con l’autovalore più grande. Si chiama metodo delle potenze, ed è concettualmente ciò che faceva il primo Google su scala web: iterare finché l’ordinamento delle pagine smetteva di cambiare. Le librerie moderne (LAPACK, e quindi numpy.linalg.eig) usano algoritmi più raffinati, ma l’intuizione resta quella: la direzione dominante emerge da sola, basta insistere.
Perché vi riguarda
Se lavorate con i dati, gli autovettori sono lo strumento con cui distinguete la struttura dal rumore: le direzioni con autovalori grandi sono il segnale, quelle con autovalori piccoli sono spesso rumore comprimibile. Se addestrate modelli, gli autovalori vi dicono se un processo iterativo — una ricorrenza, un ciclo di ottimizzazione, una catena di strati — tende a stabilizzarsi o a degenerare. E se leggete paper, li troverete ovunque sotto falso nome: «componente principale», «direzione dominante», «spectral norm», «curvatura della loss» sono tutti modi di dire autovettori e autovalori.
La prossima volta che una matrice vi sembra una tabella opaca di numeri, chiedetele qual è la sua venatura. È la domanda che trasforma l’algebra lineare da rito notazionale a strumento per vedere.
I commenti sono riservati agli iscritti.
Accedi per commentare