
Un editore deve far rileggere un romanzo di ottocento pagine e ha otto correttori. Li mette a lavorare in parallelo, cento pagine ciascuno: rapidissimo, e con un difetto che si vede solo dopo — nessuno si accorge che il personaggio cambia nome fra pagina 99 e pagina 101, perché quel punto è la cucitura fra due letture e non l’ha letto nessuno per intero. La soluzione non è far leggere tutto a tutti. È far cominciare metà dei correttori con cinquanta pagine di sfasamento, così che le cuciture degli uni cadano in mezzo alla lettura degli altri.
È l’idea centrale di LongLoRA, il lavoro con cui Yukang Chen e colleghi della Chinese University of Hong Kong, del MIT e di NVIDIA hanno reso alla portata di una macchina sola una cosa che nel 2023 richiedeva un piccolo datacenter: allungare la finestra di contesto di un modello linguistico già addestrato.
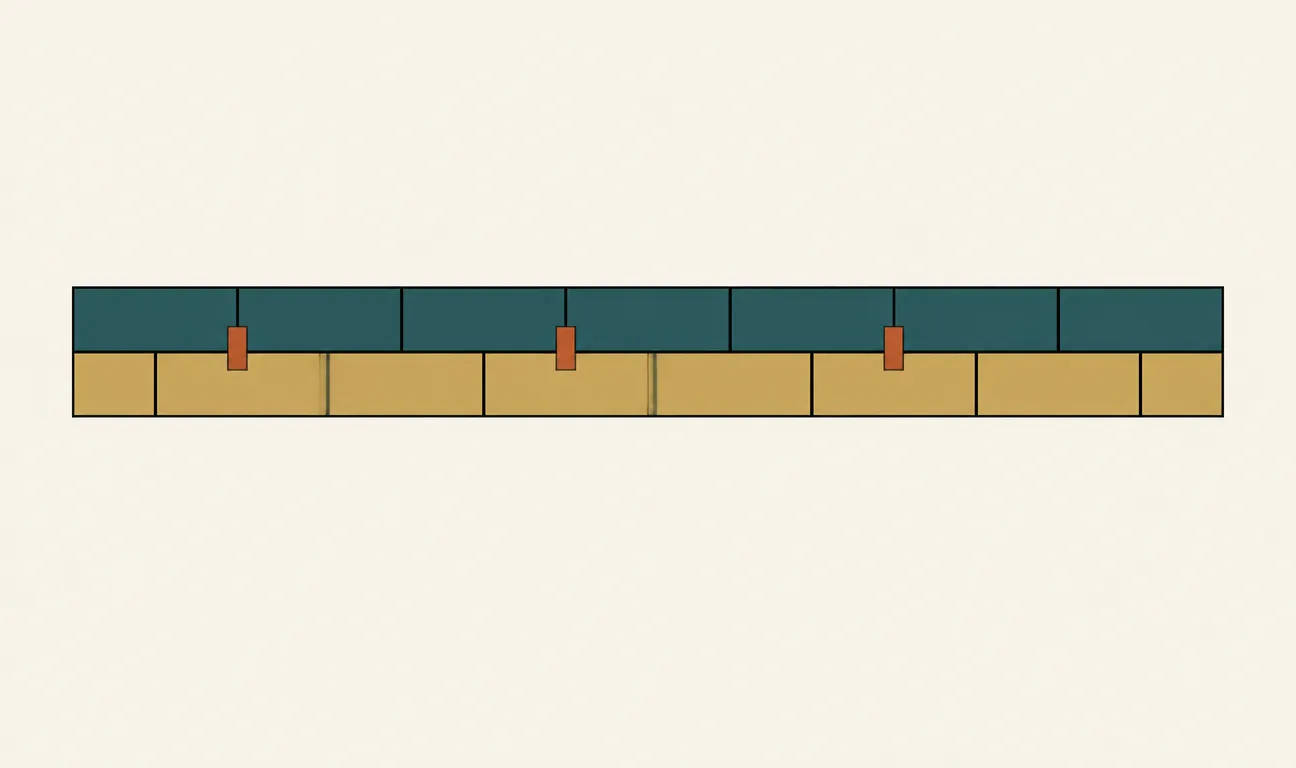
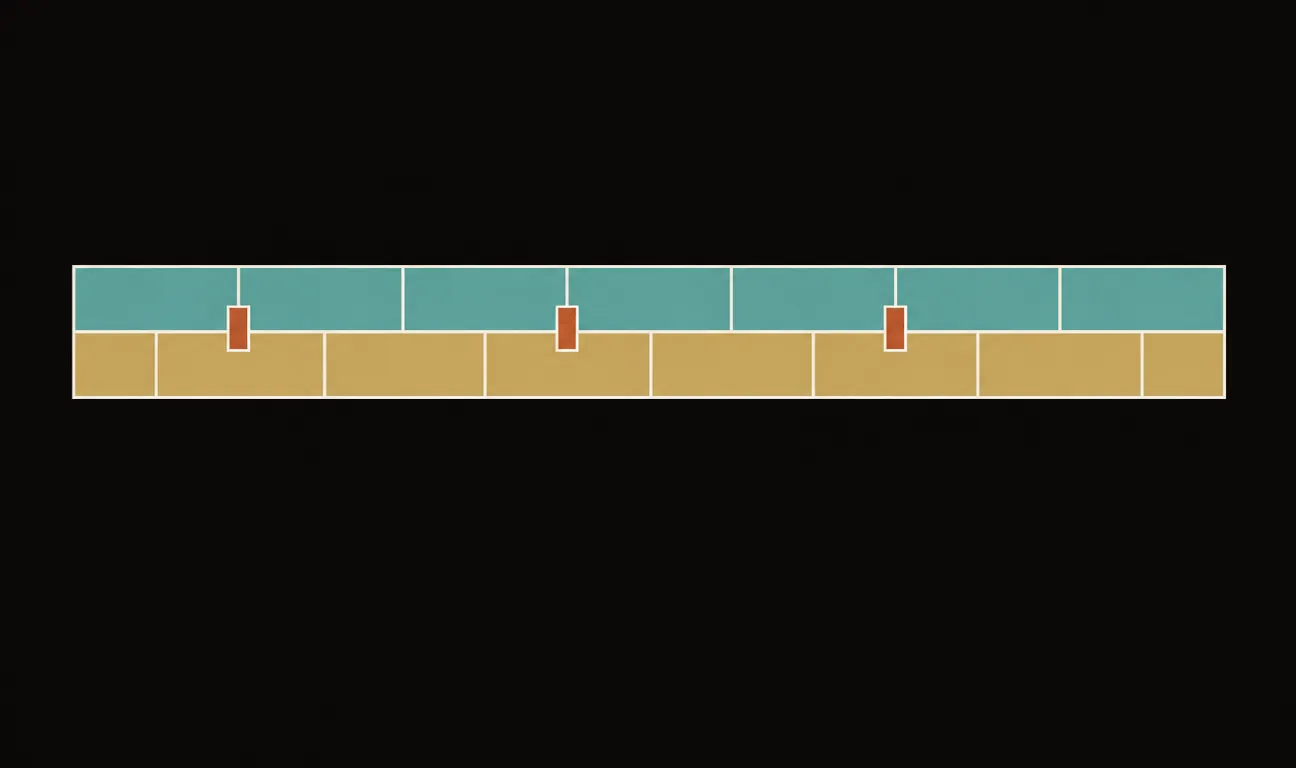
Il gruppo, nel paper, vale un quarto del contesto bersaglio: 2048 token per addestrare a 8192. La riga inferiore non fa più lavoro della superiore — cambia solo dove cadono i confini.
Quanto costava, prima
I modelli linguistici nascono con una finestra decisa in fabbrica: 2048 token per LLaMA, 4096 per Llama 2. Allungarla non è una configurazione da cambiare, è un addestramento. E il conto sale in fretta, perché l’attenzione costa quadraticamente nella lunghezza: addestrare a 8192 token, scrivono gli autori, costa sedici volte quanto addestrare a 2048 nei soli strati di self-attention.
I numeri di chi ci aveva provato prima sono la parte più eloquente del paper. Position Interpolation aveva usato 32 GPU A100 per portare LLaMA da 2k a 8k, e 128 per i contesti più lunghi; Focused Transformer, 32 TPU per l’addestramento standard e 128 per LongLLaMA. Gli autori lo dicono senza giri di parole: sono risorse fuori portata per il ricercatore comune.
La via ovvia — un fine-tuning a basso rango, che tocca pochi parametri — non funziona. È la scoperta negativa da cui parte tutto il resto: su Llama 2 da 7 miliardi di parametri portato a 32768 token, il fine-tuning completo arriva a una perplexity di 8,08, mentre LoRA si ferma a 11,44. E alzare il rango non serve a niente: da 8 a 256 il numero peggiora appena, da 11,44 a 11,98. Il divario non è una questione di capacità del rango.
Qui diamo per noto che cos’è LoRA: due matrici strette affiancate a un peso congelato, che imparano al posto suo. Il libro lo costruisce nel capitolo sul post-addestramento, insieme al resto di ciò che succede a un modello dopo il pre-training.
Il meccanismo: spezzare, e sfalsare metà
La prima mossa è la più naturale, ed è quella che da sola fallisce. Se il costo è quadratico, si spezza la sequenza in gruppi e si calcola l’attenzione dentro ciascuno: per un contesto di 8192 token, quattro gruppi da 2048. Il costo passa da $O(n^2)$ a $O(n \cdot g)$, con $g$ la dimensione del gruppo — a parità di contesto, un risparmio di un fattore quattro.
Il difetto è quello dei correttori di bozze: fra un gruppo e l’altro non passa niente. La misura lo mostra con precisione — con i soli gruppi allineati la perplexity peggiora man mano che il contesto cresce (8,29 a 8192, 8,83 a 16384, 9,47 a 32768), mentre il riferimento a piena attenzione resta piatto intorno a 8,0.
La seconda mossa costa zero e ripara il difetto. Le teste di attenzione si dividono in due metà: la prima usa i gruppi come stanno, la seconda li usa spostati di mezzo gruppo. Nell’esempio del paper, per il pattern sfalsato il primo gruppo non va più da 1 a 2048 ma da 1025 a 3072 — con la conseguenza, meno ovvia, che i primi 1024 token e gli ultimi 1024 finiscono nello stesso gruppo. Ogni cucitura del primo schema cade in mezzo a un gruppo del secondo, e l’informazione attraversa senza che nessuno calcoli un prodotto scalare in più.
Con lo sfalsamento la perplexity torna a 8,04 / 8,03 / 8,08 sui tre contesti: praticamente la piena attenzione, a un quarto del costo. Gli autori dichiarano che l’implementazione sta in due righe di PyTorch — una roll sulla dimensione dei token per metà delle teste, e la stessa roll all’indietro sull’uscita — e nel testo segnalano da soli che lo spostamento può introdurre una fuga di informazione, correggibile con una piccola modifica alla maschera di attenzione.
L’asimmetria che rende il metodo usabile
Il pezzo che distingue LongLoRA da vent’anni di attenzioni approssimate è che l’approssimazione vive solo durante l’addestramento. Il modello che ne esce ha l’architettura di partenza, con l’attenzione piena, e si serve con l’infrastruttura di sempre: Flash-Attention 2 compreso, dichiarato compatibile in addestramento e in inferenza.
Non è un dettaglio di comodità, è ciò che gli altri schemi sparsi non riescono a fare. Il paper li mette alla prova tutti nella stessa condizione — addestrati con lo schema sparso, valutati con l’attenzione piena — e i risultati si separano nettamente. L’attenzione sfalsata arriva a 8,12; l’attenzione dilatata a 11,78; quella a passo fisso a 24,03, cioè si rompe. La ragione che gli autori danno è semplice: l’attenzione a gruppi somiglia a quella che il modello ha visto in pre-addestramento, le altre no. E lo sfalsamento impedisce al modello di specializzarsi su uno schema particolare.
La seconda scoperta: due strati che nessuno addestrava
Resta il divario di LoRA, che lo sfalsamento non tocca. La cura è sorprendente per quanto è piccola: rendere addestrabili anche gli strati di embedding e di normalizzazione. Nel Llama 2 da 7 miliardi gli embedding sono meno del 2% dei parametri e le normalizzazioni lo 0,004% — quattro millesimi di punto percentuale.
La progressione, sempre a 32768 token: LoRA da sola 11,44; con la sola normalizzazione addestrabile 10,49; con i soli embedding 8,29; con entrambi 8,12, contro l’8,08 del fine-tuning completo. Un divario di quattro centesimi, ottenuto sbloccando una frazione trascurabile dei pesi.
Che cosa si ottiene, in concreto
Su una singola macchina con otto A100, LongLoRA porta il modello da 7 miliardi a 100 000 token di contesto, quello da 13 miliardi a 65 536 e quello da 70 miliardi a 32 768. Rispetto al fine-tuning completo la memoria scende fino a 1,8 volte, e rispetto a LoRA la velocità di addestramento sale fino a 1,8 volte; alle lunghezze maggiori il fine-tuning completo, semplicemente, esaurisce la memoria.
La prova più interessante non è però la perplexity. Nel compito di recupero di un argomento dentro una conversazione lunghissima, il modello da 13 miliardi ottiene 1,00 / 0,98 / 0,98 / 0,98 / 0,94 sui contesti da 3k a 16k — sostanzialmente alla pari con LongChat-13B, che era lo stato dell’arte e che però era stato interamente riaddestrato su conversazioni lunghe raccolte apposta. Per confronto, ChatGLM2-6B crolla a 0,02 già a 10k.
C’è poi la prova del numero nascosto: si sotterra una passphrase casuale in un documento lungo e si chiede al modello di ritrovarla. Il modello addestrato a 32 768 token non perde colpi fino a 33k-34k, cioè fino a superare il contesto su cui è stato addestrato; Llama 2 senza trattamento crolla di netto oltre i 4k. Ed estendendo la sola interpolazione posizionale a 48k, senza un minuto di addestramento in più, il modello mantiene un’accuratezza fra il 60% e il 90% nella fascia 33k-45k.
Una precisazione, perché il compito è spesso citato con il nome sbagliato: questo è passkey retrieval, non il «needle in a haystack» diventato popolare dopo. Si cerca un numero casuale in un testo di riempimento ripetitivo, non un fatto dentro una prosa vera. È una misura di accesso, non di comprensione — utile e molto più facile.
Dove il metodo non arriva
Gli autori dichiarano un peggioramento della perplexity sui contesti brevi nei modelli estesi, e lo attribuiscono a un limite noto dell’interpolazione posizionale: si guadagna in lunghezza e si paga un po’ vicino a casa. Chi estende un modello per un uso misto dovrebbe misurarlo, non darlo per trascurabile.
Il gruppo non si può stringere a piacere. L’ablazione mostra che a un mezzo e a un quarto del contesto bersaglio il divario dalla piena attenzione è minimo, mentre sotto un quarto comincia a farsi sentire: a 8192 token si passa da 8,04 con gruppi da un quarto a 8,16 con gruppi da un ottavo. Il risparmio ha un fondo.
E resta la domanda che nessuna di queste tabelle risponde. La perplexity misura quanto il modello è sorpreso dal token successivo, e il recupero di una passphrase misura se un’informazione è raggiungibile: nessuna delle due dice se il modello usa davvero centomila token quando ragiona. È il limite di tutta la letteratura sul contesto lungo di quegli anni, non di questo lavoro in particolare — ma vale la pena tenerlo separato dalle promesse.
Il contesto lungo, prima di essere una capacità dei modelli, è stato per due anni una questione di quante GPU si avevano.
La posta in gioco è tutta qui, e spiega perché un paper del 2023 che parla di Llama 2 continui a essere letto. Le tecniche cambiano — le interpolazioni posizionali sono state riscritte più volte da allora — ma la mossa di LongLoRA è di quelle che restano: approssimare dove costa, in addestramento, e restituire l’esatto dove conta, all’inferenza. E il risultato pratico è che estendere un modello aperto è passato dall’essere una decisione di bilancio all’essere un pomeriggio di lavoro su una macchina che si affitta a ore.
Il paper
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han, Jiaya Jia, LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models, arXiv:2309.12307, settembre 2023 (versione 2, dicembre 2023). Codice, modelli e il dataset LongAlpaca: github.com/dvlab-research/LongLoRA.
I commenti sono riservati agli iscritti.
Accedi per commentare