Il motivo per cui puoi comprare un tostapane senza sapere da quale centrale arriva la corrente è che fra i due c’è una presa standard. Il reinforcement learning ha la sua: l’interfaccia di Gymnasium, cinque metodi in croce, grazie a cui un algoritmo scritto per far equilibrare un’asta funziona senza modifiche su un problema di logistica.
Questo tutorial fa il giro completo in due direzioni. Prima usa l’interfaccia per risolvere CartPole con un DQN scritto a mano — il minimo che impara davvero, senza librerie di algoritmi. Poi la percorre al contrario: prende un problema qualsiasi e lo veste da ambiente, che è il passaggio con cui l’RL smette di essere un esercizio sui videogiochi.
L’interfaccia, in cinque righe
pip install "gymnasium[classic-control]" torchimport gymnasium as gym
env = gym.make("CartPole-v1")
osservazione, info = env.reset(seed=0)
for _ in range(1000):
azione = env.action_space.sample() # qui andrà la politica
osservazione, ricompensa, terminato, troncato, info = env.step(azione)
if terminato or troncato:
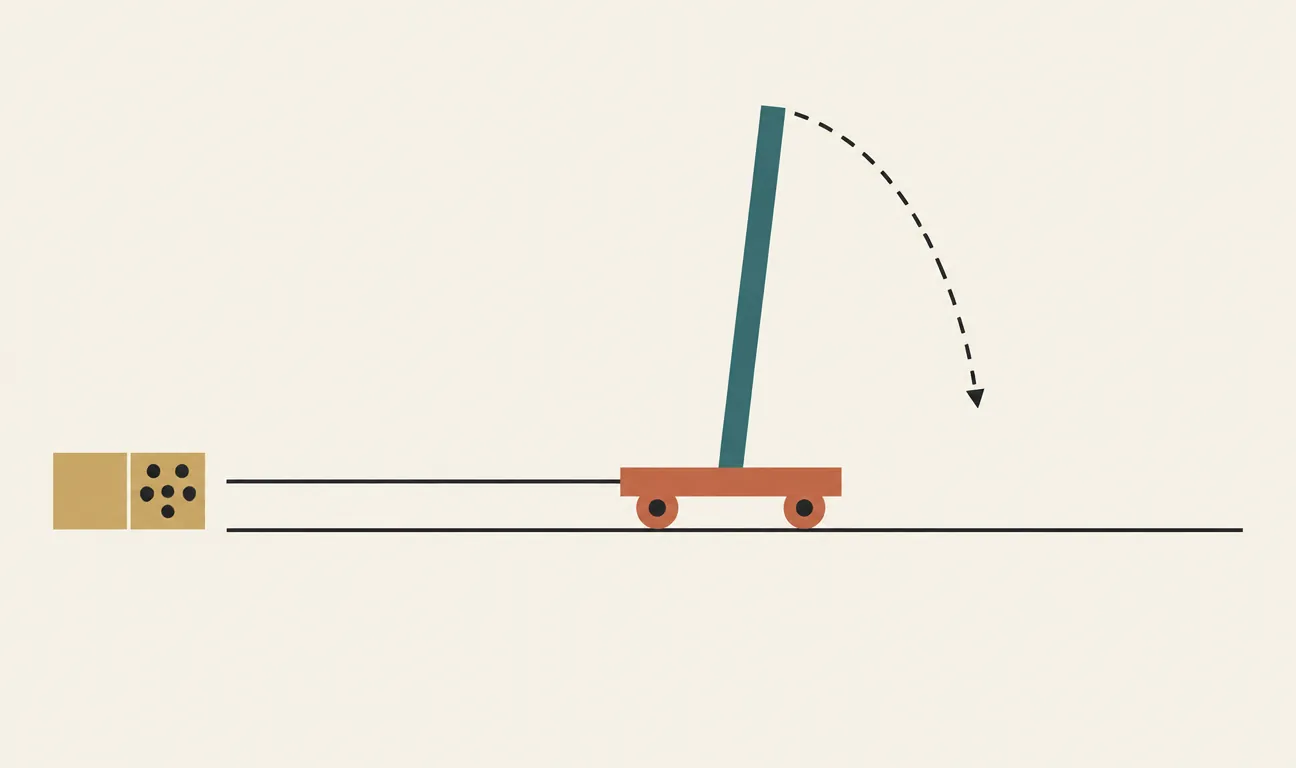
osservazione, info = env.reset()CartPole è un carrello su una rotaia con un’asta incernierata sopra, da tenere in equilibrio spingendo a destra o a sinistra. L’osservazione è un vettore di quattro numeri — posizione e velocità del carrello, angolo e velocità angolare dell’asta — e le azioni sono due: spingi a sinistra, spingi a destra. La ricompensa è +1 a ogni passo, compreso quello finale: sopravvivere è il punteggio.
L’episodio finisce in due modi diversi, e la distinzione è la cosa più importante di tutta la pagina. terminato è vero quando il problema è genuinamente concluso: l’asta ha superato i 12 gradi di inclinazione, o il carrello è uscito oltre 2,4 unità dal centro. troncato è vero quando si è raggiunto il limite di 500 passi imposto dall’ambiente — nella versione v1 quello è anche il punteggio massimo, e il tetto oltre cui il problema si considera risolto.
Il ciclo è simmetrico e banale; l’asimmetria sta sotto. Confondere le due colonne è l’errore che fa smettere di imparare un DQN altrimenti corretto.
Il DQN, in una pagina
Servono tre pezzi: una rete che stima il valore di ogni azione, una memoria da cui ripescare esperienze passate, e una copia congelata della rete che fornisce un bersaglio stabile.
import random
from collections import deque
import torch
import torch.nn as nn
import torch.nn.functional as F

def rete_q(n_oss, n_az):
    return nn.Sequential(
        nn.Linear(n_oss, 128), nn.ReLU(),
        nn.Linear(128, 128), nn.ReLU(),
        nn.Linear(128, n_az),          # un valore per azione, non una probabilità
    )

q = rete_q(4, 2)
bersaglio = rete_q(4, 2)
bersaglio.load_state_dict(q.state_dict())
ott = torch.optim.AdamW(q.parameters(), lr=1e-3)
memoria = deque(maxlen=50_000)
GAMMA, BATCH = 0.99, 128
Il passo di apprendimento pesca un lotto dalla memoria e avvicina il valore stimato a quello che si osserva davvero: la ricompensa incassata, più il valore scontato del meglio che si può fare dallo stato successivo.
def passo_di_apprendimento():
    if len(memoria) < BATCH:
        return
    s, a, r, s2, fine = map(torch.stack, zip(*random.sample(memoria, BATCH)))

    valore = q(s).gather(1, a.unsqueeze(1)).squeeze(1)   # solo l'azione presa
    with torch.no_grad():
        futuro = bersaglio(s2).max(1).values
        atteso = r + GAMMA * futuro * (1 - fine)         # se è finita: solo r

    perdita = F.smooth_l1_loss(valore, atteso)
    ott.zero_grad(set_to_none=True)
    perdita.backward()
    nn.utils.clip_grad_value_(q.parameters(), 100)
    ott.step()
Qui si monta; perché servano proprio queste tre parti — perché una rete che insegue il proprio bersaglio diverge, e a che cosa serve rompere la correlazione fra esperienze consecutive — è il capitolo del libro sul DQN.
La riga che quasi tutti sbagliano
Nel codice qui sopra fine è la maschera che azzera il futuro. La tentazione — e il codice che si trova nella maggior parte dei tutorial — è scriverla così:
fine = terminato or troncato # SBAGLIATOSembra innocuo e non lo è. Su CartPole-v1 l’episodio viene troncato dopo 500 passi, cioè quando l’agente ha vinto. Trattare quel troncamento come una fine significa dire alla rete che dallo stato raggiunto al passo 500 non c’è più alcun valore futuro: si insegna all’agente che arrivare in fondo è un vicolo cieco, e il punteggio, dopo essere salito, comincia a scendere. È un guasto particolarmente insidioso perché si manifesta solo quando l’agente sta imparando bene.
fine = terminato                  # solo la fine vera azzera il futuro
memoria.append((
    torch.tensor(oss), torch.tensor(azione), torch.tensor(ricompensa, dtype=torch.float32),
    torch.tensor(oss2), torch.tensor(float(terminato)),
))
La separazione fra terminated e truncated esiste in Gymnasium proprio per rendere possibile questa distinzione: nella vecchia API di Gym c’era un solo flag done, e l’informazione andava perduta. Se stai leggendo codice che usa done, stai leggendo codice scritto prima che il problema fosse risolto.
Il tuo problema dentro l’interfaccia
La parte utile viene adesso. Un ambiente è una classe con due metodi e due dichiarazioni: che forma hanno le osservazioni, quali azioni esistono, come si ricomincia, cosa succede a ogni passo.
import numpy as np
from gymnasium import Env, spaces

class Magazzino(Env):
    def __init__(self, capienza=100):
        self.observation_space = spaces.Box(
            low=0.0, high=1.0, shape=(3,), dtype=np.float32)   # giacenza, domanda, giorno
        self.action_space = spaces.Discrete(4)                 # ordina 0, 10, 50, 100 pezzi
        self.capienza = capienza

    def reset(self, seed=None, options=None):
        super().reset(seed=seed)          # inizializza self.np_random: usalo per il caso
        self.giacenza = self.capienza // 2
        self.giorno = 0
        return self._osserva(), {}

    def step(self, azione):
        ordine = [0, 10, 50, 100][azione]
        domanda = int(self.np_random.poisson(20))
        venduto = min(self.giacenza + ordine, domanda)
        self.giacenza = min(self.giacenza + ordine - venduto, self.capienza)
        self.giorno += 1
        ricompensa = venduto * 3.0 - ordine * 1.0 - self.giacenza * 0.05
        return self._osserva(), ricompensa, False, self.giorno >= 180, {}
Tre dettagli che risparmiano ore. super().reset(seed=seed) non è cerimoniale: predispone self.np_random, e usare quello invece del modulo random globale è ciò che rende gli esperimenti riproducibili. Le osservazioni vanno normalizzate in un intervallo ristretto, perché una rete che riceve giacenze da 0 a 100.000 accanto a un giorno da 0 a 180 impara molto peggio. E qui non c’è nessuna fine vera — un magazzino non «finisce» — quindi terminato resta sempre falso e a chiudere l’episodio è il troncamento a 180 giorni: esattamente il caso in cui la maschera sbagliata farebbe danno.
Cosa portarti a casa
Il valore dell’esercizio non è avere un agente che tiene in piedi un’asta: quello lo fa una libreria in tre righe. È che dopo aver scritto queste due pagine, davanti a un problema aziendale si riesce a fare la domanda giusta — quali sono lo stato, le azioni e la ricompensa? — e a rispondere in codice.
La parte difficile del reinforcement learning quasi mai è l’algoritmo. È scrivere una funzione di ricompensa che premi quello che vuoi davvero, invece di quello che sai misurare.
Un avvertimento onesto per finire. Il magazzino qui sopra si risolve meglio con l’ottimizzazione classica, e lo stesso vale per la gran parte dei problemi aziendali che sembrano fatti per l’RL: se hai un modello del sistema, usarlo conviene. L’RL comincia a pagare quando il modello non c’è, l’ambiente cambia sotto i piedi e l’unico modo di sapere cosa succede è provare — e sapere riconoscere quel caso vale più di saper implementare il DQN.
I commenti sono riservati agli iscritti.
Accedi per commentare