C’è un tipo di collega che risponde a tutto con lo stesso tono sicuro: alle domande di cui sa la risposta e a quelle di cui non sa niente. Non mente — semplicemente non ha un modo di segnalare la differenza. È esattamente il comportamento di un classificatore che finisce con una softmax.
Il numero che esce da lì è una distribuzione fra le classi che il modello conosce: dice quale è la più plausibile delle tre, non se la domanda somigliasse a qualcosa che ha visto in addestramento. Una foto sfocata, un documento di un tipo mai incontrato, un sensore guasto: il modello risponde comunque, e risponde con convinzione.
Esiste un modo rapidissimo per farsi dare, insieme alla predizione, anche una misura di quanto sia instabile. Si chiama MC dropout, sta in dieci righe, e non richiede né riaddestrare né cambiare architettura.
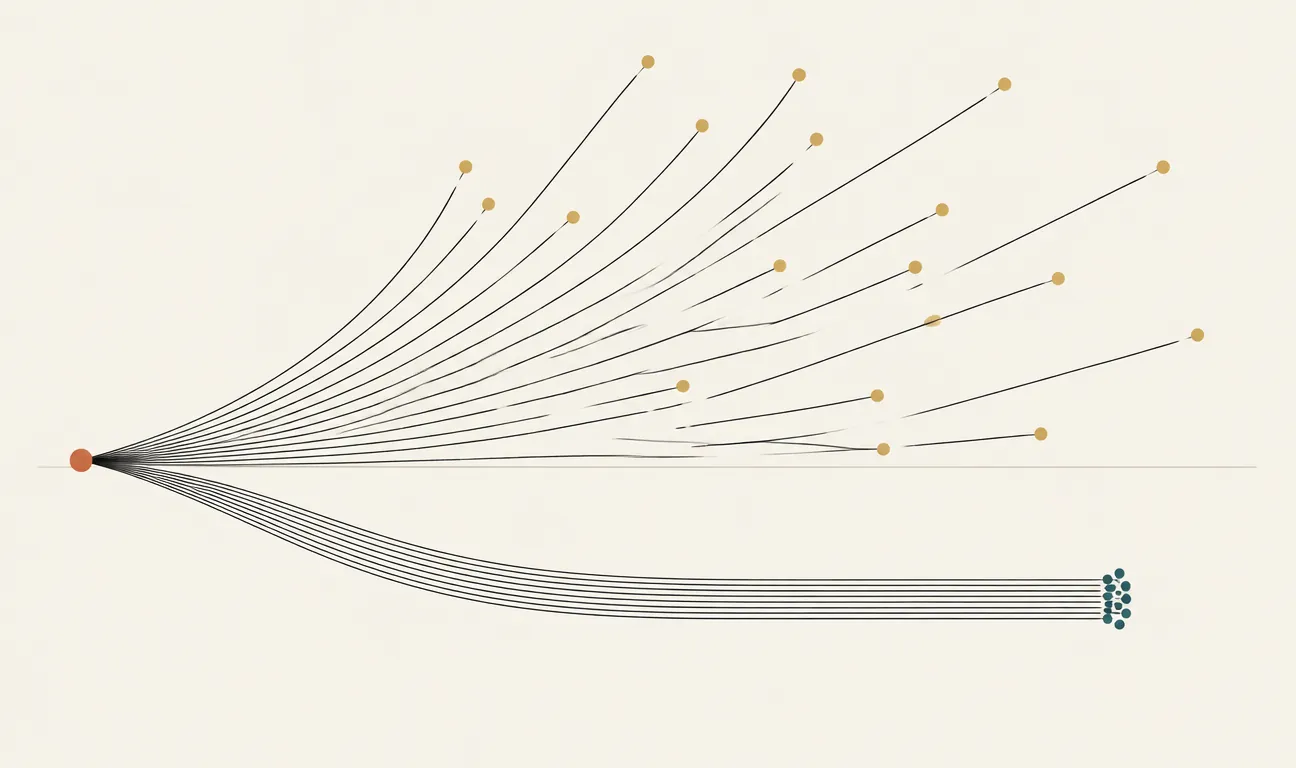
La media delle trenta passate è la predizione; la loro dispersione è l’informazione nuova. È quella che una singola passata, per costruzione, non può darti.
Le dieci righe
Il dropout normalmente si spegne in predizione: model.eval() lo disattiva, e giustamente, perché si vuole una risposta riproducibile. MC dropout fa il contrario di proposito: lo lascia acceso, esegue la predizione più volte, e guarda quanto le risposte si somigliano.
import torch
import torch.nn as nn

def attiva_dropout(modello):
    modello.eval()                       # tutto in modalità predizione…
    for m in modello.modules():
        if isinstance(m, nn.Dropout):    # …tranne il dropout
            m.train()

@torch.no_grad()
def mc_dropout(modello, x, passate=30):
    attiva_dropout(modello)
    logit = torch.stack([modello(x) for _ in range(passate)])
    p = torch.softmax(logit, dim=-1)
    return p.mean(0), p.std(0)           # predizione, e quanto è ballerina
La riga che sembra pedante e non lo è è la prima di attiva_dropout: si parte da eval() e si riaccende soltanto il dropout. La scorciatoia ovvia — modello.train() — funziona per il dropout e rompe tutto il resto.
La trappola: la batch normalization
Se nel modello c’è uno strato di batch normalization, metterlo in modalità di addestramento ha due conseguenze, entrambe indesiderate. La prima è che normalizza usando le statistiche del batch corrente invece di quelle accumulate: la predizione di un esempio comincia a dipendere da quali altri esempi gli stanno accanto nel lotto. La seconda è peggiore: aggiorna le medie correnti. Trenta passate di stima dell’incertezza modificano permanentemente i pesi del modello in produzione.
Non è un rischio teorico. Sullo stesso modellino, riaccendendo solo il dropout le medie correnti della batch norm restano bit per bit identiche e il contatore dei batch non si muove; chiamando modello.train() e facendo le stesse trenta passate, le medie correnti cambiano. Il modello non emette nessun errore: continua a rispondere, un po’ peggio, per sempre.
La ricetta poggia su un fatto che il libro spiega e che qui diamo per noto: il dropout equivale ad addestrare un’enorme famiglia di sotto-reti, e la rete piena in predizione non è la media di quella famiglia, ne è solo un’approssimazione. MC dropout smette di approssimare e la famiglia la campiona davvero.
Perché funziona, e che cosa non misura
L’idea viene da Yarin Gal e Zoubin Ghahramani (2015, poi ICML 2016), che hanno mostrato come l’addestramento con dropout si possa leggere come inferenza bayesiana approssimata in processi gaussiani profondi. La conseguenza pratica, scritta nel titolo del loro lavoro: l’informazione sull’incertezza è già dentro i modelli che addestriamo da anni, e la stavamo buttando via in predizione.
Detta senza formalismo: ogni passata con dropout è una sotto-rete diversa, pescata a caso. Dove il modello ha visto molti esempi, tutte le sotto-reti hanno imparato la stessa cosa e concordano. Dove non ha visto niente, ognuna estrapola a modo suo, e le risposte si sparpagliano.
Tre limiti da dichiarare, perché il metodo viene spesso venduto per più di quello che è.
Misura un tipo di incertezza, non l’incertezza. Coglie il fatto che il modello sia poco vincolato dai dati in quella zona. Non coglie il rumore intrinseco del problema: se due classi sono genuinamente indistinguibili da quelle feature, tutte le sotto-reti saranno d’accordo nell’essere incerte, e la dispersione resterà bassa.
Non è un rilevatore di fuori-distribuzione. Aiuta, e su ingressi bizzarri la dispersione sale spesso; ma esistono ingressi lontanissimi dai dati su cui il modello è compattamente sicuro e sbagliato. Chi ha bisogno di garanzie deve guardare altrove.
Dipende da dove hai messo il dropout. Un modello con un solo strato di dropout appena prima dell’uscita dà una dispersione che riguarda soltanto quell’ultimo pezzo. Se il dropout è sparso su più strati la stima è più informativa — e questo si decide in addestramento, non dopo.
Il costo, e come non pagarlo tutto
Trenta passate costano trenta volte una predizione, il che per un servizio a bassa latenza è proibitivo. Ma le passate sono indipendenti fra loro, quindi non serve farle in sequenza: si replica l’ingresso lungo la dimensione del batch e si fa una chiamata sola.
@torch.no_grad()
def mc_dropout_veloce(modello, x, passate=30):
    attiva_dropout(modello)
    n = x.shape[0]
    ripetuto = x.repeat_interleave(passate, dim=0)     # (n * passate, …)
    p = torch.softmax(modello(ripetuto), dim=-1)
    p = p.view(n, passate, -1)
    return p.mean(1), p.std(1)
Sulla GPU è quasi gratis finché il batch allargato ci sta in memoria, e questa versione è corretta proprio perché la batch normalization è rimasta in modalità di predizione: usa le statistiche accumulate, quindi le trenta copie non si contaminano a vicenda. Sul numero di passate: sotto le dieci la stima della dispersione è rumorosa, sopra le cinquanta si guadagna poco. Venti o trenta è l’intervallo dove quasi tutti si fermano.
Scegliere la soglia guardando i dati
La dispersione non ha unità di misura interpretabili, quindi la soglia non si indovina: si legge da una curva. Si prende l’insieme di validazione, si ordina per incertezza crescente, e si guarda come cresce l’accuratezza man mano che si scartano i casi più incerti.
import numpy as np

media, dev = mc_dropout_veloce(modello, x_val)
incertezza = dev.max(dim=-1).values.numpy()       # quanto balla la classe prevista
previsto = media.argmax(dim=-1).numpy()
corretto = (previsto == y_val)

ordine = np.argsort(incertezza)                   # dai più sicuri ai meno
for quota in (0.5, 0.7, 0.8, 0.9, 1.0):
    tenuti = ordine[: int(quota * len(ordine))]
    print(f"copertura {quota:.0%} → accuratezza {corretto[tenuti].mean():.3f}")
Il tabulato che ne esce è la conversazione da fare con chi possiede il processo, e non è una conversazione tecnica: «automatizzando il 70% dei casi l’accuratezza è del 98%, sul restante 30% decide una persona» è una frase che si può negoziare. «Il modello è accurato al 91%» non lo è. Se la curva è piatta — l’accuratezza non migliora scartando gli incerti — la misura non sta funzionando su quel problema, e vale la pena saperlo prima di costruirci sopra.
Cosa portarti a casa
Il valore non è avere un numero in più: è poter costruire una politica. Con una misura di dispersione si può scegliere una soglia, mandare a una persona la coda di casi incerti, e misurare quanto vale la pena farlo — accuratezza sul rimanente contro percentuale di casi passati a mano è una curva, e su quella curva si decide.
Un modello che sbaglia è un problema. Un modello che sbaglia senza saperlo è un problema che non puoi gestire.
Nella maggior parte dei sistemi in produzione questa è la differenza fra un’automazione che si può accettare e una che non si può: non «quanto è accurato», ma «sa dire quando non lo è». Dieci righe, mezz’ora di lavoro, e la trappola della batch norm da non calpestare.
I commenti sono riservati agli iscritti.
Accedi per commentare