
Chi ha usato un walkie-talkie conosce la regola: si preme il tasto, si parla, si dice «passo» e si lascia il canale all’altro. Finché uno trasmette, l’altro non può interromperlo, e se nel frattempo succede qualcosa di importante bisogna aspettare che finisca la frase. Il telefono ha risolto il problema decenni fa: due persone possono parlare e ascoltare nello stesso momento, accavallarsi, correggersi a metà. Gli ingegneri chiamano il primo canale half-duplex e il secondo full-duplex.
Gli assistenti multimodali di oggi, anche quelli che rispondono a voce e guardano la videocamera, sono in larga parte ancora walkie-talkie. È il punto di partenza di MiniCPM-o 4.5: Towards Real-Time Full-Duplex Omni-Modal Interaction, depositato su arXiv il 30 aprile 2026 (2604.27393). Lo firma il MiniCPM-o Team di OpenBMB, con Maosong Sun, Zhiyuan Liu e Yuan Yao come autori di riferimento. Pesi, codice e una demo sono pubblici.
Che cosa non funzionava
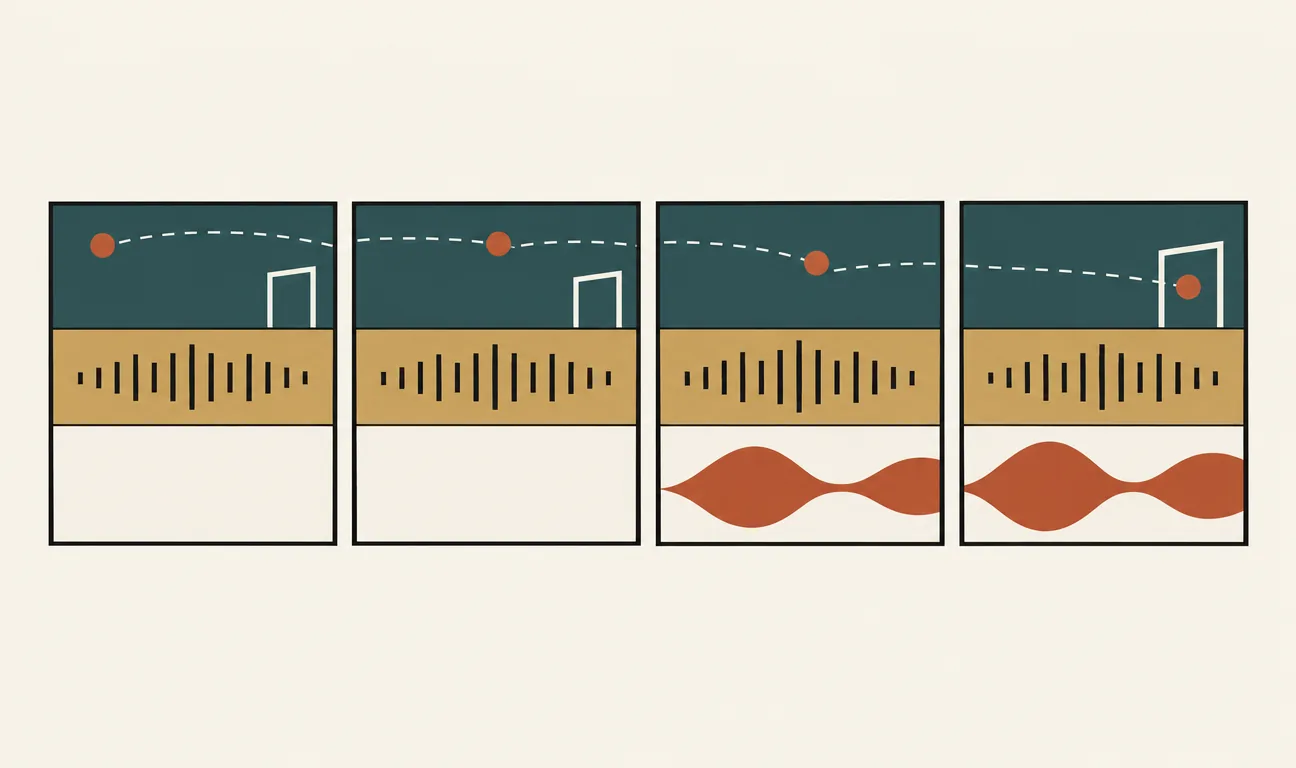
Secondo gli autori il collo di bottiglia non sta più soltanto in quante modalità un modello copre o in quanto è veloce a rispondere, ma nel modo in cui l’interazione è organizzata. I modelli attuali alternano due fasi, percepire e rispondere. Mentre parlano non guardano, o meglio: quello che arriva nel frattempo non entra nella risposta già avviata. Il paper lo chiama blocked I/O, con un esempio sportivo: il modello sta ancora descrivendo il giocatore in rosso che dribbla quando quello ha già tirato in porta.
Il secondo difetto è la passività. La maggior parte degli assistenti di oggi parla solo se interpellata: non avvisa, non commenta, non ricorda qualcosa perché la scena lo richiede. Per un aiuto che deve accompagnare una persona a lungo, mentre cucina o mentre guarda una partita, è un limite di fondo.
Omni-Flow: la conversazione a fette
La proposta si chiama Omni-Flow e prende l’idea dalla multiplazione a divisione di tempo delle telecomunicazioni. L’interazione viene tagliata in finestre di durata fissa $t$. In ciascuna il modello prima incorpora quello che è appena arrivato, poi produce la sua uscita. Se le finestre sono abbastanza corte, percepire e rispondere diventano in pratica simultanei.
I flussi sono tre, allineati sullo stesso asse temporale: quello che si vede (env-visual), quello che si sente (env-audio, che comprende la voce dell’utente quando c’è) e quello che il modello dice (out-stream). La scelta concettuale più interessante sta qui: la richiesta dell’utente non ha più un ruolo privilegiato, è solo un pezzo del mondo che il modello osserva e arriva per lo più dal canale audio. Per la $k$-esima finestra i token visivi $v_k$, quelli audio $a_k$ e quelli di uscita $o_k$ formano un gruppo, e la conversazione diventa una sequenza unica che un normale modello causale può leggere:
$$g_k = [\,v_k;\ a_k;\ o_k\,], \qquad S = g_1\, g_2 \cdots g_k \cdots$$
Quando non c’è niente da dire, $o_k$ contiene solo un token speciale, [listen]. Decidere se parlare diventa quindi una predizione come le altre, fatta a ogni finestra: è da qui che nasce il comportamento proattivo, ed è per questo che il sistema dipende meno da un rilevatore di attività vocale esterno che decida quando l’utente ha finito.
Le scelte di progetto non sono state fatte a occhio: il paper riporta un’ablazione su tre assi. Finestre da 1 secondo battono quelle da 0,2 e 0,1 secondi su tutti e cinque i test dell’ablazione: su MMLU il punteggio è 0,65 con finestre da 1 secondo, 0,45 con 0,2 secondi e 0,32 con 0,1, perché in una fetta troppo sottile il modello non ha abbastanza informazione per decidere in modo stabile. Segnare esplicitamente il confine fra un gruppo e l’altro aiuta in quattro test su cinque. E separare le due decisioni, prima se parlare e poi che cosa dire, vince anch’esso quattro test su cinque contro l’alternativa di fonderle in un’unica scelta fra [listen] e il primo token di testo.
Com’è fatto
Lo scheletro è un assemblaggio di pezzi noti, collegati però da stati nascosti a livello di token, in modo che il gradiente attraversi tutto il sistema durante l’addestramento: circa 9 miliardi di parametri addestrabili (9,34 in appendice). Le immagini passano da un encoder SigLIP da 0,4 miliardi e da un resampler che comprime ogni tassello da 1024 token a 64, un rapporto di 16 a 1 contro il 4 a 1 più comune. L’audio entra da un encoder Whisper Medium a 50 vettori al secondo, ridotti a 10 da un piccolo MLP. Al centro c’è Qwen3-8B.
Che cosa fa un encoder visivo, perché serve un proiettore fra lui e il modello linguistico e quanto costano i token delle immagini: l’innesto della vista su un LLM è raccontato nel libro.
La scelta che conta è sulla voce. Alcuni modelli recenti fanno generare i token audio direttamente al modello grande, a circa 25 al secondo: è lento e, secondo la letteratura che il paper cita, tende a erodere le capacità linguistiche. Qui il modello centrale scrive solo testo, 3 o 4 passi al secondo, cioè il ritmo del parlato umano. Un decoder vocale separato e leggero, da circa 0,3 miliardi, riceve ogni token di testo insieme allo stato nascosto del modello grande, che porta con sé le decisioni su intonazione e stile, e produce token audio; un decoder a flow matching li trasforma in forma d’onda, con la voce presa da un campione di riferimento nel prompt. È anche il modo in cui il modello clona una voce.
Come si passa da un testo a una voce sintetica, e che cosa sono i token che un modello di sintesi produce: il capitolo sulla sintesi vocale ricostruisce la catena.
Parlare in tempo
Resta un problema sottile. Il testo scritto in un secondo può richiedere molto più di un secondo per essere pronunciato, e la voce finisce per restare indietro rispetto a ciò che il modello ha già capito: si sente una frase pensata molto prima. Le soluzioni esistenti o fanno correre il testo molto avanti, o fissano un rapporto costante fra token di testo e token audio. Gli autori propongono TAIL (Time-Aligned Interleaving): a ogni finestra il modello decide quanto testo generare guardando il ritardo accumulato, e se la voce è rimasta indietro scrive meno per lasciarla recuperare. Un piccolo margine di anticipo è comunque ammesso: gli ultimi token di ogni finestra vengono pronunciati in quella dopo, perché la pronuncia di una parola dipende da quella che segue, come l’inglese «the» davanti ad «apple» o a «car».
I numeri
Visione. Sulla media OpenCompass, otto benchmark visione-linguaggio, in modalità istruzioni il modello resta di poco sotto Gemini 2.5 Flash e sta sopra InternVL3.5-8B, Qwen3-VL-8B e Qwen3-Omni-30B-A3B, che è molto più grande.
| Modello | Media |
|---|---|
| Gemini 2.5 Flash | 78,5 |
| MiniCPM-o 4.5 | 77,6 |
| Qwen3-VL-8B | 76,5 |
| InternVL3.5-8B | 75,8 |
| Qwen3-Omni-30B-A3B | 75,7 30 miliardi di parametri, 3 attivi per token |
Resta però ultimo fra i modelli confrontati su MMMU (67,6 contro 76,3 di Gemini) e indietro sul video lungo (LVBench 50,9 contro 62,2 di Gemini e 58,0 di Qwen3-VL). Il risultato più netto è sulla lettura di documenti: su OmniDocBench, dove l’errore va minimizzato, 0,109 in inglese contro lo 0,214 di Gemini 2.5 Flash.
Audio e video insieme. Su sette benchmark in cui video e audio sono allineati nel tempo, valutati però a turni, è primo in cinque, con lo scarto più ampio su Video-Holmes (64,3 contro 51,3 di Gemini e 50,4 di Qwen3-Omni); resta dietro su FutureOmni e Video-MME-Short con audio.
Full-duplex. Su LiveSports-3K-CC, telecronaca continua di azioni sportive, ottiene una percentuale di vittorie di 54,4 contro 45,6 di StreamingVLM e 41,5 di LiveCC.
Voce. Nella sintesi, fra i tre modelli confrontati, ha l’errore più basso su SeedTTS in cinese (CER 0,86) e in inglese (WER 2,38) e regge molto meglio i testi lunghi in inglese (WER 3,37 contro 14,80 di CosyVoice2 e 17,33 di Qwen3-Omni); sui testi lunghi in cinese resta dietro CosyVoice2 (CER 6,58 contro 5,27).
Costo. Su una singola RTX 4090 con vLLM, quantizzato a 4 bit, genera 212,3 token al secondo occupando 11 GB, contro 147,8 token e 20 GB di Qwen3-Omni, misurati su compiti di solo testo; in bf16 Qwen3-Omni non ci sta proprio. Con llama.cpp-omni, il motore d’inferenza che gli autori hanno costruito per la modalità in streaming, il fattore di tempo reale, sempre a 4 bit sulla 4090, scende a 0,21 (1,26 con PyTorch): un secondo di interazione si elabora in circa un quinto di secondo.
Che cosa il paper non dimostra
Il full-duplex vero è misurato solo a metà. L’unico benchmark full-duplex della tabella è senza audio: il modello guarda e commenta, ma nessuno gli parla sopra. Gli autori lo dicono, citando la scarsità di benchmark adatti, e rimandano alla demo; anche i sette test audio-video sono condotti a turni. La capacità che dà il titolo al paper, vedere, ascoltare e parlare insieme, è documentata con esempi qualitativi, non con un numero.
La voce migliore non è quella del full-duplex. Le cifre di sintesi riportate come risultato principale vengono dalla modalità con rapporto fisso fra testo e voce. Con TAIL, la modalità pensata per l’interazione in diretta, l’errore in inglese sale e finisce peggio anche della generazione senza interleaving e di Qwen3-Omni; in cinese il vantaggio regge (CER 1,04). Gli autori lo presentano come un compromesso ragionevole, ed è onesto che il paper riporti il dato; ma chi legge solo il riassunto non lo capisce.
| Modello e modalità | WER |
|---|---|
| MiniCPM-o, rapporto fisso fra testo e voce | 2,38 |
| MiniCPM-o, senza interleaving | 2,70 |
| Qwen3-Omni | 3,39 |
| MiniCPM-o con TAIL, per la diretta | 3,93 |
Il testo non è rimasto intatto ovunque. Contro Qwen3-8B, da cui parte, la media sui benchmark testuali sale di poco (82,1 contro 81,6), trainata soprattutto da BBH, ma su MMLU si scende da 81,7 a 77,0 e su MATH-500 da 84,0 a 77,0.
Un secondo è una granularità grossa. Le finestre più fini peggiorano il modello, quindi la reattività resta legata a fette da un secondo. E il «primo modello full-duplex omni-modale» è una rivendicazione degli autori, non una verifica esterna. Loro stessi elencano i limiti: robustezza da confermare nelle interazioni lunghe, voce talvolta instabile con pronunce sbagliate o inglese e cinese mescolati, una proattività ancora «relativamente semplice».
Perché conta adesso
MiniCPM-o 4.5 porta l’interazione full-duplex su un modello aperto che, quantizzato, sta in 11 GB e, con il motore degli autori, gira più veloce del tempo reale su una scheda da scrivania. La parte più duratura del lavoro non è però il punteggio: è l’idea di trattare il silenzio come un’uscita e la domanda dell’utente come un pezzo del mondo, dentro una sequenza qualsiasi. È una formulazione che chiunque può riprendere con un altro modello. Quanto un assistente del genere sia davvero utile, e quanto invece interrompa a sproposito, lo diranno benchmark con qualcuno che parla sopra al modello. Oggi ce ne sono pochi, e il paper ha il merito di dirlo.
I commenti sono riservati agli iscritti.
Accedi per commentare