
Immaginate di smistare la posta di un condominio guardando dove sono appoggiate le buste sul tavolo, invece di leggere l’indirizzo. Quasi sempre funziona, perché chi le ha posate le ha raggruppate per scala. Ma basta che una busta del quinto piano sia scivolata in mezzo a quelle del piano terra e finisce nella cassetta sbagliata, e nessuno se ne accorge finché qualcuno non la cerca.
I modelli che ricostruiscono la geometria di una scena a partire da una sola fotografia fanno qualcosa di simile, sostiene un paper depositato su arXiv il 20 luglio 2026. Si intitola MoGe-3: Fine-Detail Monocular Geometry Estimation with Self-Guided Sparse Volumetric Refinement, lo firmano Lingyu Kong, Ruicheng Li e Ruicheng Wang (a pari merito), Sicheng Xu, Chengtang Yao, Jianfeng Xiang e Jiaolong Yang, fra Microsoft Research, Tsinghua e USTC. È il terzo modello della famiglia MoGe.
Il difetto che la mappa di profondità nasconde
Negli ultimi anni la stima della geometria da un’immagine sola è migliorata molto: modelli come Depth Anything, Depth Pro, UniDepth e i due MoGe precedenti restituiscono, per ogni pixel, una profondità o direttamente un punto 3D, spesso in metri veri. Guardata come immagine in scala di grigi, la mappa di profondità sembra ottima. Il guaio si vede quando la si ruota: una ringhiera diventa un nastro attorcigliato, un palo si spalma sullo sfondo.
Perché da una sola foto la profondità è ambigua, e che cosa sono mappe di profondità, parametri della camera e nuvole di punti, lo spiega il libro nel capitolo sulla geometria della visione.
La diagnosi del paper è architetturale. Quasi tutti questi modelli, qualunque sia la loro famiglia, decodificano la geometria 3D restando nel piano dell’immagine: decoder convoluzionali 2D, decoder di un VAE nei metodi a diffusione, teste MLP interrogate su coordinate 2D nei più recenti. In tutti i casi due pixel si scambiano informazione perché sono vicini nella foto, non perché sono vicini nello spazio. E ai bordi di un oggetto sottile le due cose divergono: il pixel del palo e quello del muro dieci metri dietro stanno uno accanto all’altro, e il decoder li media. È la busta del quinto piano finita nel mucchio sbagliato.
Che cosa cambia: il raffinamento esce dal piano
La soluzione di MoGe-3 non butta via il modello precedente. La prima metà parte dai pesi di MoGe-2, con encoder DINOv2, e dalla foto produce una mappa di punti grezza, cioè un punto 3D per pixel, più maschera di validità, normali e scala metrica. La novità è la seconda metà, che gli autori chiamano SSR, Self-Guided Sparse 3D Refiner: un raffinatore che lavora non sulla griglia dell’immagine ma su un insieme sparso di voxel costruito a partire dalla stima corrente.
Il primo passo è cambiare le coordinate. Ogni punto viene riscritto come
$$q_{ij} = \left(\frac{X_{ij}}{Z_{ij}},\ \frac{Y_{ij}}{Z_{ij}},\ \log Z_{ij}\right)$$
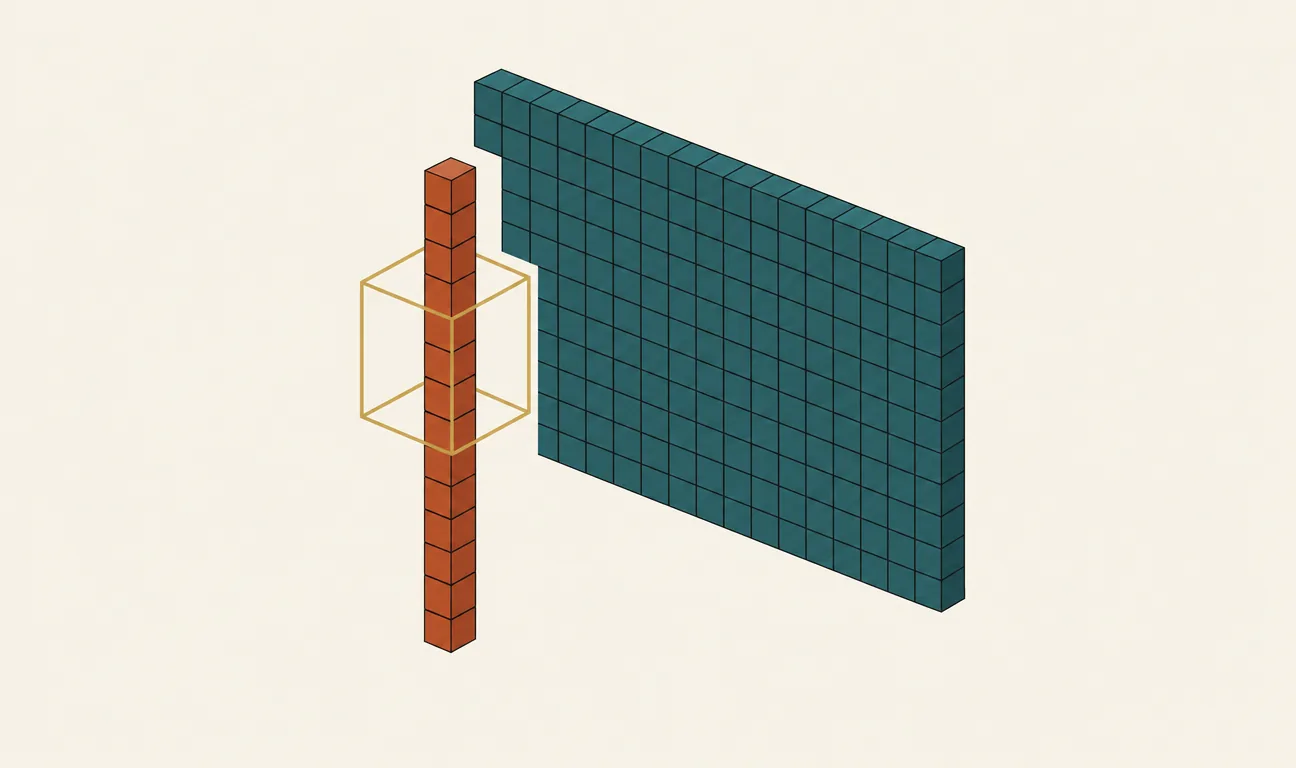
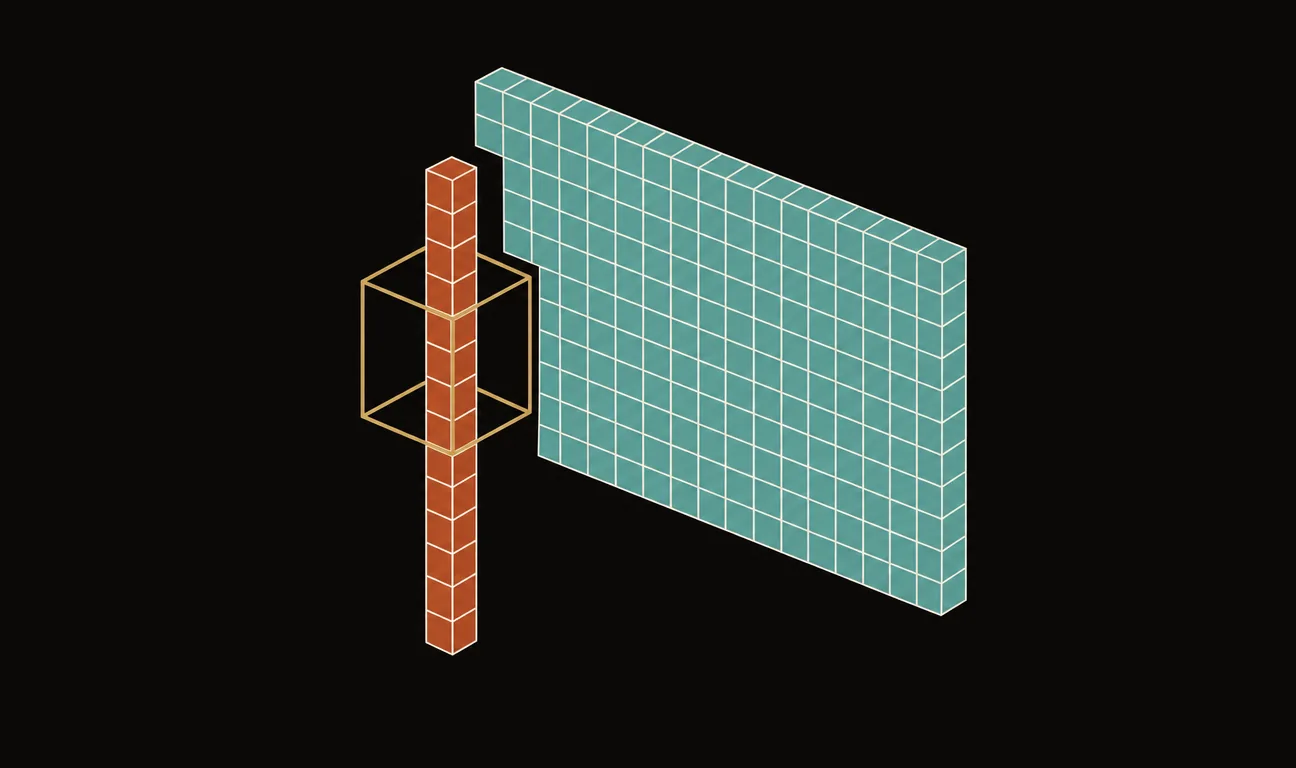
dove $i,j$ sono riga e colonna del pixel. Le prime due componenti restano fisse per tutto il processo: il raffinatore corregge solo la terza, la profondità in scala logaritmica $\zeta_{ij} = \log Z_{ij}$. Poi ogni pixel diventa esattamente un voxel, in posizione $c_{ij} = (i,\ j,\ \lfloor D\,\zeta_{ij} \rceil)$, con $\lfloor\cdot\rceil$ l’arrotondamento all’intero e $D$ la risoluzione lungo la profondità (200 nel modello finale). Il risultato è un guscio sottile, con tanti voxel occupati quanti sono i pixel, e con una proprietà che è il cuore del lavoro: due voxel sono vicini se e solo se i pixel sono adiacenti nella foto e le loro profondità logaritmiche differiscono al massimo di $1/D$. Con $D = 200$ significa, grosso modo, mezzo punto percentuale di differenza relativa nella profondità. Il palo e il muro finiscono in celle diverse e smettono di contaminarsi, come mostra la figura qui sopra.
Il logaritmo non è un vezzo: rende il guscio invariante alla scala. La stessa scena, ingrandita o rimpicciolita, produce lo stesso guscio con le stesse connessioni, perché la griglia misura la precisione relativa della profondità, non i metri.
Il guscio viene elaborato da una U-Net, la stessa architettura a encoder e decoder con connessioni di salto usata per la segmentazione, qui con convoluzioni 3D sparse al posto di quelle 2D. Com’è fatta una U-Net lo racconta il libro.
Su questo guscio lavora una U-Net sparsa: le convoluzioni toccano solo le celle occupate, quindi il costo cresce con i pixel e non con il volume. Nel collo della rete si iniettano le feature 2D di DINOv2, perché le coordinate da sole non sanno che cosa c’è nella foto: le celle che condividono la posizione nell’immagine ma hanno profondità diverse ricevono la stessa feature, e sono le convoluzioni 3D a decidere come usarla. L’uscita è un residuo $\Delta\zeta_{ij}$ da sommare alla profondità logaritmica.
E qui c’è la parte «auto-guidata». Aggiornata la profondità, si ricostruisce il guscio con le nuove posizioni e si ripete: ogni giro definisce i vicini del giro successivo, con bordi via via più precisi. L’addestramento usa tre giri; alla fine il punto si riporta nello spazio euclideo con $p_{ij} = e^{\zeta_{ij}}\,(u_{ij}, v_{ij}, 1)$. L’ultimo strato della U-Net parte da zero, così all’inizio il raffinatore restituisce la stima di MoGe-2 invariata e impara solo correzioni; per i primi 5.000 passi i gradienti non risalgono al modello base, perché, scrivono gli autori, gradienti grandi del raffinatore appena nato rovinerebbero una rappresentazione già buona. E il raffinatore impara solo da dati sintetici, dove la profondità è esatta al pixel, mentre il modello base continua a vedere anche i dati reali per non perdere la generalizzazione.
I numeri
Il confronto è zero-shot su nove benchmark, sintetici e reali, contro sette modelli recenti: Depth Pro, UniDepth V2, Depth Anything 3, UniK3D, Pixel-Perfect Depth, InfiniDepth e MoGe-2.
Il guadagno più grande è dove il paper lo cerca, sulle metriche locali: regioni piccole con strutture sottili, allineate una per una e giudicate con soglie severe (un punto è corretto se sbaglia di meno dell’1%). Sui punti come sulla profondità, MoGe-3 stacca il predecessore con entrambi i backbone.
| Metrica | MoGe-2 | MoGe-3 ViT-L | MoGe-3 ViT-G |
|---|---|---|---|
| Punti | 46,6% | 55,9% | 56,8% |
| Profondità | 47,1% | 52,5% | 54,1% |
Gli altri modelli confrontati restano tutti sotto i valori di MoGe-2. Una parte del salto, però, non viene dal raffinatore: il modello base riaddestrato insieme a lui, senza alcun giro di raffinamento, è già al 50,3% sui punti.
Sulle metriche globali il salto è più piccolo, sia sulle mappe di punti relative sia sulla profondità metrica.
| Metrica | MoGe-2 | MoGe-3 ViT-L | MoGe-3 ViT-G |
|---|---|---|---|
| Mappe di punti relative | 90,4% | 92,0% | 92,4% |
| Profondità metrica | 77,3% | 82,7% | 82,7% |
Rifinire i dettagli, dunque, non rovina l’insieme, ma il miglioramento globale viene quasi tutto dal riaddestramento: il ViT-L senza raffinamento fa già 92,0% sui punti relativi. E sulla profondità metrica il ViT-G ha un errore relativo medio (15,8) appena peggiore di MoGe-2 (15,6). Le tabelle in appendice aggiungono un dato che il testo non commenta: sulle mappe di punti metriche MoGe-3 fa un po’ peggio di MoGe-2 (91,6% e 91,2% entro soglia contro 92,0%).
Sui bordi, misurati con un F1 sulle discontinuità di profondità, MoGe-3 non vince. InfiniDepth è primo con 19,3; il ViT-G fa 17,3; il ViT-L 16,0, poco sotto Depth Pro (16,3), che però lavora a 1536 pixel di lato contro 840. Gli autori obiettano, con qualche ragione, che è una misura 2D.
L’esperimento più convincente è un’ablazione, fatta con il modello base congelato. A parità di parametri, sostituire la U-Net sparsa 3D con una U-Net 2D sulla griglia densa non migliora i dettagli: la quota di punti corretti resta a 47,0%, contro il 46,6% del modello base, e sulla profondità scende da 47,1% a 45,0%. La versione 3D, nelle stesse condizioni, arriva a 55,1%. Non è la capacità in più a fare il lavoro, è il modo di definire i vicini. Anche la risoluzione conta, e in un modo non ovvio: passare da $D = 100$ a 200 aiuta, spingersi a 400 peggiora sia i dettagli sia l’insieme: secondo gli autori, i voxel diventano così fini che le celle occupate si diradano e le convoluzioni hanno poco su cui lavorare.
Il prezzo è il tempo. Su una A100 in FP16 a 700 pixel di lato, MoGe-2 impiega 39 millisecondi a immagine. MoGe-3, con tre giri, ne impiega 121 con il ViT-L, circa tre volte tanto, e 177 con il ViT-G, più di quattro volte. Il ViT-L resta più rapido degli altri quattro metodi misurati nel paper, misurati ciascuno alla propria risoluzione fra 133 e 275 millisecondi; il ViT-G batte solo Depth Anything 3 e Pixel-Perfect Depth. Un dettaglio utile per chi lo userà: addestrato con tre giri, il modello regge fino a sette senza degradare, e i guadagni si fermano verso il quinto.
Che cosa resta da verificare
I numeri più forti poggiano su due dataset sintetici. Le metriche locali, quelle dove MoGe-3 stacca tutti, sono calcolate solo su Spring e Synth4K, perché servono profondità dense e precise che i dataset reali non hanno. E le maschere che scelgono le regioni «fini» sono prodotte da una pipeline automatica degli autori stessi. Sulle foto vere le tabelle misurano solo la geometria d’insieme e i bordi; per i dettagli fini restano le figure qualitative.
Il confronto con due rivali è indiretto. Pixel-Perfect Depth e InfiniDepth non stimano i parametri della camera, e per trasformarne la profondità in punti 3D gli autori usano quelli stimati da MoGe-2. È una scelta ragionevole, ma un errore di quei parametri ricade sui rivali, non su MoGe-3.
Il limite dichiarato è strutturale. MoGe-3 resta un modello di regressione: sui pixel di confine, dove il colore appartiene un po’ all’oggetto e un po’ allo sfondo, produce una media, e quindi punti sospesi nel vuoto fra i due (i fly-points). Gli autori indicano come via d’uscita l’innesto di una formulazione generativa, come quella di Pixel-Perfect Depth. Quanto al codice, dal 18 agosto il repository ufficiale microsoft/MoGe pubblica MoGe-3 con licenza MIT e i pesi dei due modelli su Hugging Face; non gira su macOS, perché dipende da una libreria basata su Triton.
Perché conta adesso
La stima della geometria da una foto sola è diventata un componente di base: la usano la sintesi di nuove viste, la realtà aumentata, i robot che devono afferrare oggetti. E in quasi tutti questi usi quello che serve non è una mappa di profondità bella da vedere, ma una nuvola di punti che resti in piedi quando la si guarda di lato. MoGe-3 sposta l’attenzione da «quanto è nitida l’immagine della profondità» a «chi è vicino a chi». Resta da vedere quanto il vantaggio regga fuori dai dati sintetici e quanto pesi, in un robot, triplicare la latenza. Ma l’idea di fondo, cioè che le buste si smistano leggendo l’indirizzo, è di quelle che è difficile rimettere nel cassetto.
I commenti sono riservati agli iscritti.
Accedi per commentare