
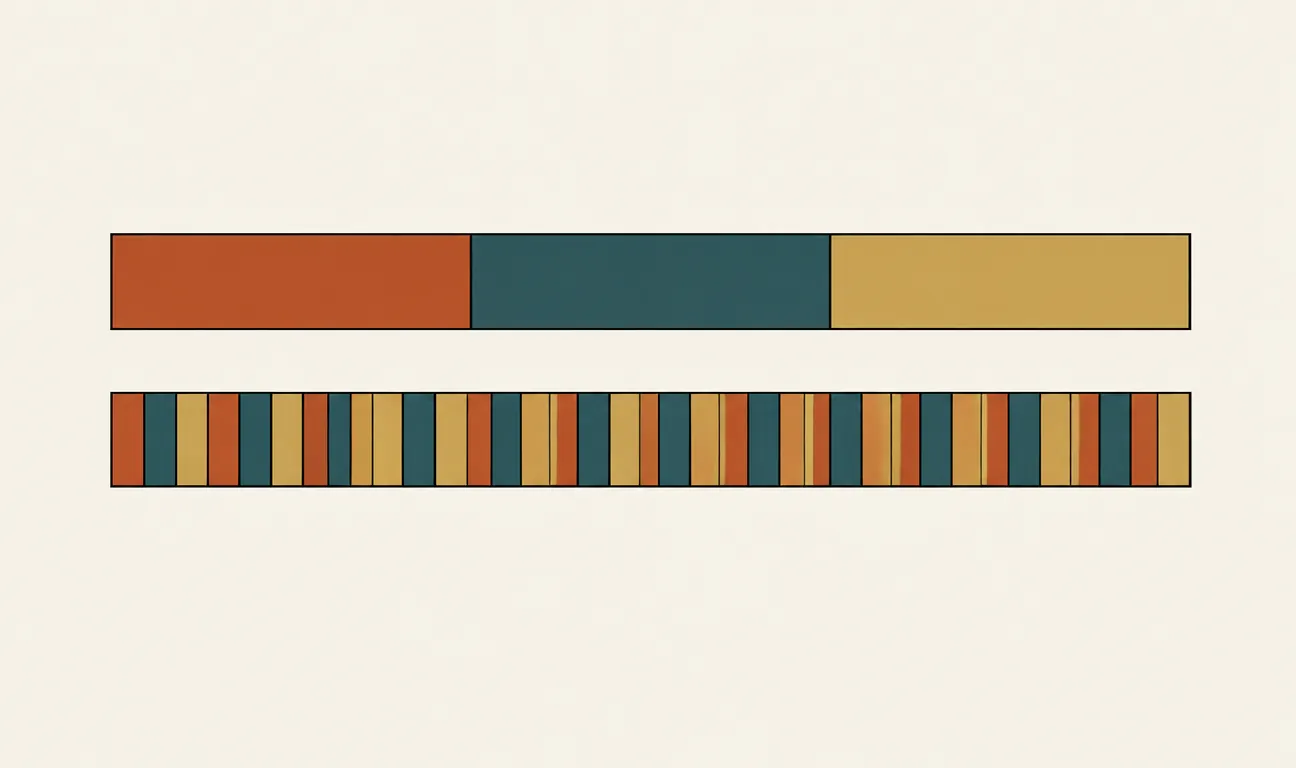
Prendi una frase qualunque e passala a un tokenizer di un LLM commerciale. «The cat is on the table»: sei parole, in genere sei token. Ora la sua traduzione: «Il gatto è sopra il tavolo». Sei parole anche qui, ma il conteggio dei token quasi sempre sale — sette, otto, a volte di più a seconda del modello. Su una frase la differenza è spiccioli. Su un’applicazione che processa milioni di richieste al mese, è una voce di bilancio. E la domanda sorge spontanea: perché la mia lingua costa più della tua?
Il token non è una parola
Il primo malinteso da smontare: un LLM non legge parole, legge token. Un token è un frammento di testo — può essere una parola intera, un pezzo di parola, un segno di punteggiatura, perfino un singolo carattere. La suddivisione la decide il tokenizer, un componente addestrato prima del modello vero e proprio, con un algoritmo della famiglia BPE (Byte Pair Encoding) o simili.
L’idea di BPE è semplice: si parte dai caratteri e si fondono progressivamente le coppie di simboli più frequenti nel corpus di addestramento, fino a costruire un vocabolario di dimensione fissa — tipicamente tra 32.000 e 200.000 voci. Le sequenze che compaiono spesso diventano un token unico; quelle rare restano spezzate in frammenti.
Un’analogia concreta: pensa alla stenografia. Uno stenografo inventa abbreviazioni per le parole che sente più spesso — «che», «quindi», «però» hanno un segno solo. Le parole rare, invece, le scrive lettera per lettera. Il tokenizer fa esattamente questo: assegna «abbreviazioni» (token singoli) a ciò che ha visto tante volte durante l’addestramento.
Il corpus decide chi paga
E qui arriva il punto: i corpora su cui si addestrano i tokenizer dei grandi modelli sono dominati dall’inglese. Il web testuale è in maggioranza anglofono, e le proporzioni si riflettono nei dati di training. Risultato: le parole inglesi frequenti hanno quasi sempre un token dedicato, mentre molte parole italiane — pur comunissime per noi — non compaiono abbastanza spesso da meritarsi una voce nel vocabolario. Vengono quindi spezzate: «tavolo» può diventare tav + olo, «meraviglioso» tre o quattro frammenti.
Non è una scelta contro l’italiano: è statistica. Il vocabolario del tokenizer è una risorsa scarsa (ha una dimensione fissa) e viene allocata dove rende di più, cioè sulla lingua più rappresentata. L’italiano se la cava comunque meglio di molte altre lingue: per lingue con alfabeti non latini — greco, hindi, birmano — il rapporto può diventare di due, tre o più token per parola, con quella che alcuni ricercatori hanno chiamato una vera e propria disparità di «tassazione linguistica» nell’accesso ai modelli.
La morfologia non aiuta
C’è anche un fattore strutturale della lingua. L’italiano è morfologicamente più ricco dell’inglese: dove l’inglese ha «eat» per quasi tutto, noi abbiamo mangio, mangi, mangia, mangiamo, mangiate, mangiano, mangerò, mangerei, mangiassi… Ogni forma flessa è, per il tokenizer, una stringa diversa. Alcune forme frequenti ottengono un token proprio, ma molte finiscono spezzate tra radice e desinenza.
È come un guardaroba: l’inglese ha pochi capi passe-partout che indossa sempre, l’italiano ha un armadio pieno di varianti. Se lo spazio in valigia (il vocabolario del tokenizer) è limitato e la valigia la prepara qualcuno abituato al guardaroba inglese, molti dei nostri capi restano fuori e vanno «arrotolati» in più pezzi.
A questo si aggiungono gli articoli e le preposizioni articolate («dello», «sulla», «nell'»), gli apostrofi, gli accenti: piccoli attriti che, sommati, gonfiano il conteggio.
La stessa frase, token a confronto
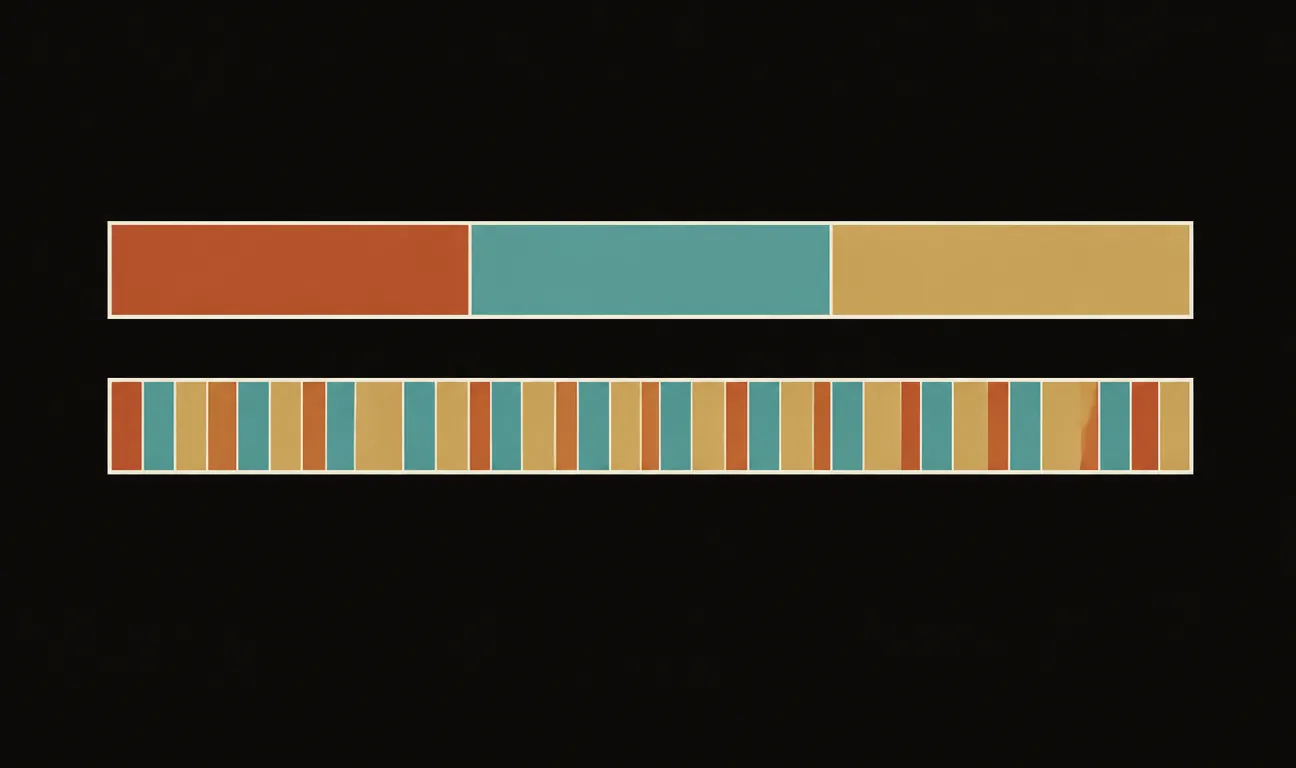
Vediamolo su un esempio concreto. La frase inglese scivola via in token-parola; quella italiana si frammenta.
La stessa frase tokenizzata in inglese e in italiano: le parole inglesi frequenti restano intere, quelle italiane si frammentano. L’esempio è illustrativo — il taglio esatto varia da tokenizer a tokenizer — ma il pattern è quello.
Quanto vale la differenza in aggregato? Dipende dal tokenizer, dal dominio del testo e da come misuri. Per l’italiano su modelli con tokenizer anglocentrici l’ordine di grandezza tipico riportato in letteratura e negli esperimenti pratici è un sovrapprezzo tra il 20% e il 60% rispetto all’inglese, con i tokenizer più recenti e più multilingue — vocabolari più grandi, corpora più bilanciati — che riducono sensibilmente il divario. Vale la pena misurarlo sul proprio caso: le librerie ufficiali dei provider permettono di contare i token in due righe di codice.
Cosa significa in pratica (e in fattura)
Le API dei modelli si pagano a token, in ingresso e in uscita. Un sovrapprezzo del 30-40% sull’italiano si traduce in tre effetti concreti:
- Costo diretto: a parità di contenuto, la stessa applicazione in italiano spende di più. Su volumi alti, la differenza non è simbolica.
- Finestra di contesto: il limite del modello è in token, non in parole. Un documento italiano «entra» meno di uno inglese equivalente: meno testo per il RAG, meno cronologia in una conversazione.
- Latenza: la generazione procede token per token. Più token per dire la stessa cosa significa risposte un po’ più lente.
Il token è l’unità di misura dell’economia dei modelli linguistici: e come ogni unità di misura, non è neutrale — riflette il mondo su cui è stata calibrata.
Qualche contromisura pragmatica: scrivere le istruzioni di sistema in modo asciutto (i prompt lunghi si pagano a ogni chiamata); misurare i token reali del proprio traffico invece di stimarli a parole; quando ha senso, valutare prompt di sistema in inglese con output in italiano — molti team lo fanno proprio per questo; e confrontare i tokenizer dei modelli candidati sul proprio dominio prima di scegliere il fornitore.
Perché ti riguarda
Se costruisci prodotti in italiano sopra un LLM, il tokenizer è un costo di struttura silenzioso: non compare in nessuna riga del listino prezzi, ma sposta il totale. Saperlo cambia le decisioni — dal budget alla scelta del modello al design dei prompt. E se semplicemente usi questi strumenti in italiano, ora sai perché a volte sembrano «tagliare» prima il contesto o rispondere più lentamente: non è la tua connessione, è la stenografia di qualcun altro. La buona notizia è che la direzione è giusta: i tokenizer di nuova generazione sono più multilingui, e il sovrapprezzo dell’italiano si sta riducendo, versione dopo versione.
I commenti sono riservati agli iscritti.
Accedi per commentare