
Stessa domanda, stesso modello, due risposte diverse. Chiunque abbia usato un chatbot lo ha notato: rigenerate la risposta e il testo cambia. Non è un difetto e non è mistero — è una scelta di progetto. Un modello linguistico, a ogni passo, non produce una parola: produce una distribuzione di probabilità su decine di migliaia di token possibili. Qualcuno, poi, deve decidere come pescare da quella distribuzione. Temperature, top-p e beam search sono i tre strumenti principali di questa decisione, e capirli significa capire perché lo stesso modello può sembrare un notaio o un poeta.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
Il problema: dalla distribuzione al token
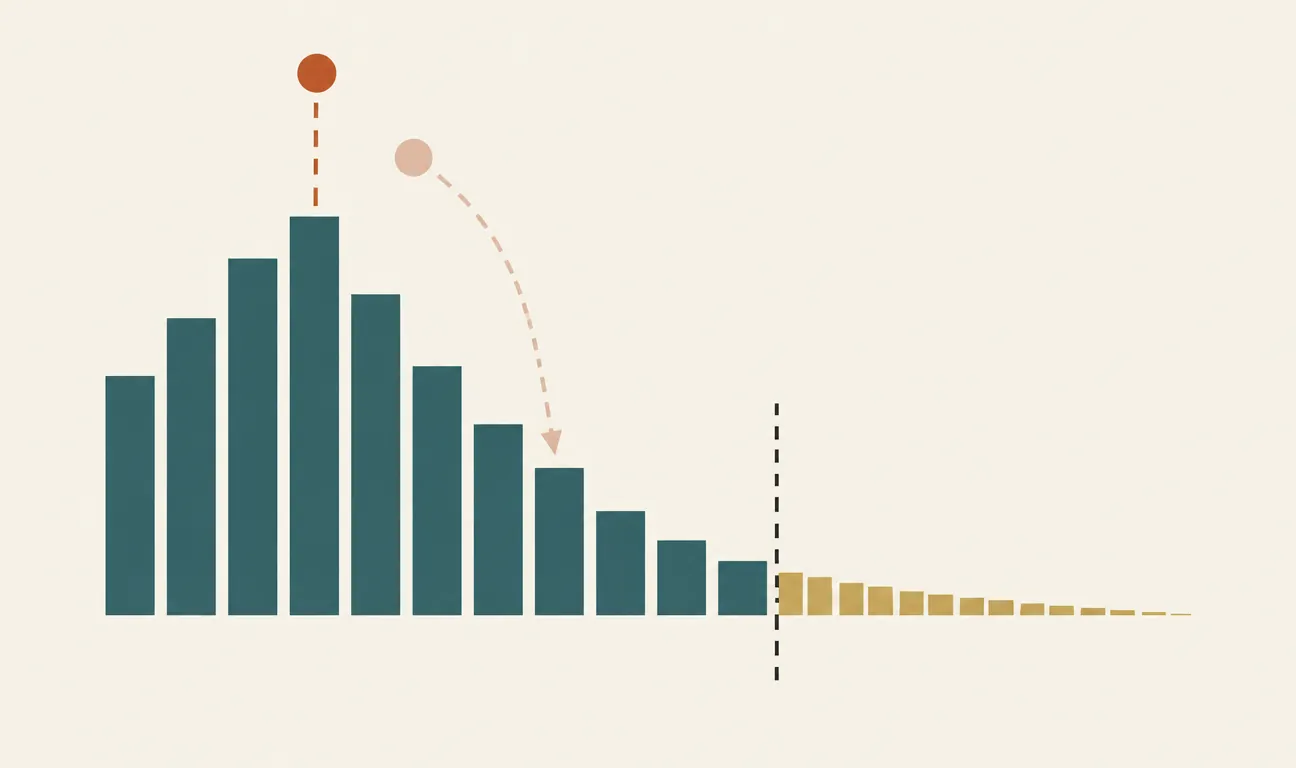
Immaginate il modello davanti alla frase «Il treno per Milano parte alle». L’ultimo strato della rete produce un punteggio (logit) per ogni token del vocabolario; una funzione chiamata softmax li trasforma in probabilità che sommano a 1. Magari otto vale il 18%, nove il 15%, sette il 12%, e giù giù fino a token assurdi con probabilità infinitesime.
La strategia più ovvia — prendere sempre il token più probabile, il cosiddetto greedy decoding — produce testo sorprendentemente piatto e ripetitivo. È il paradosso documentato dalla ricerca sul decoding: il testo umano non è una sequenza di scelte massimamente probabili. Serve un po’ di caso, ma un caso controllato. Da qui i tre strumenti.
Temperature: riscaldare o raffreddare la distribuzione
La temperature è un numero, tipicamente tra 0 e 2, che divide i logit prima della softmax. L’effetto è rimodellare la distribuzione senza cambiarne l’ordine. Con temperature bassa (vicina a 0) le differenze si amplificano: il token in testa diventa dominante e la generazione si avvicina al greedy, deterministica e prudente. Con temperature alta le differenze si appiattiscono: token improbabili guadagnano quote e il testo diventa vario, a volte fino all’incoerenza.
L’analogia è quella termodinamica da cui prende il nome: a bassa temperatura le molecole stanno ferme nella configurazione più stabile, ad alta temperatura si agitano ed esplorano stati improbabili. Per una risposta di supporto clienti volete un gas freddo; per un brainstorming di titoli, uno caldo. Il valore 1 lascia la distribuzione così come il modello l’ha prodotta.
La temperature non rende il modello più intelligente o più creativo: rende solo più o meno probabile che esca dal seminato. Il seminato resta il suo.
Top-p: tagliare la coda
Alzare la temperature ha un effetto collaterale: gonfia anche la probabilità dei token davvero pessimi, quella lunga coda di scelte assurde. Il nucleus sampling, o top-p, attacca il problema dall’altro lato: ordina i token per probabilità e tiene solo il gruppo di testa la cui probabilità cumulata raggiunge la soglia p (per esempio 0,9). Tutto il resto viene azzerato, e si ripesca solo dal «nucleo».
Il vantaggio rispetto al cugino top-k (che tiene un numero fisso di candidati) è l’adattività. Quando il contesto è vincolante — dopo «la capitale della Francia è» — il nucleo si riduce a pochissimi token, magari uno solo. Quando il contesto è aperto — «C’era una volta» — il nucleo si allarga a decine di continuazioni legittime. È come un buttafuori che non fa entrare «i primi 50 in fila» ma «tutti quelli plausibili, e nessun altro»: la lista cambia lunghezza a seconda della serata.
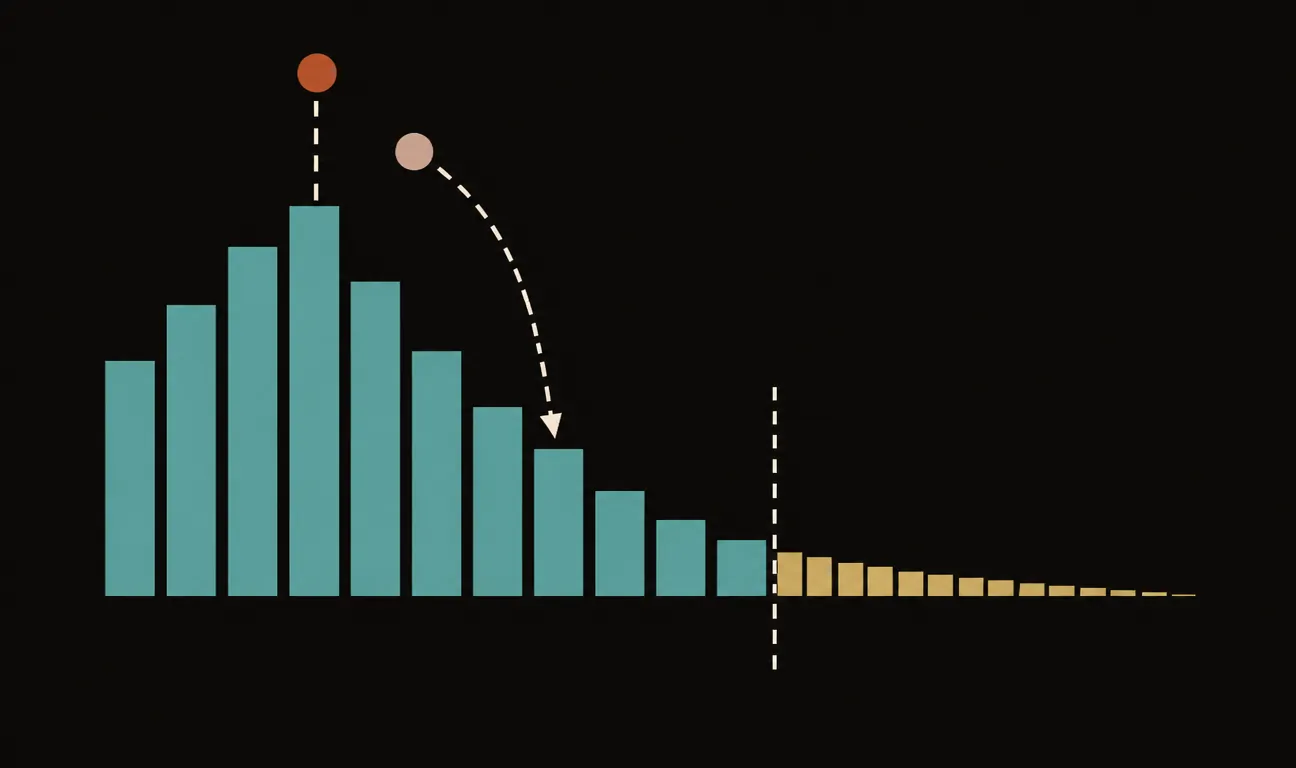
Tre modi di intervenire sulla stessa distribuzione: la temperature la riscala (appiattendola o accentuandola), il top-p la taglia eliminando la coda, la beam search rinvia la scelta esplorando più sequenze in parallelo e tenendo la migliore.
Beam search: rimandare la decisione
Temperature e top-p operano token per token: scelto un token, non si torna indietro. La beam search cambia filosofia: invece di impegnarsi subito, mantiene in parallelo le k sequenze parziali più promettenti (i beam, tipicamente da 4 a 10) e le estende passo dopo passo, potando a ogni giro quelle che perdono terreno. Alla fine vince la sequenza con la probabilità complessiva più alta.
È la differenza tra scegliere a ogni bivio la strada che sembra migliore e usare un navigatore che valuta percorsi interi: una svolta localmente peggiore può portare a un tragitto globalmente migliore. La beam search domina nei compiti dove esiste una risposta «giusta» e compatta — traduzione automatica, riassunto, riconoscimento vocale (Whisper la usa) — ma nella generazione aperta produce testi ripetitivi e prevedibili, e costa k volte il calcolo. Per questo i chatbot moderni in pratica non la usano: preferiscono il campionamento con temperature e top-p.
Come si combinano in pratica
Nelle API dei principali provider trovate quasi sempre temperature e top-p insieme, e conviene una regola pratica: muovetene uno solo, lasciando l’altro al default. Alcune combinazioni ragionevoli come punto di partenza:
- Estrazione dati, codice, risposte fattuali: temperature 0-0,3. Volete riproducibilità, non fantasia.
- Scrittura assistita, risposte conversazionali: temperature 0,7-1 con top-p 0,9-0,95. Il compromesso standard.
- Brainstorming, variazioni creative: temperature 1-1,3, tenendo il top-p a fare da rete di sicurezza contro la coda assurda.
Un’avvertenza onesta: anche a temperature 0 la riproducibilità totale non è garantita. Il calcolo parallelo su GPU introduce piccole non-determinazioni numeriche che, accumulandosi, possono far divergere due generazioni identiche. Il determinismo perfetto, negli LLM in produzione, è un’approssimazione.
Perché vi riguarda
Questi tre parametri sono la manopola più economica che avete: cambiarli non costa nulla, non richiede riaddestramenti, e trasforma il comportamento del modello più di molti ritocchi al prompt. Se un modello vi sembra «stupido e ripetitivo», forse state facendo greedy decoding a un compito creativo; se «inventa cose a caso», forse avete la temperature da brainstorming su un compito fattuale. Prima di cambiare modello, o di scrivere il decimo prompt disperato, guardate come state pescando dalla distribuzione. Spesso il problema non è il pescatore, ma la rete.
I commenti sono riservati agli iscritti.
Accedi per commentare