
Spostate la foto di un gatto di tre pixel verso destra. Per voi non è successo niente: stesso gatto, stessa posa. Per un computer è successo tutto: milioni di numeri hanno cambiato posizione nella griglia, e un modello che avesse imparato «gatto» come una configurazione esatta di valori in punti esatti si troverebbe davanti un input mai visto. Le reti convoluzionali risolvono questo problema con una mossa controintuitiva: buttano via informazione. Di proposito, a ogni strato, con un’operazione che si chiama pooling. Ed è proprio questo dimenticare selettivo che permette di salire, gradino dopo gradino, dai pixel ai concetti.
La convoluzione come filtro che scorre, i campi recettivi, i pesi condivisi e il pooling sono spiegati nel libro.
Cosa fa il pooling, concretamente
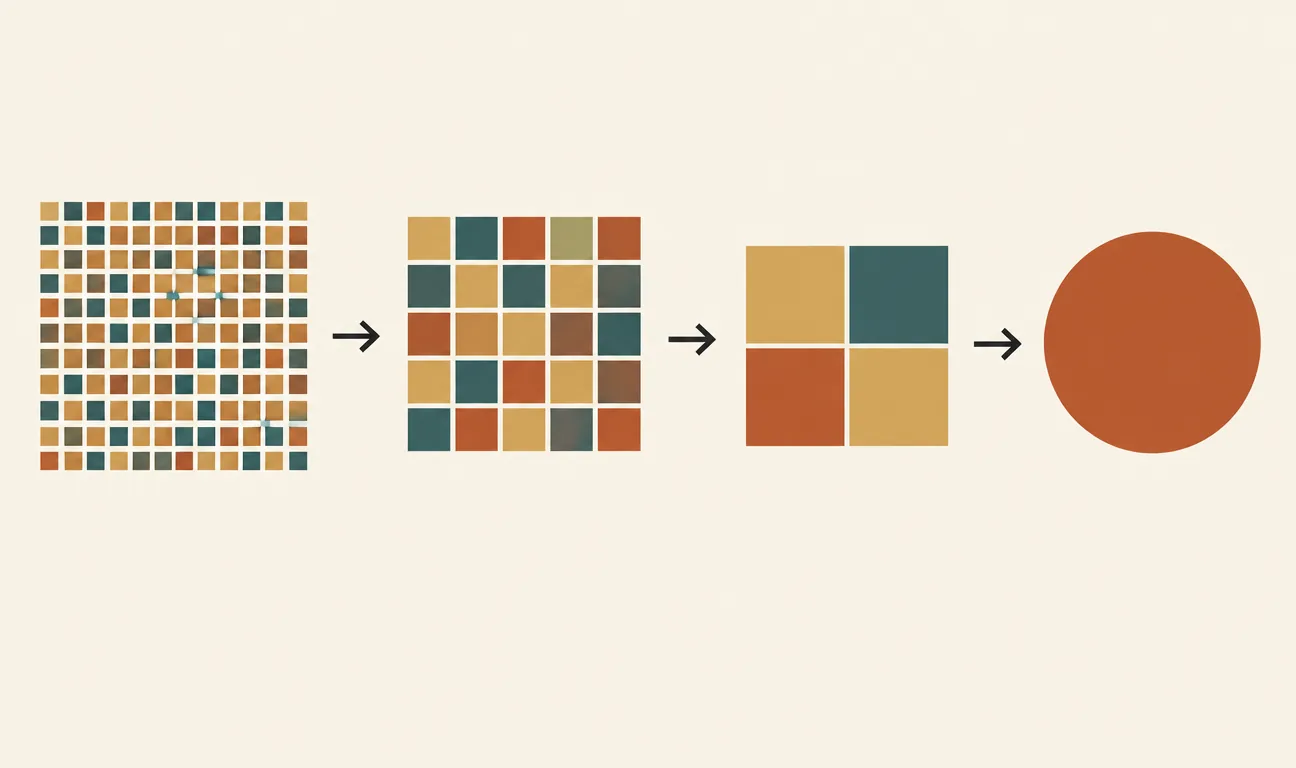
L’operazione è quasi banale. Si prende una feature map — la griglia di risposte prodotta da uno strato convoluzionale — e la si divide in quadratini, tipicamente 2×2. Da ogni quadratino si estrae un solo numero: il massimo, nel caso del max pooling, oppure la media, nell’average pooling. Il risultato è una griglia con un quarto delle celle. Quattro numeri entrano, uno esce.
Il max pooling, che è la variante di gran lunga più usata nelle architetture classiche, ha una lettura precisa: «in questa zona, il pattern che cerchi c’è o non c’è?». Non importa se il bordo verticale era nel pixel in alto a sinistra o in quello in basso a destra del quadratino: se c’era, il massimo lo registra. La posizione esatta viene scartata, la presenza viene conservata.
È lo stesso criterio con cui riassumereste una partita di calcio a un amico: non gli elencate le coordinate di ogni giocatore minuto per minuto, gli dite «gol al 34esimo». Il riassunto perde quasi tutta l’informazione, ma conserva quella che serve per capire cos’è successo. Il pooling fa riassunti spaziali: perde il «dove esattamente», tiene il «cosa, all’incirca lì».
Perdere precisione per guadagnare robustezza
Qui torna il gatto spostato di tre pixel. Dopo un paio di round di pooling, quei tre pixel di spostamento diventano irrilevanti: i pattern rilevati finiscono negli stessi quadratini, e il riassunto è identico o quasi. La rete diventa tollerante alle piccole traslazioni — non perché qualcuno gliel’abbia insegnato, ma perché la sua architettura rende letteralmente invisibili gli spostamenti piccoli.
C’è anche un beneficio computazionale immediato: dimezzare i lati della griglia significa quartare il numero di valori da elaborare. Gli strati successivi lavorano su mappe sempre più piccole, quindi possono permettersi molti più canali — più tipi di pattern cercati — a parità di costo. E c’è un terzo effetto, il più importante per il resto di questa storia: riducendo la griglia, il pooling allarga il campo recettivo. Un kernel 3×3 applicato dopo un pooling «vede» una porzione di immagine originale doppia rispetto a prima. Ogni riduzione è uno zoom all’indietro.
La gerarchia: bordi, forme, oggetti
Mettete ora in fila i pezzi: convoluzione, pooling, convoluzione, pooling, più volte. Cosa succede al contenuto delle feature map, strato dopo strato?
Nei primi strati i kernel vedono porzioni minuscole dell’immagine, e possono rilevare solo ciò che sta in pochi pixel: bordi, angoli, piccole macchie di colore, texture elementari. Negli strati intermedi, ogni kernel combina le risposte dei rilevatori precedenti su una zona più ampia: un bordo curvo sopra, uno sotto, una zona uniforme in mezzo — comincia a somigliare a un occhio, a una ruota, a una foglia. Negli strati profondi, con campi recettivi che coprono gran parte dell’immagine, le combinazioni diventano configurazioni di parti: due occhi, un naso triangolare, orecchie a punta — un muso di gatto.
Questa scala di astrazione non è programmata: emerge dall’addestramento, ed è stata osservata e visualizzata in modo sistematico da lavori come quello di Matthew Zeiler e Rob Fergus sulla visualizzazione delle reti convoluzionali. La struttura a piramide — griglie sempre più piccole, significati sempre più ricchi — è il modo in cui una rete trasforma la geometria in semantica.
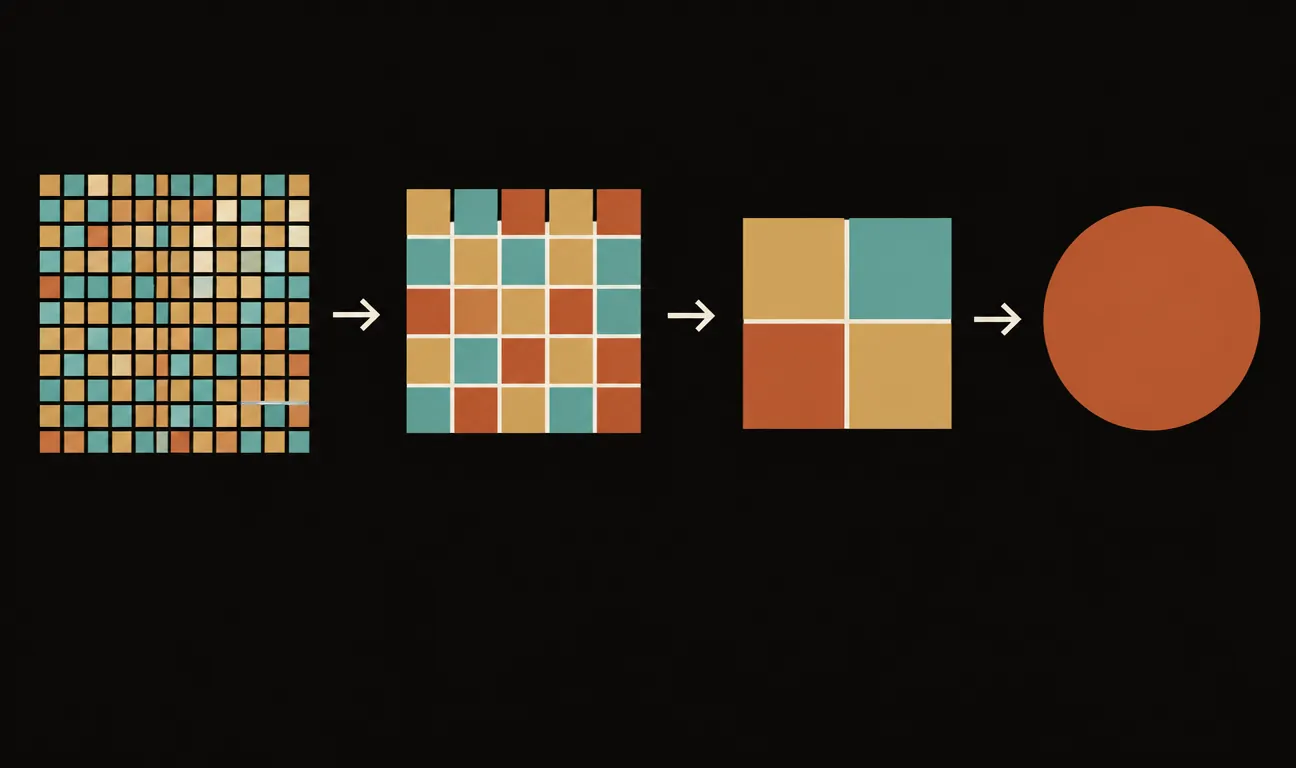
A ogni blocco di convoluzione e pooling la griglia si restringe e il contenuto si astrae: i bordi dei primi strati si combinano in forme, le forme in configurazioni di parti, fino al concetto finale.
Cosa si perde nel riassunto
Buttare via il «dove esattamente» ha un costo, e conviene essere onesti su quale. Per la classificazione — dire se nell’immagine c’è un gatto — la posizione precisa dei dettagli conta poco, e il pooling è quasi tutto guadagno. Ma per compiti come la segmentazione, dove serve decidere pixel per pixel cosa appartiene a cosa, l’informazione spaziale scartata va poi faticosamente ricostruita: le architetture per questi compiti aggiungono percorsi di upsampling e collegamenti che ripescano i dettagli dai primi strati, come nella U-Net.
Geoffrey Hinton, uno dei padri del deep learning, ha criticato apertamente il max pooling proprio per questo scarto di informazione posizionale, al punto da proporre architetture alternative. E nella pratica recente il pooling classico è spesso sostituito da convoluzioni con stride 2, che riducono la griglia lasciando alla rete la libertà di imparare come riassumere, invece di imporre il massimo o la media. Il principio però resta identico: comprimere lo spazio per far salire l’astrazione.
Capire non è accumulare dettagli: è saperli dimenticare nell’ordine giusto. Una rete convoluzionale lo fa per architettura, un gradino di astrazione alla volta.
L’ultimo gradino: dalla mappa al verdetto
In cima alla piramide resta una griglia piccola — magari 7×7 — con centinaia di canali, ognuno dei quali segnala la presenza di un pattern di alto livello. L’ultimo atto è spesso un global average pooling: la media di ogni canale su tutta la griglia, che riduce ciascuna mappa a un solo numero. Da «dove ci sono musi di gatto» a «quanto muso di gatto c’è in questa immagine, in totale». Su quel vettore compatto, un ultimo strato lineare emette il verdetto: le probabilità delle classi.
È la conclusione coerente di tutto il percorso: si parte da milioni di pixel che non significano nulla da soli, e si arriva a poche centinaia di numeri che significano moltissimo ciascuno. La rete non ha mai «visto» il gatto: ha costruito, per compressioni successive, una descrizione in cui il gatto è l’unica spiegazione rimasta.
Perché ti riguarda
La piramide bordi→forme→oggetti non è solo un dettaglio ingegneristico: è il motivo per cui il transfer learning funziona (i primi strati sono riutilizzabili ovunque, perché i bordi servono a tutti), è il punto di partenza dell’interpretabilità (per capire una rete si guarda cosa attiva i suoi strati), ed è un’idea che ritorna identica nei modelli di linguaggio, dove gli strati bassi elaborano ortografia e sintassi e quelli alti maneggiano semantica e ragionamento. E c’è una lezione trasferibile anche fuori dall’informatica: qualunque sistema che deve capire qualcosa di complesso — un’organizzazione, un cervello, una redazione — funziona così, riassumendo a ogni livello e lasciando salire solo ciò che conta. Il pooling è la versione matematica di una buona catena di riporto.
I commenti sono riservati agli iscritti.
Accedi per commentare