
Nel dicembre 2015 una rete neurale di 152 strati vinse la competizione ImageNet con un margine netto, in un momento in cui lo stato dell’arte si fermava attorno ai venti strati — e non per pigrizia: le reti più profonde, semplicemente, funzionavano peggio. Il paper che descriveva quella rete, firmato da Kaiming He e colleghi a Microsoft Research, proponeva una modifica architetturale che si scrive in una riga: invece di calcolare y = F(x), calcola y = F(x) + x. Una somma. Quella somma si chiama skip connection, la rete si chiama ResNet, e dieci anni dopo quella riga è dentro praticamente ogni modello che usiamo, dai classificatori di immagini a GPT e Claude.
Da LeNet-5 ad AlexNet, VGG e ResNet: le architetture che hanno fatto la storia sono ricostruite nel libro.
Leggi «Le architetture che hanno fatto la storia» nel libro →
Il paradosso della profondità
Per capire perché la somma serviva, bisogna partire dal problema che risolveva. La teoria diceva che più strati significano più capacità espressiva: una rete profonda può rappresentare funzioni che una rete corta non può nemmeno approssimare in modo efficiente. La pratica diceva il contrario: portando una rete «semplice» da 20 a 56 strati, l’errore saliva. E — questo è il dettaglio cruciale — saliva anche sul training set.
Non era quindi overfitting: una rete che va male sui dati di addestramento non sta memorizzando troppo, sta imparando troppo poco. Era un problema di ottimizzazione. Ed era paradossale in modo quasi offensivo: una rete di 56 strati può in linea di principio imitare esattamente una di 20 — basta che gli ultimi 36 strati non facciano niente, cioè copino l’input sull’output. Quella soluzione esiste nello spazio dei parametri. La discesa del gradiente, però, non riusciva a trovarla.
Il motivo è che per una pila di layer non lineari «non fare niente» è difficile. La funzione identità — restituisci esattamente quello che ricevi — va costruita faticosamente, calibrando pesi che attraversano ReLU e normalizzazioni. È come chiedere a una catena di cinquanta traduttori di restituire il testo originale parola per parola: ognuno introduce la sua sfumatura, e pretendere che il messaggio arrivi intatto richiede uno sforzo di coordinazione enorme. Molto più facile se ogni traduttore può allegare il documento originale e limitarsi ad annotare le modifiche.
La mossa: imparare la differenza, non la funzione
La skip connection è esattamente questo: allegare l’originale. In un blocco residuale, l’input x attraversa due o tre layer convoluzionali che calcolano F(x), e poi viene sommato al risultato: l’output è F(x) + x. Il blocco non deve più imparare la trasformazione completa, ma solo la correzione rispetto all’identità — il residuo, da cui il nome.
Il vantaggio è asimmetrico nel modo giusto. Se il blocco non ha niente di utile da aggiungere, gli basta portare F(x) verso zero — e spingere pesi verso zero è la cosa più naturale del mondo per la discesa del gradiente con regolarizzazione. Il caso «non fare niente», prima quasi irraggiungibile, diventa il punto di partenza. Aggiungere strati non può più peggiorare le cose in modo catastrofico: male che vada, i nuovi strati imparano a essere trasparenti.
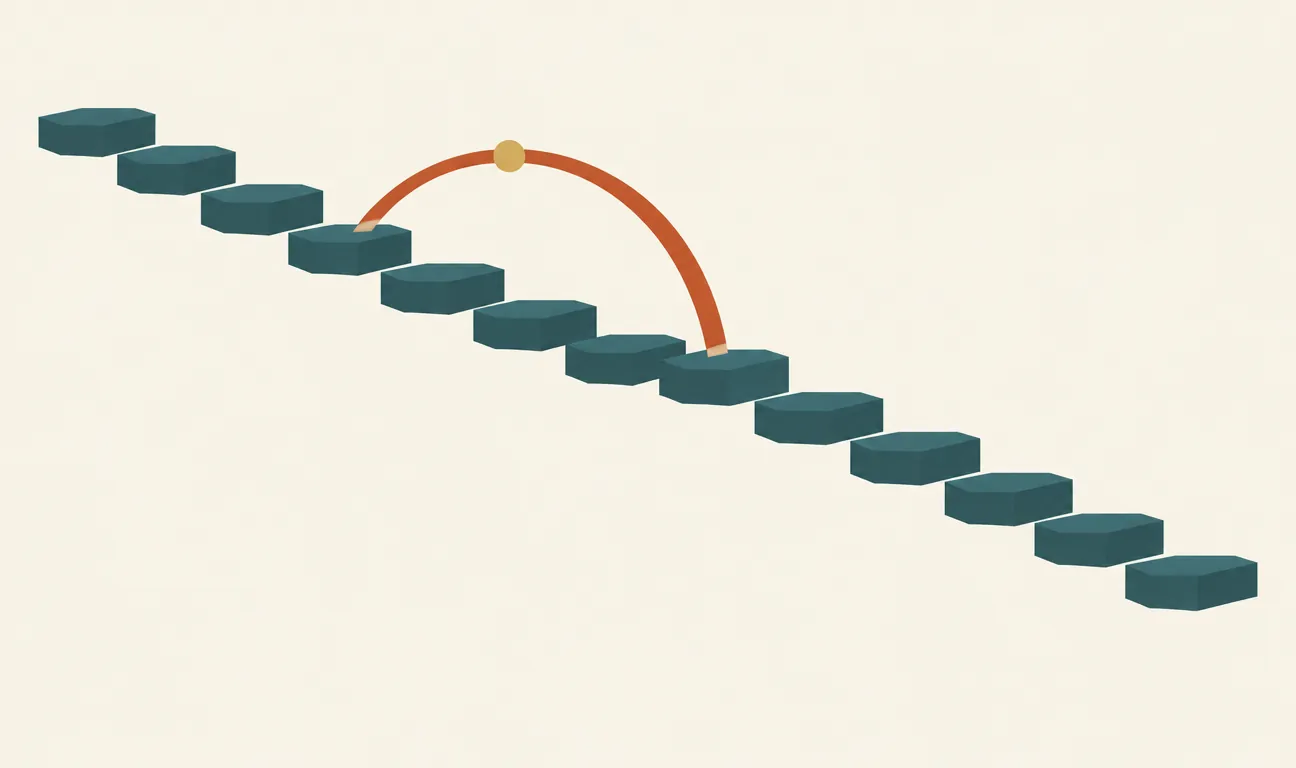
L’input di un blocco residuale segue due strade: quella lunga attraverso i layer, che impara la correzione F(x), e la scorciatoia che lo porta intatto alla somma finale. Se F(x) tende a zero, il blocco diventa trasparente.
L’autostrada del gradiente
C’è un secondo beneficio, ancora più importante del primo. L’addestramento di una rete funziona per retropropagazione: l’errore misurato in uscita viene fatto risalire strato per strato, e ogni passaggio lo moltiplica per le derivate locali del layer. In una rete profonda tradizionale questo prodotto di decine di fattori tende a esplodere o, più spesso, a svanire: quando il segnale arriva ai primi strati non è rimasto quasi niente, e quei layer smettono di imparare. È il problema del gradiente evanescente.
La skip connection cambia la topologia del percorso. Derivando F(x) + x rispetto a x si ottiene la derivata di F più uno: quel «+1» significa che una parte del gradiente attraversa il blocco senza alcuna attenuazione, come se i layer non ci fossero. Con decine di blocchi in fila, le scorciatoie si concatenano in un’autostrada che collega l’uscita della rete direttamente ai primi strati. I layer restano liberi di imparare cose complicate, ma il segnale di addestramento non dipende più dal loro buon funzionamento per arrivare a destinazione.
La profondità non era troppa: era il percorso del gradiente a essere troppo fragile. ResNet non ha reso le reti più intelligenti — le ha rese addestrabili.
I numeri del paper originale raccontano la svolta: la ResNet-152, otto volte più profonda di una VGG-19, e versioni sperimentali oltre i mille strati che ancora si addestravano in modo stabile. Il muro dei venti strati, che sembrava una legge di natura, era un artefatto dell’ottimizzazione.
Dalla visione ai transformer
Se ResNet fosse rimasta una storia di classificazione di immagini, sarebbe comunque un classico. Ma l’idea si è dimostrata più generale dell’ambito in cui è nata. Il transformer, presentato nel 2017, usa connessioni residuali attorno a ogni blocco di attenzione e a ogni blocco feed-forward: è la ragione strutturale per cui si possono impilare le decine di strati dei modelli linguistici attuali. Senza quelle somme, addestrare un modello con quasi cento blocchi in profondità sarebbe impraticabile con le tecniche note.
C’è anche un modo suggestivo di rileggere cosa fa una rete residuale: siccome ogni blocco calcola x + correzione, la rappresentazione non viene mai sostituita, viene raffinata. L’informazione scorre lungo un unico flusso — nei transformer lo si chiama residual stream — e ogni strato ci legge e ci scrive sopra piccole modifiche, come revisori successivi che annotano lo stesso manoscritto invece di riscriverlo da capo. Questa prospettiva è diventata centrale nella ricerca sull’interpretabilità dei modelli linguistici: capire cosa fa un LLM significa in gran parte capire cosa ogni layer aggiunge o rimuove da quel flusso condiviso.
Cosa insegna, oltre la tecnica
La skip connection è diventata un principio di design che va oltre la sua funzione originaria: nelle U-Net per la segmentazione e nei modelli di diffusione che generano immagini, connessioni analoghe ripescano i dettagli ad alta risoluzione persi nella discesa; le highway network, uscite pochi mesi prima di ResNet, esploravano una variante con «cancelli» appresi — e la storia ha premiato la versione più semplice, senza cancelli, solo la somma.
C’è una lezione di metodo in questa vicenda. Il problema della degradazione era noto, misurabile, riprodotto in mille esperimenti; la soluzione non è arrivata da più potenza di calcolo né da un ingrediente esotico, ma dal riformulare la domanda: non «come faccio a imparare la trasformazione giusta?» ma «rispetto a quale default sto imparando?». Partire dall’identità e imparare le deviazioni, invece di partire da zero e imparare tutto.
Perché ti riguarda
Se addestri reti neurali, le connessioni residuali sono il motivo per cui puoi aggiungere profondità senza terrore: quasi ogni architettura moderna che vale la pena usare le ha già dentro, e quando una tua rete profonda non converge, il percorso del gradiente è il primo indiziato da controllare. Se i modelli li usi soltanto, ogni risposta di un LLM attraversa centinaia di quelle somme: la scorciatoia di He e colleghi è uno dei mattoni silenziosi su cui poggia tutto il resto. E se non tocchi codice affatto, resta il principio, che vale anche fuori dall’informatica: quando un sistema complesso deve migliorare qualcosa che già funziona, conviene fargli modellare le correzioni, non ricostruire tutto da capo. La versione matematica di «non buttare la bozza: annotala».
Il paper originale
Lo studio di riferimento è «Deep Residual Learning for Image Recognition» di Kaiming He, Xiangyu Zhang, Shaoqing Ren e Jian Sun (Microsoft Research, 2015), presentato a CVPR 2016, dove ha vinto il best paper award. È uno dei lavori più citati della storia dell’informatica, e — cosa non scontata per un paper così influente — si legge bene: gli esperimenti sulla degradazione delle reti «semplici» nelle prime pagine valgono da soli la lettura. Per la variante con pre-attivazione, che riordina i blocchi migliorando il flusso del gradiente, il seguito degli stessi autori è «Identity Mappings in Deep Residual Networks» (2016).
I commenti sono riservati agli iscritti.
Accedi per commentare