
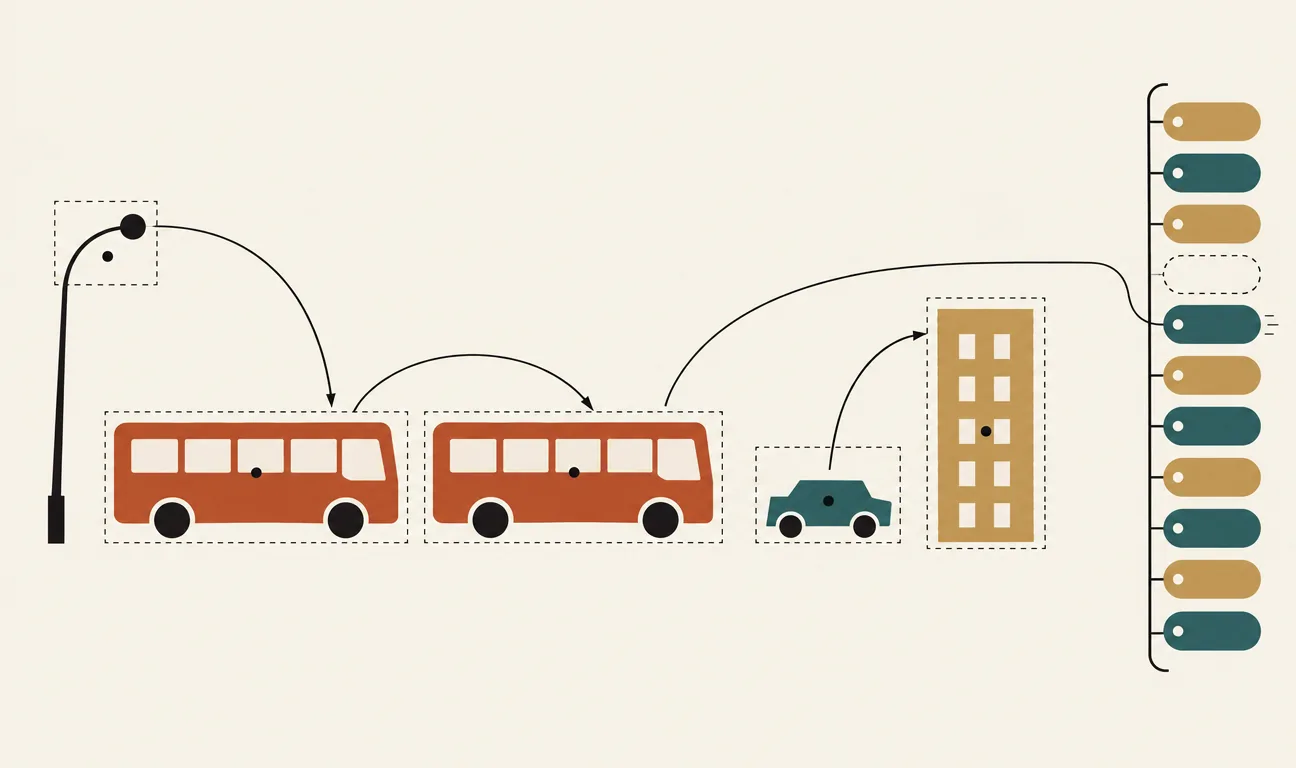
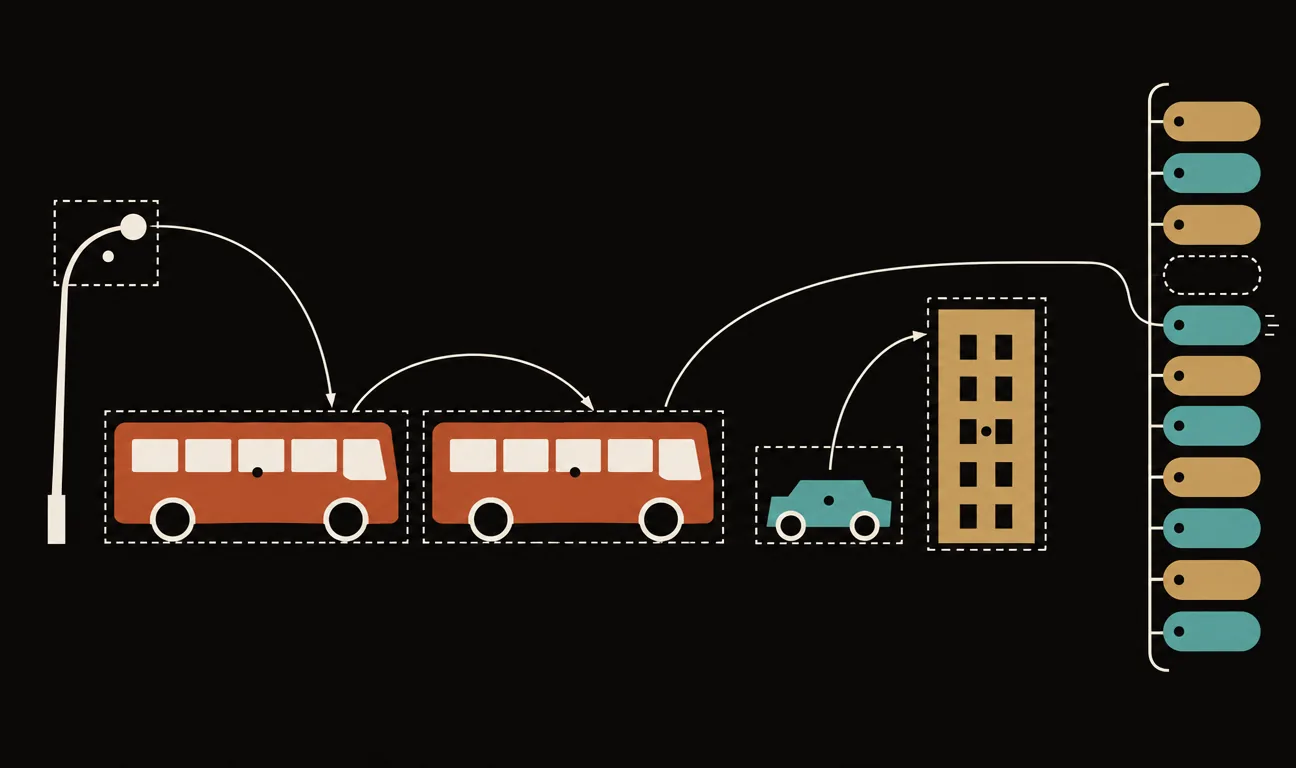
Si chieda a qualcuno di descrivere una fotografia di strada. Non dirà soltanto «un autobus, un’auto, un lampione». Dirà che l’auto è parcheggiata accanto all’edificio, che l’autobus segue un’altra vettura, che il lampione illumina la carreggiata. Gli oggetti sono i sostantivi della scena; le relazioni, verbi e preposizioni, portano quasi tutto il significato. Per un robot che deve prendere la tazza sopra il tavolo, e non quella sotto, la differenza non è di stile.
RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs, uscito su arXiv l’11 settembre 2026 (2609.12552) e firmato da Maëlic Neau, ricercatore indipendente, parte da un’osservazione semplice. I rilevatori a vocabolario aperto ricevono l’elenco delle classi al momento della richiesta, e la segmentazione «promptable» restituisce regioni senza nome. In entrambi i casi, scrive l’autore, la tassonomia è uscita dal modello ed è diventata un input. La predizione delle relazioni no: i modelli di scene graph si addestrano e si valutano ancora sui 50 predicati di VG150 o sui 56 di PSG.
Riquadri, rilevatori e maschere di segmentazione, cioè da dove vengono le regioni che RelateAnything riceve in ingresso: il libro li costruisce da capo.
Tre ostacoli, e nessuno è il modello
Secondo il paper gli ostacoli sono tre, e nessuno è anzitutto un problema di modellazione. Il primo è che manca la supervisione: annotare relazioni è costoso e poco affidabile, e i corpora generati a macchina o proiettano tutto su un elenco chiuso o non controllano l’annotatore. Il secondo è l’architettura: la testa che predice la relazione riceve in ingresso le classi degli oggetti, e così eredita lo spazio di etichette di un rilevatore preciso. Il terzo, il meno discusso, è la misura: la recall su un benchmark il cui vocabolario coincide con quello di addestramento premia l’accordo con il corpus, non la relazione nell’immagine. Un modello che risponde «indossa» dove l’annotazione dice «porta» viene contato come errore.
La risposta è un modello, un corpus e un protocollo di valutazione, tutti rilasciati.
Il modello: tre ingressi separati
RelateAnything ha 53 milioni di parametri e riceve tre cose indipendenti: i pixel, un insieme di regioni da qualsiasi fonte (un rilevatore, un segmentatore senza classi, un’annotazione umana) e un elenco di predicati sotto forma di stringhe. Le classi degli oggetti non entrano mai nella rete, in nessuna fase: durante l’addestramento compaiono solo dentro due termini della loss. Ne segue che la fonte delle regioni si può cambiare senza riaddestrare.
La parte visiva usa DINOv3 a 448 pixel; ogni riquadro legge tutta la mappa delle feature, non un ritaglio, così l’oggetto porta con sé il contesto. Per ogni coppia ordinata si combinano soggetto, oggetto, riquadro unione, zona di contatto e 19 feature geometriche, poi un piccolo transformer fa dialogare le coppie fra loro e con la scena. Un campionatore tiene 128 coppie delle $N(N-1)$ possibili, e secondo il paper conserva il 99,79% delle coppie annotate.
Non c’è un classificatore. Il punteggio è una similarità del coseno fra la rappresentazione della coppia e l’embedding testuale del predicato, su due rami, uno geometrico e uno di aspetto, mescolati da un peso che dipende solo dal predicato:
$$\ell(i,j,p) = \tau\Big[\alpha_p \cos\big(z^{\text{spa}}_{ij}, e_p\big) + (1-\alpha_p)\cos\big(z^{\text{sem}}_{ij}, e_p\big)\Big] + \beta, \qquad \alpha_p = g(e_p).$$
Poiché $\alpha_p$ si calcola dall’embedding della stringa, è definito anche per parole mai viste. Il gate non riceve supervisione propria, eppure impara da solo pesi nettamente bimodali: le relazioni di posizione e di vicinanza vanno al ramo geometrico, le azioni a quello di aspetto. Sul lato testo nessuno strato impara durante l’addestramento, e cambiare vocabolario significa sostituire una matrice di embedding. Il sistema completo, rilevatore compreso, gira a 20 millisecondi per fotogramma su una A40 dopo la compilazione.
Perché un’immagine e una frase possono finire nello stesso spazio vettoriale, e che cosa ottimizza un codificatore addestrato in modo contrastivo: è la premessa del punteggio qui sopra, e il libro la spiega nel capitolo su visione e linguaggio.
Diecimila predicati cambiano il problema
Il modello viene addestrato su una banca di 19.103 stringhe invece che sulle solite poche decine, e l’autore mostra che a questa scala due cose si rompono.
La prima è la supervisione. Se una coppia ⟨uomo, cavallo⟩ è annotata «cavalca», allora anche «è seduto su» è vero, solo che nessuno l’ha scritto. Con 50 predicati trattare il non annotato come negativo è accettabile; con diecimila insegna a sopprimere risposte corrette. Il paper tratta il problema come apprendimento positive-unlabeled: stima, per ogni coppia di predicati, la probabilità $\hat P(q \mid p)$ che $q$ valga quando è annotato $p$, e nel denominatore dell’InfoNCE sposta il logit di ogni negativo di
$$\log\big(1 – \hat P(q \mid p)\big),$$
così un predicato quasi certamente vero non pesa quasi più. La stima viene dalle 706.000 coppie di riquadri con più di un’annotazione. Due eccezioni: i predicati annotati non vengono mai scontati, e gli inversi direzionali mantengono sempre il peso pieno.
La seconda cosa rotta è lo spazio del testo. Il codificatore di partenza (dino.txt) mette «above» e «below» a una similarità del coseno di 0,95, «to the left of» e «to the right of» a 0,99: tanto vicini quanto, in media, i sinonimi (0,96). Nessun modello addestrato a puntare su quelle direzioni può separare con affidabilità sopra da sotto, chiunque lo addestri. L’autore distilla quindi un codificatore più piccolo, a 512 dimensioni, con un termine che respinge le coppie di contrari: il coseno medio fra inversi scende da 0,92 a 0,09, mentre i sinonimi restano a 0,71.
RA-4M: il corpus scritto da un modello, controllato dalla geometria
Per avere una supervisione densa il paper genera RA-4M: 474.413 immagini, 4.282.531 relazioni, 10.102 predicati in testo libero, con 104 ore di GPU. L’annotatore è Gemma 4 (26B), che lavora su immagini con un indicatore numerato al centro di ogni riquadro: il riferimento all’oggetto è un dato che il modello riceve, non una cosa che deve indovinare. Poi ogni relazione passa un controllo geometrico deterministico, che scarta l’11,3% delle proposte. Il controllo interviene solo dove la geometria vincola davvero il predicato (un «dentro» fra riquadri disgiunti è falso); altrove la relazione passa, e il rischio viene dichiarato. Il caso più grande è lo sguardo: circa il 22% delle annotazioni «guarda» ha riquadri disgiunti e non si può verificare. Rispetto alle annotazioni originali sulle stesse immagini e sugli stessi riquadri, il risultato è 1,7 volte più denso e ha 107 volte il vocabolario.
Una tabella senza pixel batte il modello
La critica alla misura è forse la parte più interessante. Una tabella che per ogni coppia di categorie restituisce il predicato più frequente, senza guardare l’immagine e con le categorie vere fornite dall’esterno, supera RelateAnything nell’accuratezza per arco di circa il 15%, in termini relativi, su tutti e tre i benchmark (su VG150 68,4 contro 57,7). Sulla media per predicato il rapporto si rovescia: sempre su VG150, 18,9 contro 35,1. La recall classica premia chi indovina «on» e «has»; conta poco se un predicato raro è riconosciuto.
Micro e macro, recall e precisione, e perché una media pesata sulle classi frequenti può nascondere un modello che non ha imparato quelle rare: le metriche sono spiegate nel capitolo sulla valutazione.
Da qui nasce OV-SGG-Bench, sei assi misurati tutti fuori dal dominio di addestramento, fra cui la precisione contro negativi verificati da persone (Haystack) e le relazioni spaziali contro negativi avversari (SpatialSense). Accanto a ogni recall il paper riporta la quota di triple soggetto-predicato-oggetto che il corpus di addestramento condivide con il benchmark: per il baseline OvSGTR su VG150 è il 90,9%, per RelateAnything il 12,8%.
I numeri
Sui riquadri veri, in trasferimento, RelateAnything supera OvSGTR su ogni metrica di ogni benchmark, senza le etichette che il baseline riceve. La mean recall è da 2,3 a 3,5 volte più alta.
| Benchmark | RelateAnything | OvSGTR |
|---|---|---|
| VG150 | 28,2 | 10,4 |
| PSG | 30,6 | 8,8 |
| IndoorVG | 29,5 | 12,8 |
Sui predicati rari lo scarto è di 5–21 volte, e su VG150 il baseline fa esattamente zero. Su Haystack l’AUC per predicato sale da 83,9 a 93,7. Con il vocabolario intero di 19.103 stringhe e un abbinamento per sinonimi la recall su VG150 non crolla: 56,0 contro 53,3, e la stringa giusta sta in mediana al primo posto. Rispetto a ROBIN-3B, costruito su un modello visione-linguaggio da 3 miliardi di parametri, con meno del 2% dei parametri è avanti su entrambe le metriche nell’asse di trasferimento; ma quando entrambi rispondono in testo libero, ricondotto alle parole del benchmark da un abbinatore (su PSG), ROBIN resta davanti sulla recall micro con ogni abbinatore, e sulla mean recall l’ordine dipende dall’abbinatore. Il sistema intero è 7,8 volte più veloce di OvSGTR sulla stessa GPU, anche se, precisa l’autore, valuta molte meno coppie a risoluzione più bassa.
Il dato che vale oltre il modello: raddoppiare il corpus dà +15% di recall sul dominio di casa e fra il 2,5 e il 3,8% in trasferimento. Il guadagno misurato in casa sovrastima quello in trasferimento di circa cinque volte, e una modifica selezionata in casa può peggiorare fuori.
I limiti, detti dall’autore
Il corpus non ha una stima di precisione fatta da persone su un campione letto a mano: l’autore la indica come la prima misura da aggiungere. I risultati sono fra dataset diversi ma non su concetti nuovi: ogni predicato dei benchmark compare nel vocabolario di addestramento. Sulle relazioni spaziali, l’asse più debole, l’AUC macro è 0,690 contro 0,591 del baseline; ma in accuratezza entrambi (62,5% e 59,0%) restano sotto il 68,8% di un baseline che usa solo i riquadri e non vede l’immagine, e l’autore ammette che non è una prova di ragionamento spaziale visivo. Il giudice visione-linguaggio, davanti ai grafi interi, preferisce quelli del baseline quando quelli di RelateAnything sono più lunghi (a parità di lunghezza il verdetto si rovescia), e sulle singole relazioni accetta un po’ più spesso quelle del baseline: la precisione per arco, scrive l’autore, è un punto debole reale. Sui benchmark su cui sono addestrati, gli specialisti REACT e REACT++, dello stesso autore, hanno recall micro più alta, e REACT++ è più veloce. Diverse conclusioni poggiano su un solo seed.
Perché conta adesso
Un grafo di relazioni separa un elenco di oggetti da una descrizione della scena. Finora chi voleva le relazioni doveva accettare le etichette di un rilevatore preciso e un vocabolario fissato da benchmark come VG150, del 2017. RelateAnything le rende un componente da aggiungere accanto al rilevatore che si ha già, con le parole che servono, in tempo reale. Ma il contributo che rischia di durare di più è il più economico: riportare accanto a ogni recall quanta parte del corpus di addestramento dice già le stesse cose del benchmark. Se la classifica di un campo si può vincere con una tabella che non guarda l’immagine, prima di contare chi vince conviene chiedersi che cosa si sta contando.
I commenti sono riservati agli iscritti.
Accedi per commentare