
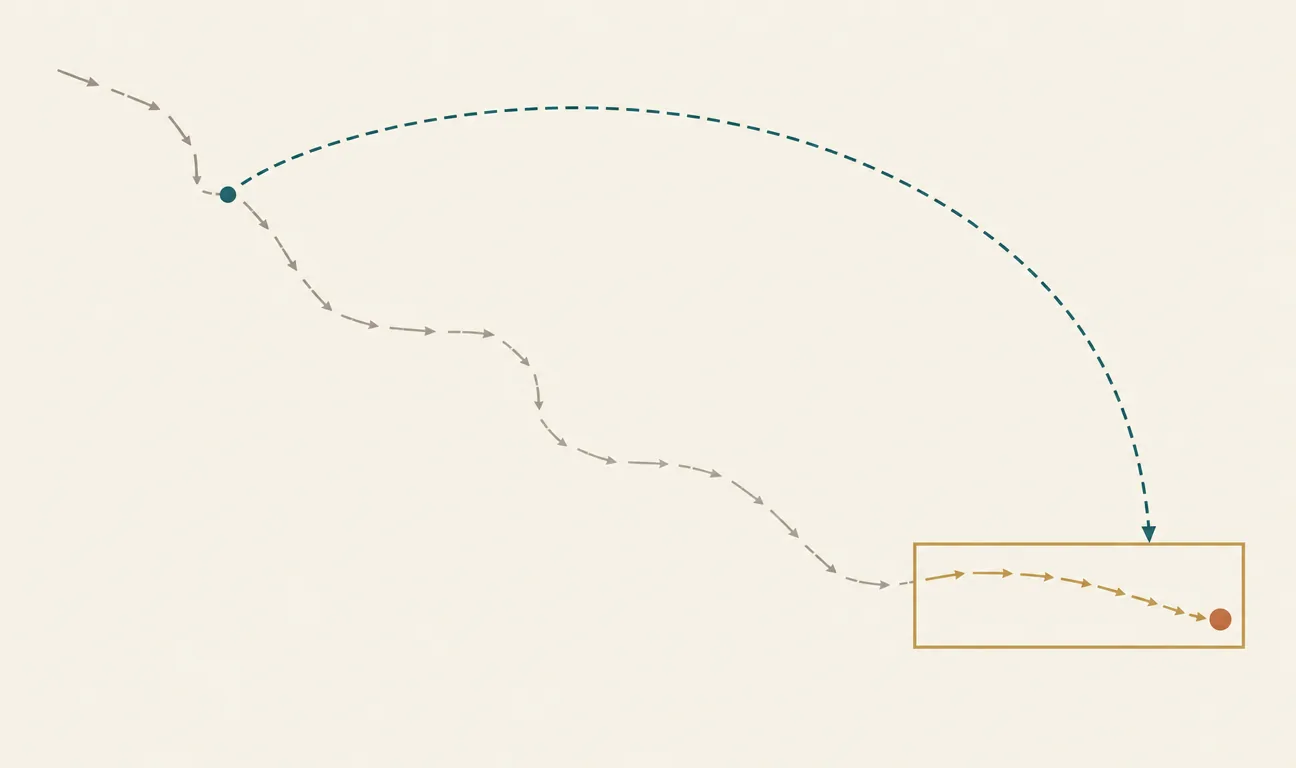
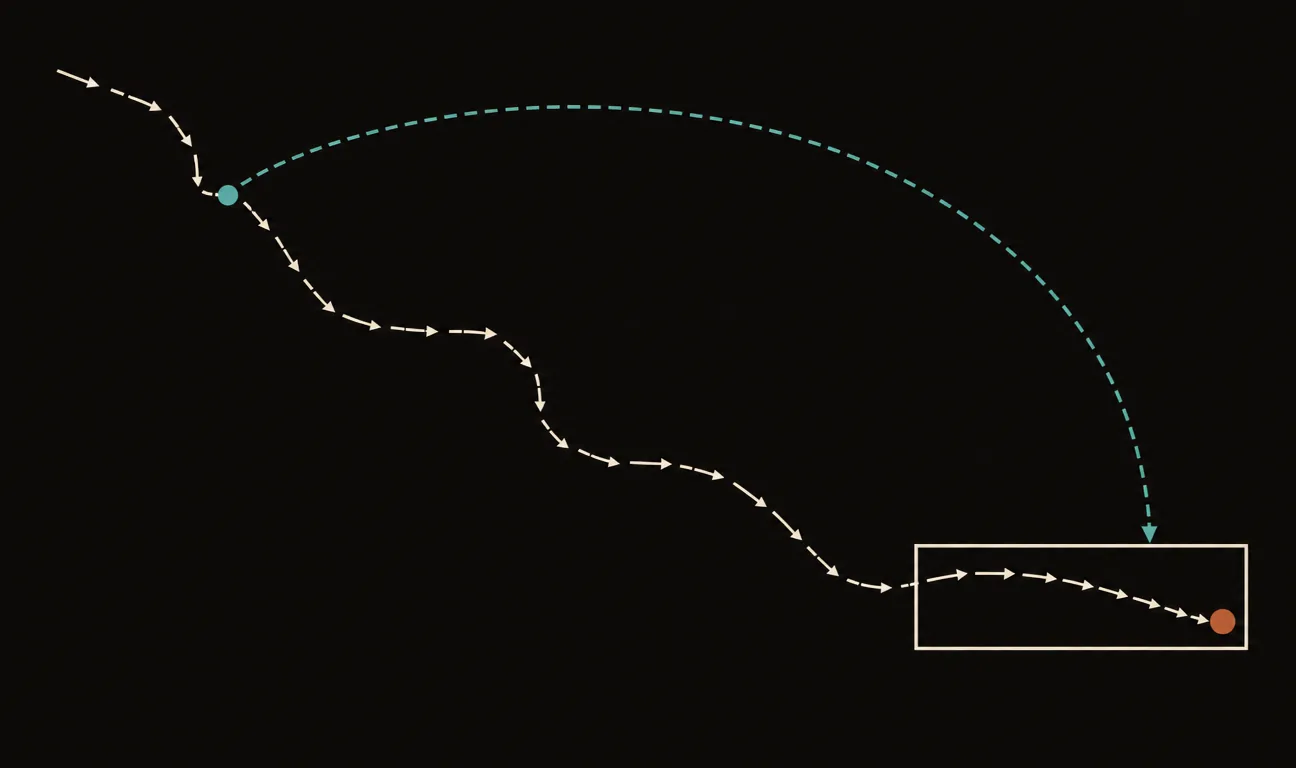
Prima del GPS, un navigatore in mare aperto sapeva dove si trovava con la navigazione stimata. Ogni ora annotava rotta, velocità e tempo trascorso, e sulla carta aggiungeva un segmento all’ultimo punto noto. Non gli serviva ricordare tutto il viaggio: gli bastava l’ultimo tratto, misurato bene. Il suo nemico era un altro: mezzo grado di errore sulla bussola non si vede in un’ora, ma dopo cento miglia porta la nave su un’altra costa. Per questo, appena avvistava un faro conosciuto, correggeva tutto il tracciato in un colpo solo.
È, quasi alla lettera, l’idea di Revisiting Local Context for Long-Horizon Streaming 3D Reconstruction, uscito su arXiv il 27 agosto 2026 (2608.27529) e firmato dall’AMAP CV Lab di Alibaba Group, il gruppo che lavora sulle mappe. Il modello si chiama ABot-Recon, e codice e pagina del progetto sono pubblici. Il titolo dice già la tesi: per ricostruire in 3D video lunghi decine di minuti non serve una memoria sempre più grande; serve fare bene il passo corto, e saperlo sommare.
Il problema, e la direzione presa dal campo
La ricostruzione in streaming chiede di stimare, fotogramma dopo fotogramma, dove si trova la telecamera e com’è fatta la scena, mentre il video arriva e con memoria e calcolo limitati. Serve a robot e guida autonoma. Da qualche anno la strada è quella dei modelli feed-forward alla DUSt3R e VGGT: una rete che da immagini senza posa ricava direttamente mappe di punti 3D e parametri della camera, senza la catena di passaggi della ricostruzione classica. Ma quei modelli lavorano su un insieme fisso di viste; un video di 18.000 fotogrammi è un’altra faccenda.
Che cosa sono la posa di una telecamera, la geometria fra più viste, la structure from motion e lo SLAM, cioè la ricostruzione classica che questi modelli provano a sostituire: è tutto nel capitolo sulla geometria della visione.
I metodi in streaming hanno risposto aggiungendo memoria: stati ricorrenti compatti, cache di attenzione, memorie spaziali esplicite, e negli ultimi mesi architetture che coordinano un contesto corto con uno lungo e persistente. LingBot-Map combina un contesto di ancoraggio, una finestra di riferimento per la posa e una memoria della traiettoria; HorizonStream affianca all’attenzione locale un’attenzione lineare persistente. Entrambi hanno superato i 10.000 fotogrammi. Il prezzo è che gestire, comprimere e fondere la storia è diventato il cuore dell’architettura.
Gli autori spostano la domanda: non quanta storia tenere, ma rispetto a che cosa si formulano le previsioni. Se posa e geometria si esprimono rispetto al primo fotogramma, più il video cresce più la distanza fra il presente e il riferimento aumenta, e il problema che il modello deve risolvere diventa più difficile a ogni passo. Se invece si esprimono rispetto al fotogramma appena precedente, il problema resta identico al passo 10 e al passo 10.000. È la vecchia logica dell’odometria visiva, portata dentro un predittore neurale in streaming.
Dodici fotogrammi e un prodotto
Per ogni fotogramma in arrivo ABot-Recon produce tre cose: una mappa di punti espressa nel sistema di riferimento della telecamera corrente, una mappa di confidenza e la trasformazione rigida $T_{i-1 \leftarrow i}$ che porta dal fotogramma precedente al corrente. L’attenzione fra fotogrammi vede solo le chiavi e i valori in cache degli ultimi $K-1 = 11$: dodici fotogrammi in tutto, compreso il presente. Quello che esce dalla finestra viene buttato. La memoria temporale è quindi $O(K)$, costante, e il calcolo su un video di $N$ fotogrammi cresce come $O(NK)$, cioè linearmente.
Che cosa contiene la cache di chiavi e valori, perché l’attenzione causale la rende possibile e che cosa si risparmia limitandola a una finestra: il meccanismo è spiegato nel capitolo sull’attenzione in pratica.
La traiettoria globale non la prevede nessuno: la si ottiene moltiplicando i passi, come il navigatore somma i segmenti sulla carta.
$$T_{i \leftarrow j} = \prod_{k=i+1}^{j} T_{k-1 \leftarrow k}$$
Le mappe di punti locali vengono poi portate nel riferimento globale con la stessa catena. Il modello di partenza non è costruito da zero: è inizializzato dai pesi pubblici di $\pi^3$, un ricostruttore feed-forward, a cui si toglie l’uscita di posa assoluta e si mette quella relativa, con attenzione causale a finestra. Il totale è circa un miliardo di parametri.
Il nemico è la rotazione
Il difetto di questa impostazione è lo stesso del navigatore: gli errori piccoli si moltiplicano. E sono soprattutto le rotazioni a fare danni, perché un grado sbagliato ruota tutto quello che viene dopo. Gli autori intervengono su due fronti.
Il primo è un raffinatore di rotazione. Per ogni coppia di fotogrammi adiacenti mette insieme un’evidenza di moto, ricavata dai token di camera, e un’evidenza visiva, pescata con una cross-attention nei token densi delle due immagini. Una piccola rete convoluzionale temporale causale con porta legge le ultime $K$ coppie e stima un residuo di rotazione $\delta\omega_i$, che corregge la stima iniziale:
$$\hat{R}_{i-1 \leftarrow i} = \tilde{R}_{i-1 \leftarrow i}\,\mathrm{Exp}\big([\delta\omega_i]_\times\big)$$
La traslazione non viene toccata: fra fotogrammi vicini, osservano gli autori, è più vincolata e stabile. Il modulo pesa 4,75 milioni di parametri, lo 0,48% del totale.
Il secondo è una perdita consapevole della composizione. Invece di controllare ogni passo da solo, l’addestramento compone i passi su tutti gli intervalli fino a $K-1$ fotogrammi e confronta il risultato con la verità, con un peso che cresce con la distanza, $\alpha_{ij} \propto (j-i)^{\gamma}$ con $0 < \gamma < 1$. È come correggere il navigatore non solo sull’ultima ora ma sull’intera giornata di rotta: l’errore che si accumula diventa visibile durante l’addestramento.
La ricetta di addestramento è pesante: 30 dataset, con i sintetici al 62% del campionamento e quasi l’8% di dati interni, sintetici e reali, non pubblici; una prima fase su clip da 32 fotogrammi con 48 GPU NVIDIA H20, una seconda su clip da 128 con 32 GPU AMD MI308, e una breve taratura della sola testa di confidenza. La finestra di previsione resta sempre di dodici fotogrammi: si allungano le clip, non il contesto.
I numeri
La valutazione usa tre banchi di prova sulla posa, e la misura principale è l’errore assoluto di traiettoria (ATE), in metri. Oxford Spires, dieci sequenze di circa 3.840 fotogrammi fra college, osservatorio e biblioteca di Oxford: ABot-Recon ha l’ATE più basso fra i metodi in streaming, con la riduzione di circa il 40% annunciata nell’abstract. Anche l’errore di rotazione relativo è più basso: 0,12 gradi contro 0,20 del migliore concorrente in streaming. KITTI, undici sequenze di guida: l’ATE medio è il più basso fra i metodi senza chiusura d’anello, compresi quelli a ottimizzazione.
Il terzo banco merita un cenno a parte: VBR, sette sequenze girate a Roma, fra Colosseo, Pincio, piazza di Spagna e Ciampino, da 8.815 a 18.846 fotogrammi, fino a 5,2 chilometri. Qui, senza chiusura d’anello, ABot-Recon non vince: è alla pari con gli altri due. Con la chiusura d’anello, invece, si stacca da HorizonStream con lo stesso aiuto, come già su KITTI. Il risultato migliore sulle sequenze più lunghe, insomma, arriva dal faro, non dal modello da solo.
| Metodo | Oxford Spires | KITTI | VBR |
|---|---|---|---|
| Senza chiusura d’anello | |||
| ABot-Recon | 4,35 | 18,25 | 30,14 |
| LingBot-Map | 7,32 | 29,13 | 29,45 |
| HorizonStream | 8,81 | 22,51 | 29,02 |
| Con chiusura d’anello | |||
| ABot-Recon | 4,02 | 13,49 | 9,99 |
| HorizonStream | 17,98 | 17,64 | |
Sull’efficienza, misurata su una H100 lungo i 4.661 fotogrammi di KITTI-02, ABot-Recon è più veloce dei due concorrenti principali e occupa meno memoria.
| Metodo | Fotogrammi al secondo | Memoria GPU, GB |
|---|---|---|
| ABot-Recon | 24,45 | 6,71 |
| LingBot-Map | 19,74 | 18,87 |
| HorizonStream | 8,02 | 13,04 |
LongStream occupa poco meno memoria (6,62 GB) ma va a 10 fotogrammi al secondo; CUT3R e TTT3R sono un po’ più veloci e più leggeri, ma su KITTI sbagliano la traiettoria di 209 e 181 metri in media. Sulla ricostruzione densa di Oxford Spires ABot-Recon ha la distanza di Chamfer più bassa (1,37 metri) e l’F1 più alto (91,81%).
Lo studio di ablazione racconta da dove viene il guadagno. Su KITTI la base addestrata passo per passo ha un ATE di 56,60 metri; la perdita sulla composizione lo dimezza a 27,66; le clip lunghe lo portano a 22,31; il raffinatore a 18,25. Qui il pezzo più economico, la perdita, è quello che conta di più; su Oxford Spires no: la perdita guadagna meno di un metro (da 10,16 a 9,40) e il salto maggiore viene dalle clip lunghe (fino a 5,95).
I limiti
I metodi a ottimizzazione restano davanti su Oxford. DPVO (1,56 metri), Droid-W (2,27) e DPV-SLAM (2,95) fanno meglio, e Droid-W è davanti anche sulla rotazione (0,08 gradi). Gli autori notano, correttamente, che quei sistemi richiedono i parametri intrinseci della telecamera mentre ABot-Recon lavora sul solo video RGB; ma il confronto dice che la partita con lo SLAM classico calibrato non è chiusa.
Negli interni stretti la memoria lunga serve ancora. Su 7Scenes e TUM-Dynamic la ricostruzione è competitiva ma non la migliore: su 7Scenes HorizonStream e LingBot-Map hanno un F1 più alto, su TUM-Dynamic ne fanno meglio quattro, fra cui TTT3R e LingBot-Map. Gli autori lo ammettono nella discussione e avanzano un’ipotesi, presentata come tale: dove la telecamera ripassa spesso sugli stessi punti, ricordare la scena conviene.
La deriva non sparisce, rallenta. Su VBR il modello da solo sbaglia di decine di metri, come i concorrenti. La chiusura d’anello, che recupera coppie di fotogrammi rivisitati con FAISS e descrittori DINOv2-SALAD e ottimizza un grafo di pose, fa buona parte del lavoro, e funziona solo se il percorso torna su sé stesso. La posa fra le coppie ritrovate la stima ABot-Recon, ma il grafo è un pezzo di SLAM classico, indipendente dall’addestramento: onesto dichiararlo, ma significa che il merito del risultato migliore è condiviso.
Riproducibilità parziale. Una parte dei dati di addestramento è interna, il calcolo è da grande laboratorio, e l’unico concorrente non riprodotto, SLAMFormer, è citato dal suo paper. Le scene dinamiche e i casi in cui la continuità locale diventa ambigua sono indicati come lavoro futuro.
Perché conta adesso
Negli ultimi anni la ricostruzione 3D in streaming ha seguito la stessa traiettoria dei modelli linguistici: più contesto, memorie più elaborate, gerarchie di stati. ABot-Recon è un controesempio misurato: una finestra di dodici fotogrammi, un predittore che risolve sempre lo stesso problema, e l’attenzione spostata su come si sommano i passi invece che su quanto si ricorda. Non vince ovunque, e sui percorsi più lunghi ha bisogno del faro. Ma memoria costante, 6,7 GB e 24 fotogrammi al secondo sono numeri che interessano a chi deve montare questi modelli su un robot o un’auto, anche se misurati su una H100 e non su un computer di bordo. E il fatto che venga da chi fa mappe per mestiere, con il codice pubblico, permette la verifica che conta: provarlo su strade che il paper non ha visto.
I commenti sono riservati agli iscritti.
Accedi per commentare