
Un buon barista di quartiere non ha un archivio: ha una memoria. Quando entri, prima ancora che tu apra bocca, ha già messo insieme due cose diverse. Una è un fatto: prendi il macchiato con il latte freddo, e la settimana scorsa avevi il colloquio di lavoro. L’altra è una lettura: oggi hai la faccia di chi è andato male. La risposta giusta, «allora, com’è andata?» detto con il tono giusto, nasce dall’incrocio delle due. E arriva subito: se il barista dovesse andare in magazzino a consultare uno schedario, il momento sarebbe passato.
È esattamente il problema che affronta VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction, uscito su arXiv il 26 agosto 2026 (2608.26005). Lo firmano Zhifei Xie e Jiaqi Lang come primi autori a pari merito, con colleghi di Nanyang Technological University, National University of Singapore, Tsinghua, Chinese University of Hong Kong e Open Interaction Lab; in chiusura Mingbao Lin, Chunyan Miao e Shuicheng Yan.
Perché le memorie di oggi non servono a chi parla
Le memorie a lungo termine per modelli linguistici esistono da un pezzo: Mem0, Zep, MemOS, EverMemOS. Funzionano più o meno tutte allo stesso modo: si salvano frammenti di conversazione, li si trasforma in vettori, e a ogni domanda si recuperano i più simili da mettere nel contesto del modello.
Qui si dà per noto come si recupera un testo per somiglianza fra vettori e come lo si passa al modello: embedding, ricerca e generazione aumentata sono costruiti passo per passo nel libro.
Gli autori individuano due attriti con i modelli vocali, quelli che ascoltano e rispondono a voce in tempo reale. Il primo è il tempo: una memoria classica impiega due o tre secondi fra ricerca ed elaborazione, mentre una conversazione naturale ne concede, dicono, 100–200 millisecondi in più prima che la pausa diventi imbarazzante. Il secondo è la quantità: gli agenti testuali recuperano spesso cento ricordi per domanda, troppi per il contesto di un modello vocale. Bisogna accontentarsi di cinque, e allora conta che siano i cinque giusti.
C’è poi un terzo attrito, meno tecnico. Una memoria costruita per i fatti non sa che cosa farsene delle emozioni. Sapere che hai una riunione ogni settimana con Bob è un fatto; sapere che quella riunione ti pesa è un’altra cosa, e non si conserva nello stesso modo.
Due emisferi, un indice sopra
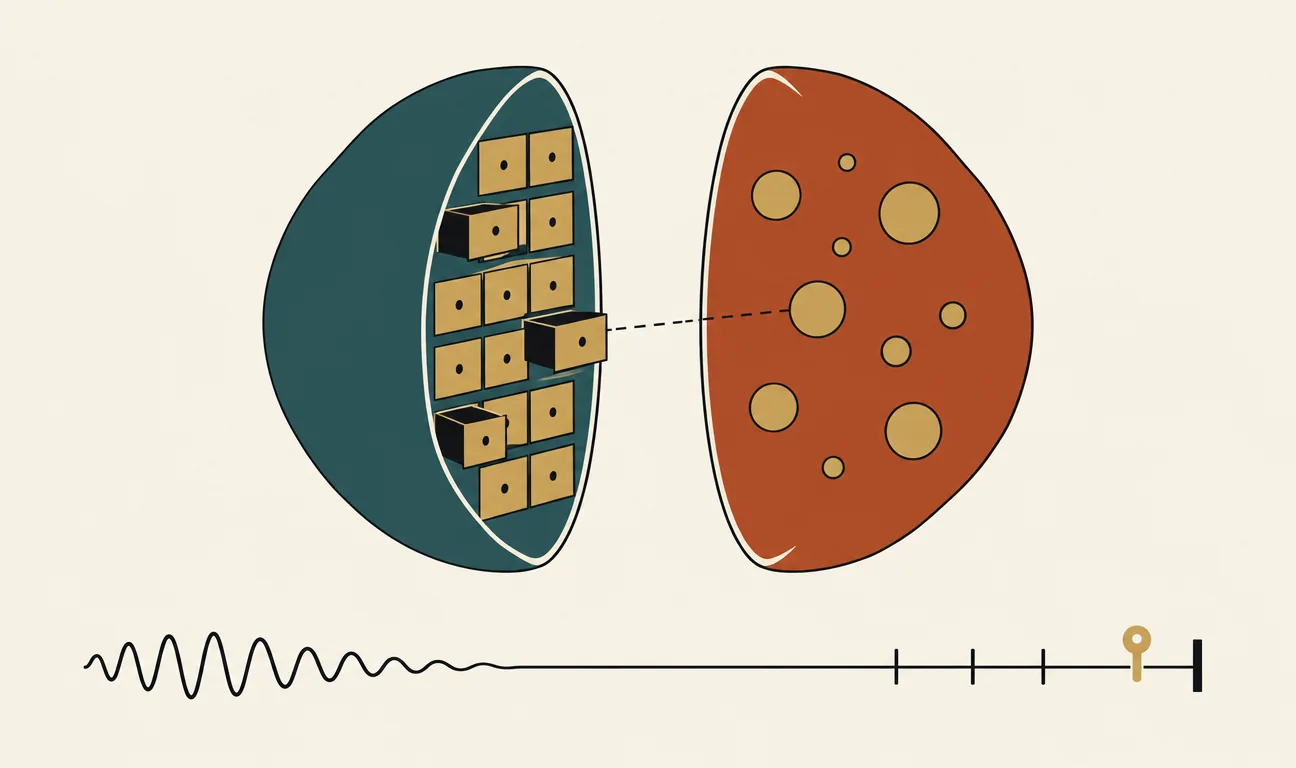
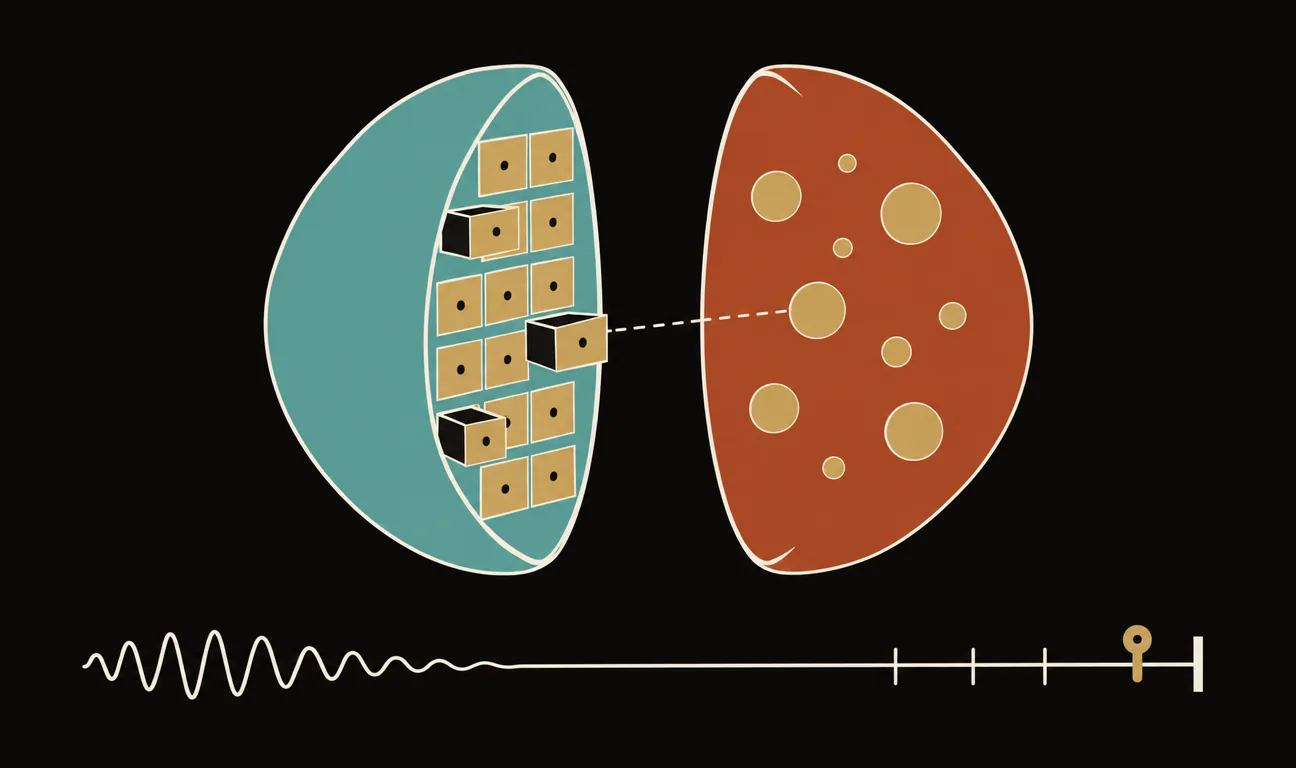
La proposta ha un’immagine volutamente semplice: un cervello a due emisferi che lavorano in parallelo.
L’emisfero sinistro tiene i fatti, ma non li cerca nel mucchio. Sopra i ricordi veri e propri, che restano nel motore sottostante (Mem0, nella versione principale), costruisce un indice leggero a due livelli: gli schemi, grandi cassetti tematici come lavoro, salute, relazioni, e dentro ciascuno le entità, cioè persone, eventi o concetti precisi. Mentre l’utente parla, un riconoscitore in streaming individua schemi ed entità nella trascrizione parziale, li allarga ai vicini diretti nel grafo, e solo i ricordi collegati a quel gruppo vengono poi cercati. L’idea è che con un budget di cinque risultati conti meno raffinare la classifica e più avere un bacino di candidati denso: niente cinque ricordi quasi uguali sulla stessa persona in contesti che non c’entrano.
I cassetti non restano quelli di partenza. Un meccanismo che gli autori chiamano di emergenza osserva quali entità vengono richiamate insieme dalle domande di una sessione e ne misura la coerenza:
$$\rho(H) = \frac{1}{|Q|} \sum_{q \in Q} \frac{|A_q \cap H|}{|A_q \cup H|},$$
dove $Q$ sono le domande della sessione, $A_q$ le entità attivate dalla domanda $q$ e $H$ un gruppo connesso di entità dentro un cassetto. Il gruppo più grande con coerenza sopra una soglia $\alpha$ passa a un modello linguistico che fa da giudice su pertinenza, importanza e completezza: solo se passa tutti e tre gli esami diventa un cassetto nuovo. Altrimenti viene marcato per non essere riproposto.
L’emisfero destro si occupa di chi è l’utente. Ha due tipi di nodi: quelli indipendenti, per i tratti stabili («si sente sempre solo»), e quelli incrociati, per le emozioni legate a un’entità dell’altro emisfero («non gli piace la riunione settimanale con Bob»). La distinzione, scrivono gli autori, evita due errori opposti: scambiare una reazione del momento per un tratto di carattere, o perdere l’oggetto a cui un’emozione si riferisce. I nodi si aggiornano su due scale di tempo: dentro il turno, a partire dall’emozione stimata sull’enunciato; a fine sessione, consolidando nei nodi indipendenti solo le regolarità che ricorrono.
Nascondersi nel silenzio
La parte più ingegneristica, e forse la più riutilizzabile, riguarda il tempo. Un assistente vocale non risponde appena smetti di parlare: aspetta che il rilevatore di attività vocale, il VAD, dichiari che hai finito davvero. Una soglia comune, scrivono gli autori, è 500 millisecondi. VoiceMem spezza la ricerca in fasi e le infila tutte dentro quell’attesa. Mentre parli, trascrizione, riconoscimento delle entità, stima dell’emozione e identificazione di chi parla procedono in streaming. Dopo 200 millisecondi di silenzio il sistema scommette che una risposta sta per servire: calcola il vettore della domanda ed espande i due grafi. Fra 400 e 500 millisecondi resta solo la ricerca vera nel motore sottostante. Per la ricerca nei due emisferi il paper dichiara 134 millisecondi.
Il resto del lavoro è infrastruttura. Gli autori addestrano varianti di Qwen2.5-Omni, Qwen3-Omni e Step-Audio2-Mini a usare la memoria, per distillazione online da modelli proprietari usati come maestri (Qwen3.5-Omni e Step-Audio2), e ne ricavano ChatMem-400K, un corpus di conversazioni che dipendono dalla memoria, e ChatMem-Bench, un benchmark con parti audio. L’indice è separato dal motore: Mem0 si può sostituire con un altro, e gli autori lo provano.
I numeri
Tutti i punteggi sono assegnati da un modello linguistico che fa da giudice, e la risposta la genera GPT-4o-mini, per i sistemi di confronto come per VoiceMem, salvo dove si dice altrimenti.
Memoria dei fatti. Su undici sottocategorie di LoCoMo, LongMemEval e Memora, VoiceMem ha una media di 76,39. Mem0, il suo stesso motore, si ferma a 52,27; il modello che vede l’intera cronologia a 60,49. Il margine più largo è sul ragionamento temporale di LongMemEval (+54,9 su Mem0). Il paper indica come il più stretto il tracciamento degli aggiornamenti (+7,4), ma la sua stessa tabella dice altro: su una sottocategoria di Memora VoiceMem resta sotto Mem0 di 2,1 punti. In quattro sottocategorie su undici non è primo.
Memoria della persona. Su ES-MemEval, PersonaMem e PersonaLens la media è 74,16, 1,89 punti sopra MemOS, il miglior concorrente; con il modello di risposta addestrato dagli autori sale a 76,56. Il vantaggio qui è modesto, e va letto come tale.
Audio. ChatMem-Bench ha 316 domande, tratte da 15.314 turni e 53 ore di dialogo. VoiceMem fa 68,73 di media contro 53,95 di MemOS. Il distacco più netto è dove la trascrizione non basta: in tre categorie acustiche (suoni di fondo, scena acustica, conversazioni con più utenti) i sistemi testuali stanno fra 3,23 e 26,92, VoiceMem fra 45,16 e 53,84. Nella quarta, l’adattamento allo stile acustico, stanno tutti sopra 90.
Costo e tempo. Su LoCoMo, con cinque ricordi recuperati, VoiceMem arriva a 91,2 usando 430 token di memoria; EverMemOS si ferma a 83,13 con 1.899 token. La latenza resta intorno a 134 millisecondi da tre a cento risultati, perché l’indice limita il bacino prima della ricerca. Togliere l’indice costa 9,9 punti su LoCoMo; togliere l’emisfero destro, 6,3. Montato su tre motori diversi, l’indice li migliora tutti, di 15,8–29,5 punti.
Che cosa non si può ancora controllare
Il paper non ha una sezione sui limiti, e qualche crepa si vede leggendo da vicino. La figura d’apertura parla di 160 millisecondi, il testo di 134, e i 134 non stanno nei 100 millisecondi che lo schema a fasi riserva alla ricerca. L’abstract confronta il top-5 di VoiceMem con Mem0 a top-200, un assetto che nel resto del paper non compare. Sulla persona, l’abstract del PDF dichiara 1,89 punti di vantaggio e quello della pagina arXiv 4,29: sono i due assetti, senza e con il modello di risposta degli autori. I dettagli dell’aggiornamento della memoria sono rimandati a un’appendice che non li contiene. Nell’introduzione i guadagni sono in percentuale relativa (+46,1% su Mem0), nelle tabelle in punti: numeri veri entrambi, ma i primi suonano più grandi.
Il benchmark sull’audio è degli autori. ChatMem-Bench è costruito dallo stesso gruppo con la stessa pipeline che produce i dati di addestramento, e la sua descrizione dettagliata è rimandata a un rapporto tecnico successivo. Sono 316 domande su quattordici categorie, in media poco più di venti per categoria: una risposta in più o in meno sposta il punteggio di quattro o cinque punti.
Il giudice è un modello. Tutti i punteggi dipendono da un valutatore automatico di cui il paper non dice il nome, e le latenze sono misurate sull’infrastruttura degli autori senza un dettaglio di hardware. Il paper non annuncia codice né pesi, ma fuori dal paper ci sono: un repository ufficiale su GitHub con licenza Apache 2.0, con il codice di valutazione e di addestramento, e su Hugging Face i modelli e ChatMem-400K. Chi vuole rifare le misure ha da dove partire.
E poi c’è quello che la memoria conserva. Impronte vocali, stati d’animo, tratti di carattere dedotti: sono dati personali di un tipo particolarmente delicato. In Europa l’impronta vocale usata per identificare qualcuno è un dato biometrico per il GDPR, e l’AI Act vieta i sistemi che deducono le emozioni sul posto di lavoro e a scuola, salvo ragioni mediche o di sicurezza. Il paper non ne parla, e non era tenuto a farlo; chi volesse portare un sistema così in un prodotto europeo dovrà farlo al posto suo.
Perché conta adesso
Nell’estate del 2026 i modelli vocali in tempo reale sono diventati prodotti: il paper cita GPT-live di OpenAI, di luglio, e SeedRealtime di ByteDance, di agosto, che ascoltano e parlano insieme senza turni rigidi. Quello che manca loro, sostengono gli autori, è una storia con chi gli parla. VoiceMem è un tentativo serio di dargliela senza rompere la cosa che li rende utilizzabili, la velocità, e l’idea più solida del paper è anche la più semplice: non cercare più in fretta, ma cercare in meno posti, e farlo nel tempo che l’assistente spreca comunque ad aspettare. Se i numeri reggeranno, misurati da altri e con altri giudici, lo si vedrà. Intanto il barista ha un modello: sapere chi sei, e ricordarselo prima che tu finisca la frase.
I commenti sono riservati agli iscritti.
Accedi per commentare