
Chi ha lavorato in una bottega artigiana conosce i due modi in cui un apprendista migliora. Il primo è il quaderno: il maestro dice «prima di tagliare, misura due volte», e la regola finisce scritta sulla prima pagina. Il secondo è la mano: a forza di tagliare, il gesto diventa sicuro anche senza guardare il quaderno. Le due cose si aiutano: le regole fanno lavorare meglio la mano, e una mano più esperta rende inutili alcune regole e ne fa servire di nuove.
È questa doppia strada che prova a percorrere ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents, uscito su arXiv il 15 settembre 2026 (2609.17523). Lo firmano tredici autori, con Shuhan Xue, Jianyuan Zhong e Ziyuan Nan a pari merito e tre autori corrispondenti (Zhenfei Yin, Yingcheng Wu, Ling Yang), nove dei quali di PhAI Labs, con altre affiliazioni che vanno da Fudan a Shunwei Capital, Oxford, Stanford e Princeton. È fra i paper in tendenza su Papers with Code, ed è insieme un prodotto e un metodo: gli autori rilasciano un ambiente di lavoro per ricercatori e descrivono il modo in cui l’agente che ci vive dentro dovrebbe migliorare usandolo.
Il banco di lavoro
ScienceBuddy è uno spazio di lavoro conversazionale per la ricerca, con strumenti e dati oggi specializzati in biomedicina: il ricercatore carica documenti, tabelle, sequenze biologiche e immagini, fa una domanda, e l’agente lavora in un ciclo di ragionamento, esecuzione di codice (Python, R, Bash) e osservazione. Ha a disposizione 224 strumenti in 22 moduli (genomica, biologia molecolare e oncologica, farmacologia, bioimaging, ricerca bibliografica, interrogazione di banche dati), derivati dal catalogo di Biomni, più un data lake locale. Ogni chiamata a uno strumento resta ispezionabile, con i suoi input e output.
La scelta architetturale che rende possibile il resto è la separazione fra l’infrastruttura e l’harness: le istruzioni, le skill riutilizzabili e le regole di gestione del contesto che organizzano il comportamento del modello. L’infrastruttura (strumenti, esecuzione, archivio) resta fissa; l’harness è il pezzo che si può modificare e misurare. E il modello sotto è a sua volta intercambiabile.
Qui si dà per noto il ciclo di un agente (ragiona, chiama uno strumento, osserva il risultato, ripete), che il libro costruisce da capo.
Dalla conversazione al compito
Il primo passo del metodo è trasformare la collaborazione in materiale di addestramento. Una conversazione con un ricercatore contiene richieste, precisazioni, correzioni, file prodotti. Da questo materiale il sistema ricostruisce un compito autonomo (istruzioni, dati in ingresso, ambiente di esecuzione) e una rubrica, cioè una griglia di criteri: il perimetro del compito, i requisiti di metodo, le prove da citare, gli artefatti da consegnare. Il tutto è confezionato nel formato Harbor per compiti eseguibili.
La parte più onesta del disegno: la risposta che l’agente aveva dato nella conversazione originale non entra nel compito, e l’approvazione del ricercatore non viene trattata automaticamente come verità scientifica. La conversazione dice che cosa andava fatto, non che cosa era giusto.
Il voto di una traiettoria $\tau$ su un compito $x$ è la media pesata della soddisfazione dei criteri:
$$R_x(\tau) = \frac{\sum_{c \in \mathcal{C}(x)} w_c(x)\, v_c(x,\tau)}{\sum_{c \in \mathcal{C}(x)} w_c(x)}$$
dove ogni criterio $c$ ha un peso $w_c(x)$ fissato prima di valutare e un punteggio $v_c(x,\tau)$ fra 0 e 1, calcolato con un controllo eseguibile quando c’è e con un modello giudice fisso quando il criterio richiede interpretazione scientifica.
Due giri, uno dentro l’altro
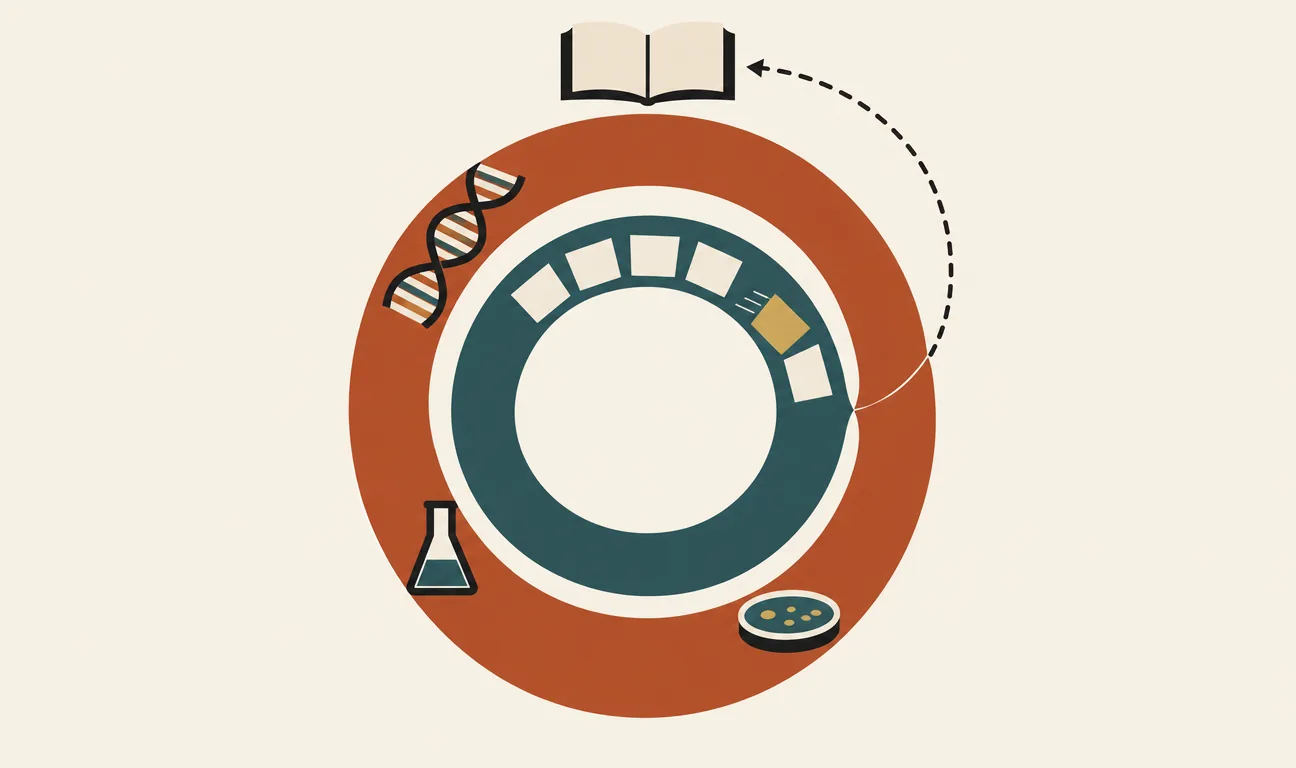
Il cuore del paper è quello che gli autori chiamano auto-miglioramento «ricorsivo nel ricorsivo»: due cicli annidati, che la figura mette in fila.
Nel ciclo interno il modello che fa il lavoro resta fermo. Un secondo modello, anch’esso fisso (nel paper è GPT-6 Astra), legge le traiettorie recenti e i voti delle rubriche, individua i criteri non soddisfatti citando le azioni che li hanno mancati, e propone una sola modifica circoscritta: aggiungere, togliere o riscrivere una skill, ritoccare un’istruzione, cambiare un’impostazione di contesto. Un controllo di schema impedisce di toccare altro: strumenti, rubriche e valutatori restano intatti. La regola di accettazione è semplice:
$$H_{k,j+1} = \begin{cases} \tilde H_{k,j+1} & \text{se } \mathrm{Valid}(\tilde H_{k,j+1}) \wedge \Delta_{k,j} > 0 \\ H_{k,j} & \text{altrimenti} \end{cases}$$
dove $\Delta_{k,j}$ è la differenza di punteggio medio fra il candidato e l’harness corrente, misurata sugli stessi compiti di sviluppo, con gli stessi semi e lo stesso budget, compresi quelli già risolti, per accorgersi delle regressioni.
Nel ciclo esterno si ferma l’harness e si muovono i pesi. Prima si ricalibra la difficoltà dei compiti (quelli diventati facili con il nuovo harness servono poco), generando varianti con dati o condizioni diverse; poi si addestra il modello con GRPO, usando $R_x(\tau)$ come ricompensa su traiettorie fresche. Infine si rimette alla prova l’harness ereditato con il modello nuovo, perché un procedimento utile a un modello può non esserlo per la sua versione migliorata. La coppia aggiornata torna in servizio, che per progetto resta attivo durante gli aggiornamenti.
GRPO, il reinforcement learning che confronta più risposte allo stesso compito invece di stimare un valore assoluto, qui si usa senza spiegarlo: come funziona il post-addestramento con ricompense sta nel libro.
L’idea di far evolvere insieme harness e pesi non è nuova, e gli autori lo dicono: citano SIA e HELIX come precedenti diretti. Il contributo dichiarato è l’annidamento, e il fatto che compiti e criteri vengano dalla collaborazione anziché da un benchmark scritto a tavolino.
I numeri
Le prove attingono a una collezione di 895 compiti di quattro famiglie tratte da LAB-Bench e Biomni-Eval1: lettura di letteratura scientifica (LitQA2, 96), interrogazioni di banche dati (DbQA, 511), diagnosi degli errori nei protocolli sperimentali (ProtocolQA, 108), individuazione di geni causali e varianti (GWAS, 180). Il modello che lavora è piccolo: Qwen3.5-4B.
Harness e pesi insieme. Tre cicli completi, ciascuno con dieci passi sull’harness e venti aggiornamenti RL. Dentro ogni ciclo l’harness alza l’accuratezza di validazione, misurata sullo stesso insieme usato per scegliere, dove per costruzione non può scendere.
| Ciclo | Inizio | Fine |
|---|---|---|
| Primo | 38,9% | 44,4% |
| Secondo | 34,4% | 46,7% |
| Terzo | 61,1% | 70,0% |
La ricompensa media di addestramento, intanto, sale fra la prima e la seconda metà di ogni fase RL. Sul test tenuto da parte, al primo tentativo, il sistema passa dal 42,2 al 73,3%. Il 33,3% dei problemi passa da sbagliato a giusto, il 2,2% fa il percorso inverso, e i guadagni toccano tutte e quattro le famiglie.
Solo l’harness. A pesi fermi, 24 aggiornamenti dopo altrettanti lotti di 12 conversazioni, 288 in tutto. L’harness finale contiene quattro istruzioni e nove skill, quasi tutte pratiche: eseguire Python, ispezionare risorse e schemi dei dati, cercare un record in modo circoscritto, consegnare esplicitamente la risposta, e poi procedure più specifiche come verificare l’appartenenza di un gene a un insieme o risalire alla banda citogenetica. Sul set di validazione l’accuratezza alla prima risposta passa dal 31,1 al 51,1%: venti punti senza toccare un peso, rispetto a un harness di partenza senza istruzioni né skill aggiunte.
Solo i pesi. Con l’harness iniziale fermo, circa due ore di RL. Qui la misura è un’altra, la copertura: la quota di problemi risolti almeno una volta su quattro tentativi, che sale dal 48,3 al 67,8%.
Che cosa non dice
Gli autori chiamano i loro esperimenti «casi di studio», e il termine è preciso. Non c’è nessun confronto con altri metodi di evoluzione dell’harness o di addestramento, né con un harness scritto a mano; nessun intervallo di confidenza; nessuna ripetizione con semi diversi. Il numero di problemi di test non compare nel testo, ma le percentuali (42,2, 73,3, 2,2) sono tutte multipli di 1/45: compatibili con 45 problemi, dove uno in più o in meno vale oltre due punti, o con 90.
Il limite più importante riguarda il ricercatore. Nel giro sperimentale sull’harness, il «feedback degli utenti» è prodotto da un simulatore, un modello Qwen3.8-27B, che sceglie da un elenco chiuso di risposte ammesse (una conferma, una richiesta di formato, un invito a ricontrollare o rivedere), sapendo se la risposta dell’agente è giusta. Le interazioni con ricercatori veri compaiono solo in esempi qualitativi, come i due casi su JAK1 e ARL4C, e la trasformazione delle loro richieste in rubriche è dichiarata «illustrativa», non un pacchetto archiviato e valutato. L’anello più originale del sistema, dalla conversazione reale al compito, è quindi descritto ma non misurato: i numeri vengono da benchmark con risposta nota.
Altre osservazioni il lettore può farle da sé. A diagnosticare e riscrivere l’harness di un modello da 4 miliardi di parametri è un modello di frontiera: parte del guadagno potrebbe essere competenza procedurale trasferita dal modello più grande, e il paper non lo separa. Gli stessi autori ammettono che l’effetto delle singole modifiche non è isolato, e che il loro «riflettore» resta fisso, quindi un compito svolto meglio non significa che il meccanismo di miglioramento sia diventato più bravo. Una piccola svista: la sezione si intitola alla dinamica «a due cicli», ma il testo e la figura ne descrivono tre. C’è poi un dato che il paper non commenta: il secondo ciclo riparte dal 34,4%, sotto il 44,4% con cui si era chiuso il primo; il terzo dal 61,1%, sopra il 46,7%. Se quel punto è, come suggerisce l’algoritmo, l’harness ereditato misurato con il modello aggiornato, è l’interazione fra procedure e pesi che giustifica la rivalutazione; ma con due soli passaggi non si distingue un effetto dal rumore.
Perché conta adesso
Il 2026 è affollato di sistemi che si migliorano da soli, e fra quelli che il paper cita la maggior parte lavora su un piano solo: o le procedure, o i pesi. ScienceBuddy ha il merito di prendere sul serio il fatto che i due piani si influenzano, e di costruire l’infrastruttura (compiti eseguibili, rubriche fisse, versioni conservate, valutazioni a coppie) perché questo si possa misurare in un prodotto che resta in servizio. La parte più riusabile è la disciplina: una modifica alla volta, lo stesso banco di prova per il vecchio e il nuovo, l’approvazione dell’utente trattata come segnale e non come verità.
La promessa più ambiziosa, un agente che impara dai ricercatori che lo usano, resta invece da dimostrare. Il paper mostra che l’apprendista migliora con un quaderno scritto da un maestro più grande su indicazione di un cliente simulato, e con esercizi presi da un eserciziario più che dalla bottega. Se migliorerà anche nella bottega vera, con ricercatori che correggono in modo imprevedibile e a volte sbagliano, lo diranno i dati che il prodotto rilasciato dovrebbe raccogliere. Il codice è annunciato nel repository Gen-Verse/ScienceBuddy.
I commenti sono riservati agli iscritti.
Accedi per commentare