
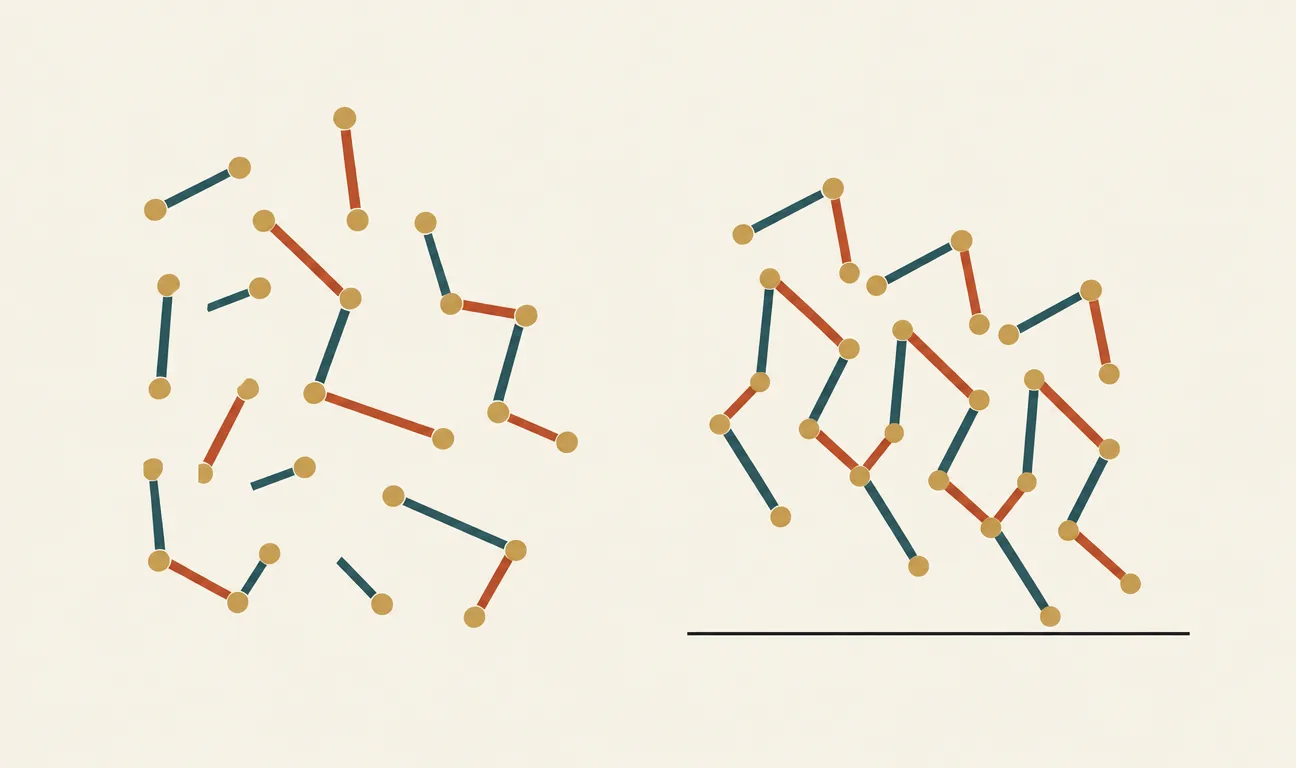
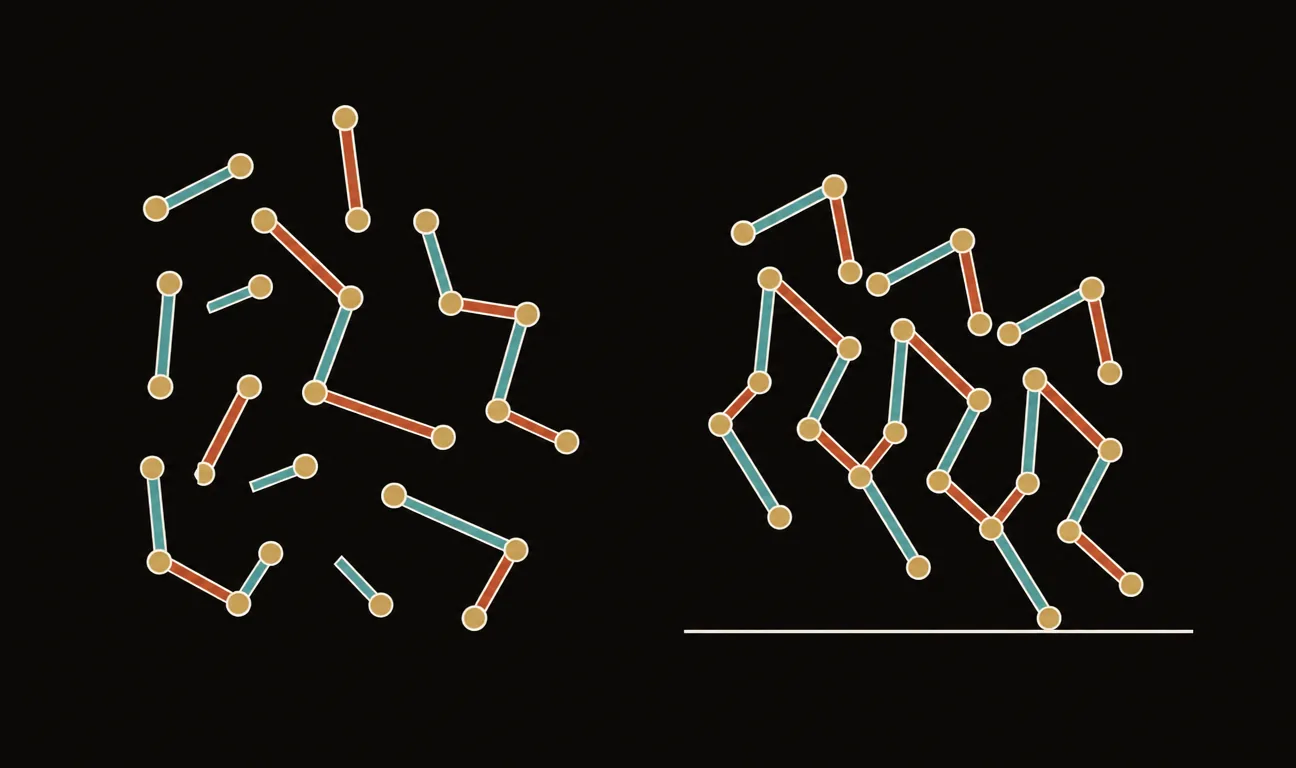
Chi ha imparato a disegnare con un manichino di legno sa che si può piegarlo in quasi tutti i modi, ma non in tutti. Le giunture girano, gli arti restano lunghi uguali, la testa sta sul collo. Se invece si prendono le palline delle giunture di un disegno a stecchini e le si sposta ciascuna un po’ a caso, quello che resta non è un uomo in una posa strana: è una manciata di punti. Il manichino ha dei vincoli, e sono proprio quelli a renderlo utile.
Su questa differenza è costruito STEP: Score-Based Temporal Energy for Human Pose Video Anomaly Detection, uscito su arXiv il 20 agosto 2026 (2608.19987). Lo firmano Jakub Micorek e Horst Possegger dell’Università Tecnica di Graz e Mateusz Koziński dell’Università di Medicina di Graz. Tutti e tre firmavano già MULDE (CVPR 2024), il metodo che STEP corregge.
Il problema: imparare il normale senza esempi di anomalo
Il compito si chiama video anomaly detection: segnalare in un video di sorveglianza il momento in cui qualcuno fa qualcosa di insolito, una caduta, una rissa, una bicicletta su un marciapiede pedonale. In addestramento, però, ci sono solo esempi normali: il sistema deve imparare il normale e riconoscere il resto per differenza.
La variante che interessa qui lavora sugli scheletri. Un rilevatore di pose già pronto (AlphaPose, 18 punti per persona) trasforma ogni persona inquadrata in una sequenza di coordinate; il modello di anomalie vede solo quelle. Si perdono volti, vestiti, sfondo, e gli autori lo rivendicano: meno dipendenza dallo scenario, meno esposizione a bias demografici legati all’aspetto, maggiore rispetto della privacy.
I metodi più vecchi considerano anomalo ciò che una rete ricostruisce male, ma nulla garantisce che un’anomalia venga ricostruita peggio. L’alternativa è stimare direttamente quanto una sequenza sia improbabile sotto la distribuzione del normale. È quello che faceva MULDE con un modello a energia: una rete $f_\theta$ che assegna a ogni campione un numero, bassa energia per il probabile e alta per l’improbabile.
Che cos’è un modello a energia, perché la costante di normalizzazione è il suo ostacolo e come il denoising score matching lo aggira imparando il gradiente invece della densità: è tutto nel libro.
Dove si rompeva il metodo precedente
Il modello a energia si addestra con il denoising score matching: si prende un campione normale $\mathbf{x}$, gli si aggiunge rumore gaussiano di ampiezza $\sigma$, e si chiede al gradiente della rete di indicare la strada per tornare indietro. MULDE lo fa su più scale di rumore insieme:
$$\min_\theta \; \mathbb{E}\, \lambda(\sigma) \left\| \nabla_{\tilde{\mathbf{x}}} f_\theta(\tilde{\mathbf{x}}, \sigma) – \frac{\tilde{\mathbf{x}} – \mathbf{x}}{\sigma^2} \right\|_2^2 .$$
Il problema è che cosa sia $\tilde{\mathbf{x}}$ quando $\mathbf{x}$ è uno scheletro. Rumore indipendente su ogni coordinata di ogni articolazione è esattamente il gioco delle palline spostate a caso: le ossa si allungano e si accorciano, le simmetrie saltano, e la rete spende la sua capacità a descrivere corpi impossibili invece dei confini del movimento normale. Con più fotogrammi insieme la cosa peggiora, perché lo spazio dei corpi impossibili cresce con la dimensione.
La tabella di ablazione lo mostra su UBnormal. MULDE sulle coordinate grezze, riprodotto dagli autori, tocca il massimo con appena due fotogrammi (80,7% di AUROC) e scende al 70,6% con una finestra di 32. Aggiungere la sola ponderazione per fiducia, di cui diremo, alza tutta la curva ma non la raddrizza: si passa dall’87,2% con due fotogrammi al 73,1% con 32.
La correzione: il rumore si aggiunge altrove
Il primo intervento di STEP non tocca la forma dell’obiettivo: cambia lo spazio in cui lo si applica. La sequenza di pose passa per un’analisi delle componenti principali stimata sui dati normali, tenendo le prime $K$ componenti e dividendo ciascuna per la propria deviazione standard (lo whitening):
$$\pi(\mathbf{x}) = \Lambda_K^{-1/2}\, W_K^{\top} (\mathbf{x} – \mu).$$
Nello spazio che ne esce, ogni direzione è una combinazione dei modi di variare più frequenti nei dati. Gli autori lo mostrano spostando una posa ferma lungo le prime due componenti: la prima la fa camminare attraverso l’inquadratura, la seconda verso la telecamera o lontano da essa. La tesi del paper, sostenuta da esempi visivi e dalle ablazioni, è che qui il rumore gaussiano generi varianti plausibili di un movimento umano, non corpi smontati.
Tenere solo le prime componenti, poi, taglia le variazioni ad alta frequenza, in buona parte il tremolio del rilevatore da un fotogramma all’altro: la PCA fa anche da filtro passa basso. Messa a confronto con un autoencoder semplice e uno variazionale, la PCA ha dato i risultati migliori, con l’autoencoder semplice a un punto. Nemmeno lo whitening è un dettaglio: senza, il rumore isotropo sommerge le componenti a bassa varianza e sfiora appena quelle dominanti, e su UBnormal si perdono 2,2 punti.
Come si trovano le componenti principali e perché tenerne solo $K$ perde i dettagli fini: la PCA come compressione è nel libro.
Fidarsi poco delle pose incerte
Il secondo intervento riguarda un’ipotesi che, secondo gli autori, i metodi a scheletro esistenti fanno in silenzio: che le pose estratte siano verità. Nelle riprese vere ci sono occlusioni, sfocature, articolazioni perse, e un modello a energia addestrato su pose sbagliate impara a considerarle normali; al test, una persona seduta su una panchina e in parte coperta rischia di sembrare anomala solo perché la sua posa è stimata male (è uno degli esempi in appendice).
STEP usa la fiducia media $c(\mathbf{x}) \in [0,1]$ che AlphaPose restituisce per la sequenza, due volte. In addestramento moltiplica per $c(\mathbf{x})$ il termine di perdita di ogni sequenza, così le pose dubbie contano meno senza essere buttate. Al test standardizza l’energia a ciascuna scala di rumore con media e varianza calcolate sul training, prende il massimo e lo moltiplica ancora per la fiducia:
$$A(\mathbf{x}) = c(\mathbf{x}) \, \max_i \frac{f(\pi(\mathbf{x}), \sigma_i) – \bar{E}_i}{\sqrt{\mathrm{Var}(E_i)}}.$$
L’alternativa diffusa è scartare le pose sotto una soglia di fiducia, come fa SeeKer. Con una soglia bassissima (0,1) si guadagna un decimo di punto; con 0,4 si perdono 4,5 punti su UBnormal perché, spiegano gli autori, si butta via proprio la varietà dei movimenti veloci o parzialmente coperti che il modello doveva imparare a considerare normali.
Il terzo ritocco è architetturale: un MLP residuale in cui la scala di rumore $\sigma$ entra in ogni blocco invece che solo all’ingresso. Vale circa un punto (1,1 su UBnormal, 0,7 su ShanghaiTech).
I numeri
La configurazione finale guarda 12 fotogrammi e tiene 48 componenti principali, scelte sul set di validazione di UBnormal. Il metro è l’AUROC calcolato su tutti i fotogrammi del test, con lo stesso lisciamento temporale dei lavori precedenti, e i risultati principali sono medie su 20 addestramenti indipendenti.
Su UBnormal, un dataset sintetico e fotorealistico di 29 scene virtuali, STEP stacca il migliore metodo a scheletro precedente, SeeKer (ICCV 2025): da qui i 12,2 punti rivendicati nell’abstract. Sulla parte con anomalie legate a persone arriva al 90,9%. Su ShanghaiTech, riprese reali di 13 scene, il guadagno è minimo; in precisione media (AP), però, il margine su SeeKer è più largo che in AUROC. Su MSAD, terzo dataset di riprese reali, sulle sole anomalie umane STEP ha due punteggi, secondo il modo di costruire quello split, e SeeKer non dice quale abbia usato.
| Dataset | STEP | Confronto |
|---|---|---|
| UBnormal, test completo | 90,1% ±0,4 | 77,9% SeeKer |
| ShanghaiTech | 86,2% | 85,9% STG-NF |
| ShanghaiTech, anomalie legate a persone | 87,7% | 87,4% |
| ShanghaiTech, precisione media (AP) | 84,3% | 80,0% SeeKer |
| MSAD, anomalie umane | 74,1% 71,6% con l’altro split | 61,1% SeeKer |
Il costo è piccolo: su una GTX 1080, dalle pose già tracciate al punteggio, 50 persone per fotogramma richiedono meno di un millisecondo, 100 persone 1,62. Il collo di bottiglia, dicono gli autori, resta il rilevatore di pose a monte, di cui però il paper non riporta i tempi.
Che cosa misura l’area sotto la curva ROC e perché su classi sbilanciate conviene guardare anche la precisione media: è nel capitolo sulla valutazione.
Da dove viene davvero il salto
Il paper stesso offre due numeri che ridimensionano il titolo. Il primo: MULDE applicato a una posa singola, senza alcuna modellazione temporale e riprodotto dagli autori, fa già l’80,6% su UBnormal, sopra SeeKer. Rispetto al suo predecessore diretto, quindi, STEP guadagna circa nove punti e mezzo, non dodici. Il secondo, in appendice: una baseline banale, proiezione PCA più distanza dal vicino più prossimo nel training, senza reti neurali, fa 81,3% sempre su UBnormal (su ShanghaiTech si ferma all’83,0%, sotto SeeKer). La lezione, almeno su UBnormal, è che due approcci semplici superavano già lo stato dell’arte precedente: una parte del divario non veniva dalla sofisticazione dei modelli. Il resto, quasi nove punti sopra la baseline, lo aggiungono il modello a energia nello spazio PCA e la ponderazione per fiducia.
Una cautela: le ablazioni usano un seme fisso, e parecchie differenze fra varianti sono di qualche decimo, la stessa taglia della variabilità fra addestramenti.
I limiti
Il salto grande è su dati sintetici. Su UBnormal le anomalie sono spesso vistose (investimenti, cadute a terra, corse scomposte); su ShanghaiTech, l’unico banco di prova con riprese reali fra i due principali, STEP pareggia con STG-NF entro tre decimi di punto, e in appendice la versione di MULDE che usa anche feature visive e di movimento arriva all’86,7%, sopra STEP.
Dove il rilevatore non vede, STEP non vede. Gli autori mostrano una scena di UBnormal in cui, nella nebbia, il tracker perde una persona che si accascia per un malore: nessuno scheletro, nessun punteggio.
Il normale è quello del training. Su ShanghaiTech una persona che si gira e cammina all’indietro riceve un punteggio elevato senza che il dataset la consideri un’anomalia: il modello ha imparato che si cammina in avanti. E un modello addestrato su UBnormal, provato su ShanghaiTech, fa 77,2% invece dell’86,3% di quello addestrato lì.
Una persona alla volta. Ogni soggetto è valutato da solo, senza oggetti né contesto: uno scambio di merce illecito o una borsa abbandonata sfuggono se le pose restano ordinarie. Reintrodurre l’aspetto visivo aiuterebbe, osservano gli autori, ma toglierebbe proprio la tutela della privacy che giustifica il lavoro sugli scheletri.
Perché conta adesso
La video anomaly detection è visione artificiale al servizio della sorveglianza, e lavorare su scheletri invece che su volti e vestiti è una delle poche direzioni in cui accuratezza e riservatezza non si escludono. Anche uno scheletro, però, resta una persona osservata: se e dove usarlo resta una scelta da fare fuori dal paper. Il cuore di STEP non è la rete, il cui ritocco vale un punto: è uno strumento che ha più di un secolo, la PCA, messo al posto giusto nella catena di un modello a energia. Il risultato più utile è forse proprio la baseline in appendice: prima di costruire una rete più grande, vale la pena di chiedersi in che spazio si sta aggiungendo il rumore.
I commenti sono riservati agli iscritti.
Accedi per commentare