
Prendete le 70.000 cifre scritte a mano del dataset MNIST: ogni immagine è un punto in 784 dimensioni, una per pixel. Passatele alla PCA e proiettatele su un piano: otterrete una nuvola confusa dove i 4 si mescolano ai 9 e i 3 agli 8. Passatele a t-SNE e otterrete dieci isole nitide, una per cifra, con i 4 e i 9 vicini tra loro ma distinti — un risultato così pulito da sembrare truccato. Non lo è. Ma non è nemmeno una fotografia fedele dei dati: è una mappa. E come tutte le mappe, per essere leggibile deve deformare qualcosa. Capire cosa deforma è tutto quello che serve per usare bene t-SNE e UMAP — e per non farsi raccontare storie che nei dati non ci sono.
La maledizione della dimensionalità, la PCA, t-SNE e UMAP, e i metodi di raggruppamento: tutto nel libro.
Leggi «Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato» nel libro →
Dove la PCA si arrende
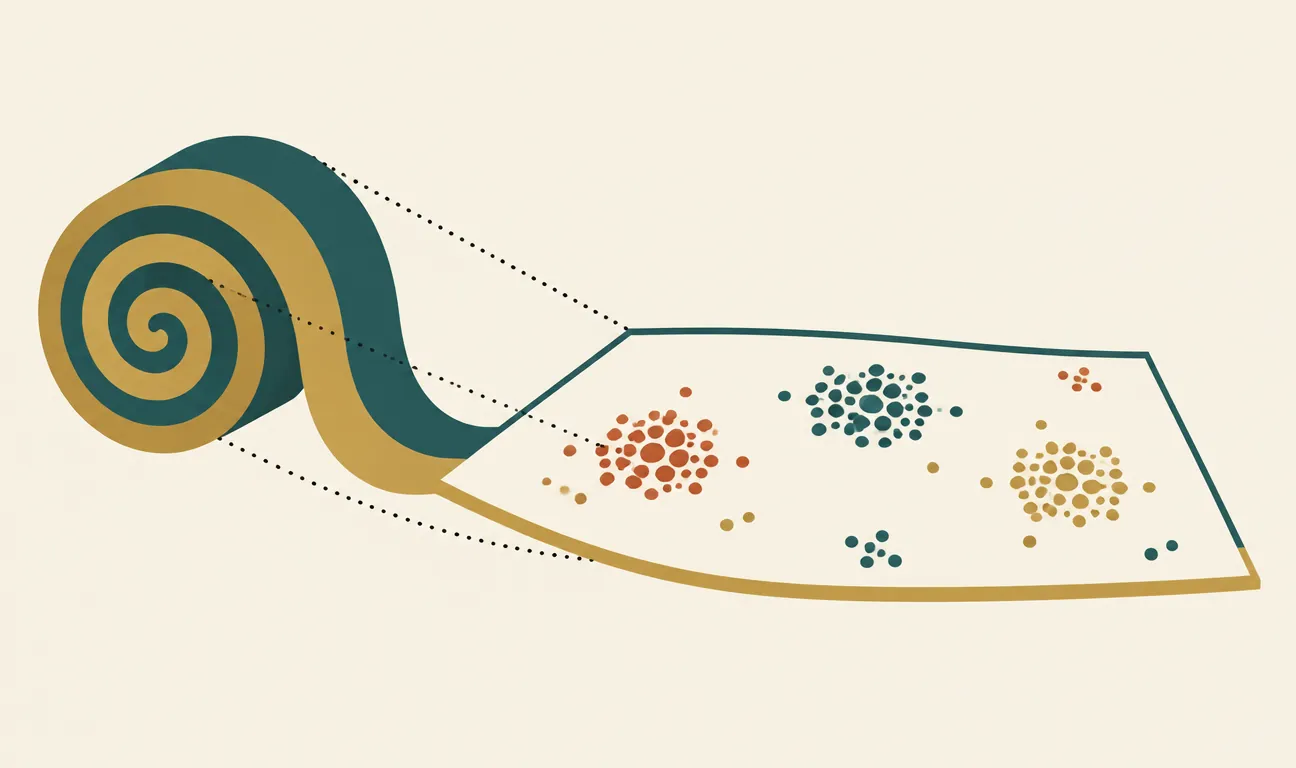
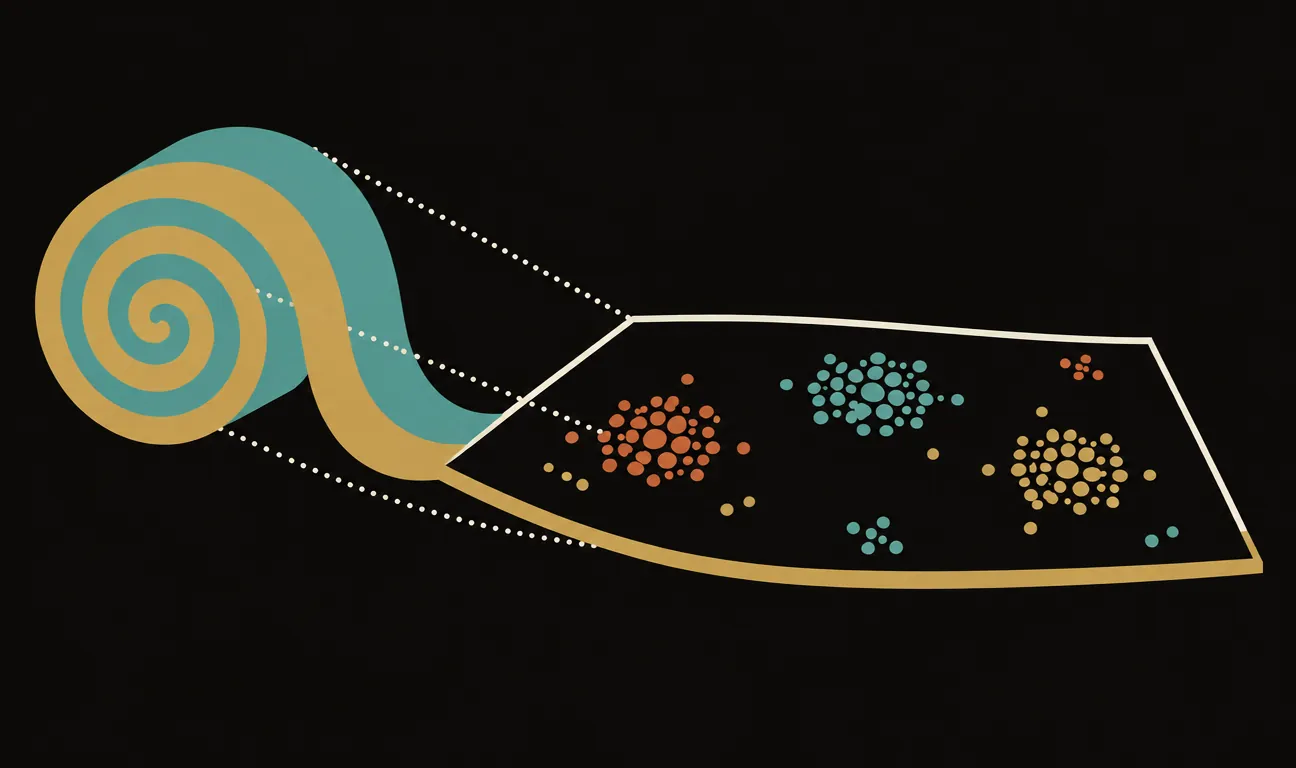
Nell’articolo precedente abbiamo visto che la PCA trova le direzioni lineari di massima varianza: ruota gli assi e schiaccia la nuvola sul piano migliore. Funziona finché i dati sono, appunto, una nuvola allungata. Ma i dati reali ad alta dimensione spesso vivono su superfici curve: pensate a un foglio di carta arrotolato a spirale dentro una scatola. Il foglio è intrinsecamente bidimensionale, ma nessuna proiezione lineare lo srotola — qualsiasi schiacciamento fa collassare spire diverse una sull’altra, mescolando punti che sul foglio erano lontanissimi.
Serve un approccio diverso: rinunciare a preservare le distanze globali e concentrarsi sui vicinati. Non chiedere «dove sta questo punto nello spazio?» ma «chi sono i suoi vicini?». Se ogni punto della mappa 2D ha gli stessi vicini che aveva in 784 dimensioni, la struttura locale è salva — e per capire i cluster di un dataset, la struttura locale è quella che conta.
t-SNE: un gioco di attrazioni e repulsioni
t-SNE (t-distributed Stochastic Neighbor Embedding, proposto da Laurens van der Maaten e Geoffrey Hinton nel 2008) formalizza questa idea in modo probabilistico. Nello spazio originale, per ogni punto calcola la probabilità che ogni altro punto sia un suo «vicino», con una gaussiana centrata su di lui: i punti vicinissimi hanno probabilità alta, quelli lontani quasi zero. Poi dispone i punti su un piano, all’inizio a caso, e calcola le stesse probabilità nella mappa. Infine sposta i punti, iterazione dopo iterazione, per far somigliare le due distribuzioni il più possibile — minimizzando la divergenza KL tra loro.
L’analogia più fedele è una festa in cui ognuno riceve la lista dei propri amici: a ogni giro di musica, ciascuno fa un passo verso i propri amici e un passo via da tutti gli altri. Dopo abbastanza giri, i gruppi di amici si ritrovano fisicamente vicini, anche se nessuno ha mai visto la pianta della sala. La «t» del nome è un dettaglio tecnico con conseguenze enormi: nella mappa 2D le probabilità usano una distribuzione t di Student, con code più pesanti della gaussiana, che permette ai punti non-vicini di stare comodamente lontani. Senza questo trucco, i punti si accalcherebbero tutti al centro — il cosiddetto crowding problem — perché in due dimensioni c’è molto meno «spazio» che in 784.
UMAP: stessa filosofia, fondamenta diverse
UMAP (Uniform Manifold Approximation and Projection, di Leland McInnes, John Healy e James Melville, 2018) parte dalla stessa intuizione — preservare i vicinati — ma la fonda sulla teoria delle varietà: assume che i dati giacciano su una superficie curva a bassa dimensione, ne costruisce una rappresentazione a grafo pesato (ogni punto connesso ai suoi k vicini più prossimi) e poi cerca la disposizione 2D il cui grafo somiglia di più a quello originale.
In pratica, per chi lo usa, le differenze rilevanti sono tre. UMAP è sensibilmente più veloce, e scala a milioni di punti dove t-SNE arranca. UMAP preserva un po’ meglio la struttura globale: le distanze tra cluster hanno più significato che in t-SNE, dove sono quasi arbitrarie. E UMAP può proiettare punti nuovi su una mappa già costruita, mentre il t-SNE classico va rieseguito da capo — il che rende UMAP utilizzabile anche come passo di preprocessing in una pipeline, non solo come strumento di visualizzazione.
A sinistra, i dati originali: classi intrecciate su superfici curve in centinaia di dimensioni. A destra, la mappa: i vicinati sopravvivono e diventano isole, ma le distanze tra le isole non sono più affidabili.
Come mentono le mappe
Una mappa di t-SNE va letta come una metropolitana: le fermate sulla stessa linea sono davvero collegate, ma le distanze sul foglio non sono le distanze della città.
Ed eccoci al punto che distingue chi usa questi strumenti da chi ne viene usato. Per rendere leggibili i vicinati, t-SNE e UMAP sacrificano deliberatamente altre proprietà, e le mappe risultanti mentono in modi noti e documentati.
- Le dimensioni dei cluster non significano nulla. t-SNE tende a espandere i cluster densi e comprimere quelli radi: un’isola grande sulla mappa non è un gruppo più numeroso o più vario nei dati.
- Le distanze tra cluster sono poco affidabili. Due isole lontane sulla mappa non sono necessariamente più diverse di due isole vicine, specie in t-SNE. UMAP fa meglio, ma non abbastanza da trarne conclusioni quantitative.
- I cluster possono essere un artefatto. Con certi valori di perplexity, t-SNE trova «cluster» anche in rumore uniforme. Se un raggruppamento appare solo per una configurazione di iperparametri e svanisce per le altre, non era nei dati: era nell’algoritmo.
- Il risultato dipende dal caso. L’inizializzazione è casuale: due esecuzioni possono dare mappe diverse, ruotate o con isole disposte altrove. Solo la composizione dei vicinati è stabile.
Il parametro chiave si chiama perplexity in t-SNE (tipicamente tra 5 e 50) e n_neighbors in UMAP: regola quanti vicini «contano» per ogni punto, cioè la scala della lente. Valori bassi rivelano microstruttura e frammentano; valori alti fondono i dettagli in poche masse. La pratica onesta è provare più valori e fidarsi solo di ciò che sopravvive a tutti.
Quando usarli, quando no
Usateli per l’esplorazione: capire se un dataset etichettato ha classi separabili, ispezionare visivamente gli embedding di un modello, scoprire sottopopolazioni inattese — il caso d’uso principe è la biologia computazionale, dove le mappe UMAP di migliaia di cellule sequenziate una a una sono diventate lo standard per identificare tipi cellulari. Non usateli come misura: mai calcolare distanze, aree o densità sulla mappa e trattarle come proprietà dei dati; per ridurre le dimensioni prima di un altro modello, la PCA resta spesso la scelta più sana perché la sua distorsione è lineare, nota e quantificata. E su dataset molto grandi, un trucco consolidato: prima PCA a ~50 dimensioni per togliere rumore e costo computazionale, poi t-SNE o UMAP per gli ultimi due passi verso il piano.
Perché vi riguarda
Anche se non farete mai ricerca in biologia, incontrerete queste mappe: negli articoli scientifici, nelle demo dei modelli, nelle dashboard dei vendor che mostrano quanto bene «il loro modello separa i dati». Sapere che le dimensioni delle isole sono arbitrarie, che le distanze tra loro sono quasi rumore e che i cluster vanno verificati a più scale vi mette nella posizione giusta: quella di chi legge la mappa sapendo che è una mappa. È la stessa competenza che serve davanti a qualsiasi visualizzazione di dati ad alta dimensione — e nell’era degli embedding, in cui ogni testo, immagine e utente diventa un punto in mille dimensioni, è una competenza che serve ogni settimana.
I paper originali
t-SNE è descritto in «Visualizing Data using t-SNE» di Laurens van der Maaten e Geoffrey Hinton, pubblicato sul Journal of Machine Learning Research nel 2008 (jmlr.org/papers/v9/vandermaaten08a.html). UMAP è presentato in «UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction» di Leland McInnes, John Healy e James Melville, 2018 (arXiv:1802.03426). Per la lettura critica delle mappe, il riferimento è l’articolo interattivo «How to Use t-SNE Effectively» di Wattenberg, Viégas e Johnson su Distill (2016), da cui viene l’osservazione sui cluster nel rumore.
I commenti sono riservati agli iscritti.
Accedi per commentare