Il dataset sul tumore al seno del Wisconsin, un classico dei corsi di machine learning, ha 30 colonne per ogni paziente: raggio medio delle cellule, perimetro, area, compattezza, e così via. Provate a farne un grafico. Non si può: nessuno sa disegnare in 30 dimensioni. Eppure molte di quelle colonne raccontano la stessa storia — il raggio, il perimetro e l’area di una cellula crescono insieme, per ovvie ragioni geometriche. L’informazione vera occupa molte meno dimensioni di quelle in cui è scritta. La Principal Component Analysis, PCA, serve esattamente a questo: trovare le poche direzioni lungo cui i dati variano davvero, e buttare via il resto con perdita minima e misurabile.
La maledizione della dimensionalità, la PCA, t-SNE e UMAP, e i metodi di raggruppamento: tutto nel libro.
Leggi «Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato» nel libro →
L’idea: ruotare gli assi, non tagliare le colonne
L’istinto ingenuo per ridurre 30 colonne a 2 sarebbe sceglierne due e cancellare le altre. Ma è come riassumere un libro tenendo due capitoli a caso: si perde tutto quello che stava altrove. La PCA fa una cosa più furba: costruisce nuove colonne, ognuna combinazione pesata di tutte le originali, ordinate per quanta variabilità dei dati catturano. La prima componente principale è la direzione lungo cui i punti si sparpagliano di più; la seconda è la direzione più sparpagliata tra quelle perpendicolari alla prima; e così via.
Un’analogia concreta: fotografare una baguette. La baguette è un oggetto tridimensionale, ma quasi tutta la sua «forma» vive lungo un asse solo, la lunghezza. Se la fotografate di lato — cioè scegliete bene l’angolo — una foto 2D racconta quasi tutto; se la fotografate di punta, vedete un cerchietto e avete perso l’essenziale. La PCA calcola matematicamente l’angolo di ripresa migliore: quello che conserva la massima varianza.
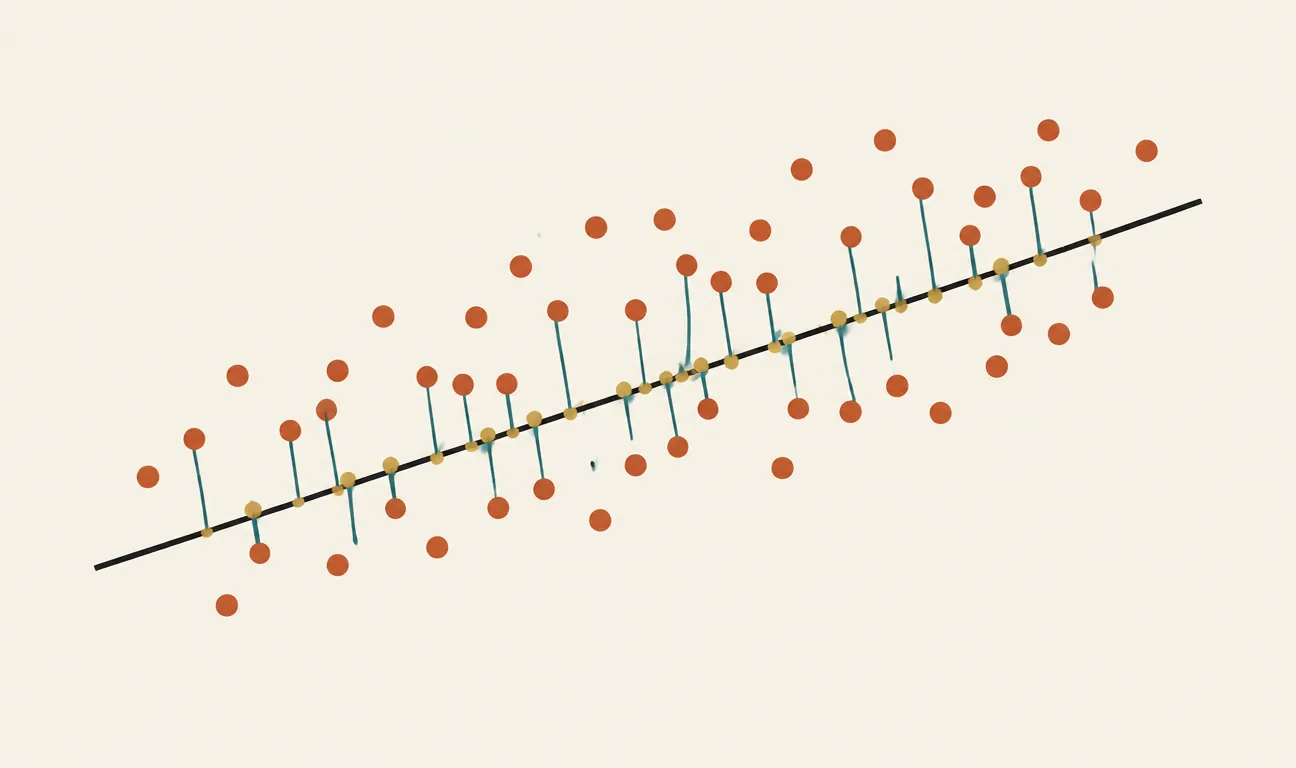
La nuvola di punti è allungata in diagonale: nessuno dei due assi originali la descrive bene da solo. PC1 segue la direzione di massimo sparpagliamento, PC2 raccoglie la (poca) varianza perpendicolare rimasta.
La matematica in tre righe
Il cuore della PCA è la matrice di covarianza: una tabella che dice, per ogni coppia di feature, quanto tendono a muoversi insieme. Le direzioni principali sono gli autovettori di questa matrice, e la varianza catturata da ciascuna è il corrispondente autovalore (se autovalori e autovettori vi suonano nuovi, ne abbiamo parlato nell’articolo dedicato di questa serie). La ricetta completa:
- centra i dati sottraendo la media di ogni colonna;
- calcola la matrice di covarianza;
- estrai autovettori e autovalori, ordina per autovalore decrescente;
- proietta i dati sui primi
kautovettori.
Costruiamola da zero con NumPy
Niente scikit-learn per ora: venti righe di NumPy bastano, e costringono a capire ogni passaggio. Generiamo dati 2D correlati, dove la struttura è visibile a occhio, così possiamo verificare che la PCA trovi quello che sappiamo esserci.
import numpy as np

rng = np.random.default_rng(42)

# Dati 2D correlati: x2 dipende fortemente da x1
n = 300
x1 = rng.normal(0, 2.0, n)
x2 = 0.8 * x1 + rng.normal(0, 0.6, n)
X = np.column_stack([x1, x2])

# 1. Centrare i dati
X_centered = X - X.mean(axis=0)

# 2. Matrice di covarianza (feature x feature)
C = np.cov(X_centered, rowvar=False)

# 3. Autovalori e autovettori (eigh: C è simmetrica)
eigvals, eigvecs = np.linalg.eigh(C)

# eigh li restituisce in ordine crescente: invertiamo
order = np.argsort(eigvals)[::-1]
eigvals = eigvals[order]
eigvecs = eigvecs[:, order]

print("Varianza spiegata:", eigvals / eigvals.sum())
# ~ [0.96, 0.04]: la prima direzione cattura il 96%
Il risultato dice che una sola direzione spiega circa il 96% della varianza: coerente con come abbiamo costruito i dati, dove x2 è quasi una copia riscalata di x1. La proiezione è un semplice prodotto matriciale:
# 4. Proiettare sui primi k autovettori
k = 1
X_ridotto = X_centered @ eigvecs[:, :k]   # da (300, 2) a (300, 1)

# Ricostruzione approssimata e errore
X_ricostruito = X_ridotto @ eigvecs[:, :k].T + X.mean(axis=0)
errore = np.mean((X - X_ricostruito) ** 2)
print(f"Errore quadratico medio di ricostruzione: {errore:.4f}")
Abbiamo dimezzato le dimensioni e possiamo dire con precisione quanto abbiamo perso. È questa la differenza tra la PCA e un taglio arbitrario di colonne: la perdita non è un atto di fede, è un numero.
Sul dataset vero: da 30 dimensioni a 2
Ora il caso realistico, con scikit-learn e il dataset del Wisconsin citato in apertura. Un dettaglio non negoziabile: standardizzare prima. La PCA massimizza la varianza, e la varianza dipende dalle unità di misura. Se una colonna è in millimetri e un’altra in metri, la prima dominerà solo perché ha numeri più grandi — come giudicare l’importanza delle persone in una stanza da chi parla a voce più alta.
from sklearn.datasets import load_breast_cancer
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

data = load_breast_cancer()
X, y = data.data, data.target        # (569, 30)

X_std = StandardScaler().fit_transform(X)

pca = PCA(n_components=2)
X_2d = pca.fit_transform(X_std)      # (569, 2)

print("Varianza spiegata:", pca.explained_variance_ratio_)
print("Totale con 2 componenti:",
      pca.explained_variance_ratio_.sum().round(3))
Con due sole componenti si conserva tipicamente oltre il 60% della varianza di 30 colonne — e se le disegnate colorando i punti per diagnosi, le due classi si separano già a occhio nudo, senza aver mai mostrato le etichette alla PCA. Per scegliere quante componenti tenere in un progetto reale, la pratica standard è guardare la varianza cumulata:
import numpy as np

pca_full = PCA().fit(X_std)
cumulata = np.cumsum(pca_full.explained_variance_ratio_)
n_95 = np.argmax(cumulata >= 0.95) + 1
print(f"Componenti per il 95% della varianza: {n_95}")
# tipicamente ~10 su 30: un terzo delle dimensioni
Il «quasi» nel titolo: cosa si perde davvero
La PCA non sa cosa vi interessa: sa solo dove i dati si sparpagliano di più. Le due cose spesso coincidono, ma non sempre.
Onestà intellettuale su tre limiti. Primo: la varianza non è sinonimo di informazione utile. Se il segnale che vi serve per classificare vive in una direzione a bassa varianza, la PCA lo butterà via con entusiasmo. Secondo: la PCA vede solo strutture lineari; se i dati vivono su una superficie curva — un rotolo, una spirale — la proiezione lineare li schiaccia male (per questi casi esistono t-SNE e UMAP, protagonisti del prossimo articolo). Terzo: le componenti principali sono combinazioni di tutte le feature originali, quindi difficili da spiegare a un collega o a un regolatore: «la componente 1 è 0,21 volte il raggio più 0,19 volte il perimetro meno…» non è una spiegazione, è una lista.
Perché vi riguarda
La PCA è ovunque, spesso invisibile: comprime le feature prima di un modello per accelerare l’addestramento, elimina colonne ridondanti che gonfiano la varianza delle stime, produce le visualizzazioni 2D con cui si «guarda» un dataset per la prima volta, e riduce il rumore nei dati di sensori e immagini. Ma il motivo più profondo per conoscerla è concettuale: è il primo incontro con un’idea che attraversa tutto il machine learning moderno, dalla compressione degli embedding ai layer di proiezione dei transformer — i dati ad alta dimensione hanno quasi sempre una struttura a bassa dimensione nascosta dentro, e trovarla vale più che accumulare colonne. La prossima volta che un dataset vi sembra ingestibile, la domanda giusta non è «quale colonna elimino?» ma «in quante dimensioni vive davvero questa cosa?». La PCA è il modo più semplice e onesto di rispondere: con un numero.
I commenti sono riservati agli iscritti.
Accedi per commentare