
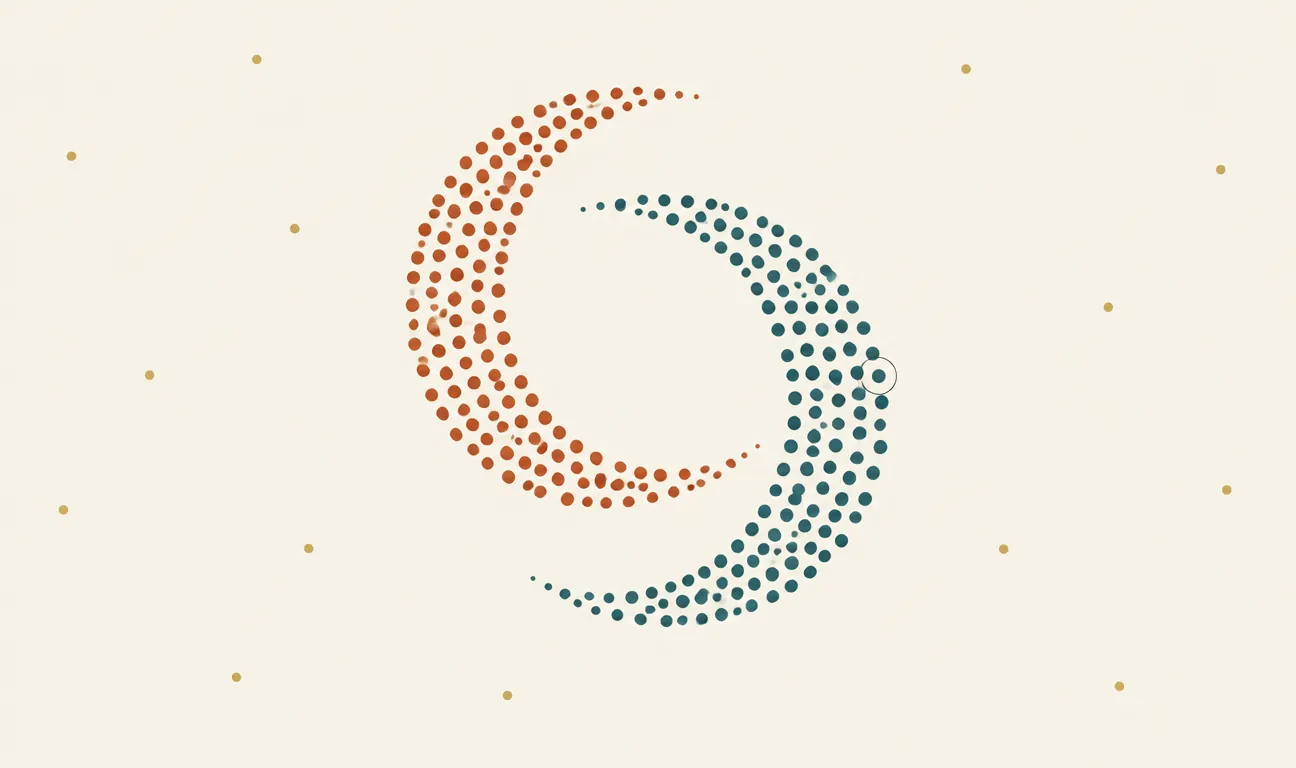
Prendete due mezzalune di punti intrecciate — il dataset «two moons» che ogni corso di machine learning prima o poi tira fuori — e dategli in pasto K-means con k=2. Il risultato è sbagliato in modo quasi comico: l’algoritmo taglia le due lune a metà con una linea retta, mescolando i gruppi. Non è un bug, è la conseguenza diretta di un’assunzione: per K-means un cluster è una sfera attorno a un centroide. Quando i dati hanno un’altra forma, serve un’altra idea di cosa sia un cluster. Ne esistono almeno due, ed è il tema di questo deep-dive.
La maledizione della dimensionalità, la PCA, t-SNE e UMAP, e i metodi di raggruppamento: tutto nel libro.
Leggi «Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato» nel libro →
Cluster come zone dense: DBSCAN
DBSCAN — Density-Based Spatial Clustering of Applications with Noise, proposto da Martin Ester, Hans-Peter Kriegel, Jörg Sander e Xiaowei Xu nel 1996 — parte da un’intuizione diversa: un cluster non è una sfera attorno a un centro, è una zona densa di punti, di qualunque forma, separata da zone vuote.
Pensate a una fotografia notturna dell’Italia dal satellite: le città sono grumi di luce di forme irregolari — Milano compatta, la costa ligure allungata e sottile — separate da campagna buia. Nessuno ha bisogno di sapere in anticipo quante città ci sono, né di assumere che siano rotonde: bastano la densità delle luci e il buio intorno. DBSCAN formalizza esattamente questo.
L’algoritmo usa due parametri: eps, il raggio entro cui due punti si considerano vicini, e min_samples, il numero minimo di vicini perché una zona sia «densa». Da qui, ogni punto riceve uno di tre ruoli:
- Punto core: ha almeno
min_samplesvicini entroeps. È il cuore di una zona densa. - Punto border: non è core, ma è nel raggio di un core. Sta sul bordo del cluster.
- Rumore: né core né border. Non appartiene a nessun cluster, punto.
I cluster nascono per contagio: si parte da un punto core, si annettono i suoi vicini, e se tra questi ci sono altri core si continua ad espandersi, come una macchia d’inchiostro che si allarga finché trova carta assorbente. Quando l’espansione si ferma, il cluster è completo e si riparte da un altro core non ancora visitato.
Le conseguenze pratiche sono tre, e sono esattamente i punti dove K-means soffriva. Primo: il numero di cluster non si dichiara, emerge dai dati. Secondo: i cluster possono avere qualsiasi forma, perché l’espansione segue la densità e non la distanza da un centro. Terzo: esiste il concetto di rumore — l’outlier isolato resta fuori invece di inquinare il gruppo più vicino. Non a caso DBSCAN è usato anche come rilevatore di anomalie, oltre che come algoritmo di clustering.
Il prezzo da pagare: eps
Niente è gratis. Il tallone d’Achille di DBSCAN è la scelta di eps: troppo piccolo e tutto diventa rumore, troppo grande e cluster distinti si fondono in uno solo. Peggio: eps è unico per tutto il dataset, quindi se i vostri dati contengono un cluster molto denso e uno molto rado, nessun valore andrà bene per entrambi. È il limite della densità globale.
Un’euristica diffusa per orientarsi è il grafico delle k-distanze: si ordina, per ogni punto, la distanza dal suo k-esimo vicino più prossimo e si cerca il «ginocchio» della curva. Per il problema delle densità variabili esistono eredi più sofisticati — OPTICS e HDBSCAN, che di fatto esplorano molti valori di densità in una sola passata — ma l’idea di fondo resta quella del 1996.
Cluster come genealogia: il clustering gerarchico
La seconda alternativa a K-means cambia di nuovo la domanda. Invece di «quali sono i k gruppi?» chiede: «come si aggregano i dati a tutte le scale?». Il clustering gerarchico agglomerativo parte con ogni punto nel proprio cluster individuale e a ogni passo fonde i due cluster più vicini, fino a quando tutto è un cluster unico. La storia completa di queste fusioni è un albero: il dendrogramma.
L’analogia giusta è un albero genealogico letto al contrario: partite dai singoli individui, risalite alle famiglie, poi ai ceppi, poi alle popolazioni. Nessun livello è «quello giusto» in assoluto: dipende dalla domanda. Il dendrogramma vi dà tutti i livelli insieme, e tagliarlo a un’altezza scelta equivale a decidere la granularità: un taglio alto produce pochi cluster grandi, un taglio basso molti cluster piccoli.
Due modi di vedere un cluster: per DBSCAN è una zona densa di forma libera con rumore esplicito; per il gerarchico è un ramo del dendrogramma, e il taglio decide la granularità.
Il linkage: come si misura la distanza tra gruppi
C’è un dettaglio che cambia tutto: quando due cluster contengono molti punti, cosa vuol dire che sono «vicini»? La risposta si chiama linkage, e le scelte principali danno alberi molto diversi:
- Single linkage: distanza tra i due punti più vicini dei due gruppi. Segue bene forme allungate, ma soffre di «concatenamento»: basta un ponte di punti sparsi per fondere due cluster che a occhio sono separati.
- Complete linkage: distanza tra i due punti più lontani. Produce cluster compatti e rotondeggianti, ed è sensibile agli outlier.
- Average linkage: media di tutte le distanze tra coppie. Un compromesso ragionevole.
- Ward: fonde la coppia che fa crescere meno la varianza interna. È il default più comune, e non a caso: dei quattro è quello con lo spirito più simile a K-means.
La scelta del linkage è una dichiarazione implicita su che forma vi aspettate dai cluster — lo stesso tipo di assunzione che K-means faceva di nascosto, qui almeno resa esplicita e negoziabile.
Nessun algoritmo di clustering scopre i gruppi «veri». Ognuno porta con sé una definizione di cluster, e restituisce i gruppi coerenti con quella definizione.
Quale usare, in pratica
Una bussola sintetica, tenendo conto che i confini sono sfumati:
- K-means quando i gruppi sono plausibilmente compatti e di taglia simile, il dataset è grande e la velocità conta. Complessità pressoché lineare nel numero di punti: su milioni di righe è spesso l’unica opzione comoda.
- DBSCAN quando le forme sono irregolari, non sapete quanti gruppi cercare, o il rumore è parte del problema (frodi, anomalie, dati geospaziali). Richiede però di ragionare su
eps, e fatica con densità molto variabili — caso in cui conviene guardare HDBSCAN. - Gerarchico quando la struttura annidata è essa stessa la risposta: tassonomie di prodotti, gruppi di geni, organizzazione di documenti. Il dendrogramma è anche un ottimo strumento esplorativo per scegliere il numero di cluster prima di passare a un metodo più scalabile. Il costo però cresce almeno col quadrato dei punti: oltre qualche decina di migliaia diventa proibitivo.
In scikit-learn i tre vivono fianco a fianco — KMeans, DBSCAN, AgglomerativeClustering — con la stessa interfaccia fit_predict. Cambiare idea costa una riga, ed è un ottimo motivo per provare sempre più di un algoritmo sugli stessi dati: se due definizioni diverse di cluster concordano, la struttura trovata è probabilmente reale e non un artefatto del metodo.
Perché vi riguarda
La lezione di questo confronto va oltre il clustering. Ogni algoritmo non supervisionato incorpora una teoria implicita su come sono fatti i dati: sfere attorno a centri, zone dense nel vuoto, gerarchie annidate. Quando i risultati sembrano assurdi, il primo sospettato non è il dato ma l’assunzione. È una forma mentale che serve anche molto lontano da qui: gli embedding testuali che alimentano i motori di ricerca semantica e i sistemi RAG vengono regolarmente raggruppati con questi stessi algoritmi per scoprire temi, deduplicare documenti, organizzare basi di conoscenza. Capire quale definizione di «gruppo» state comprando insieme all’algoritmo è la differenza tra un’analisi esplorativa solida e una collezione di grafici colorati che confermano quello che volevate vedere.
I commenti sono riservati agli iscritti.
Accedi per commentare