Avete davanti diecimila clienti di un e-commerce e nessuna etichetta: nessuno vi ha detto chi è lo studente che compra una volta l’anno e chi il professionista che ordina ogni settimana. Eppure i gruppi esistono, nascosti nei dati. K-means è l’algoritmo che li fa emergere, ed è probabilmente il primo strumento di apprendimento non supervisionato che qualunque data scientist impara a usare. Ha più di sessant’anni, sta in venti righe di Python, e continua a girare in produzione ovunque.
La maledizione della dimensionalità, la PCA, t-SNE e UMAP, e i metodi di raggruppamento: tutto nel libro.
Leggi «Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato» nel libro →
Il problema: imparare senza maestro
Fin qui, in questa serie, abbiamo visto modelli supervisionati: c’era sempre una colonna «risposta giusta» — spam o non spam, prezzo della casa — e il modello imparava a predirla. Il clustering rovescia il tavolo: non ci sono risposte giuste. C’è solo una nuvola di punti e una domanda: quali punti si assomigliano abbastanza da formare un gruppo?
L’analogia più concreta è la festa in cui non conoscete nessuno. Nessuno vi ha assegnato un tavolo, ma dopo mezz’ora la sala si è auto-organizzata: i colleghi di lavoro in un angolo, i parenti vicino al buffet, gli amici dello sport sul balcone. Nessuna etichetta, solo affinità. K-means fa esattamente questo con i dati, usando la distanza geometrica come misura di affinità.
Come funziona: centroidi che migrano
K-means richiede una sola decisione iniziale: quanti gruppi cercare, il famoso k. Poi alterna due passi, sempre gli stessi, fino a convergenza:
- Assegnazione: ogni punto viene assegnato al centroide (il «baricentro» di un cluster) più vicino.
- Aggiornamento: ogni centroide si sposta nella media dei punti che gli sono stati assegnati.
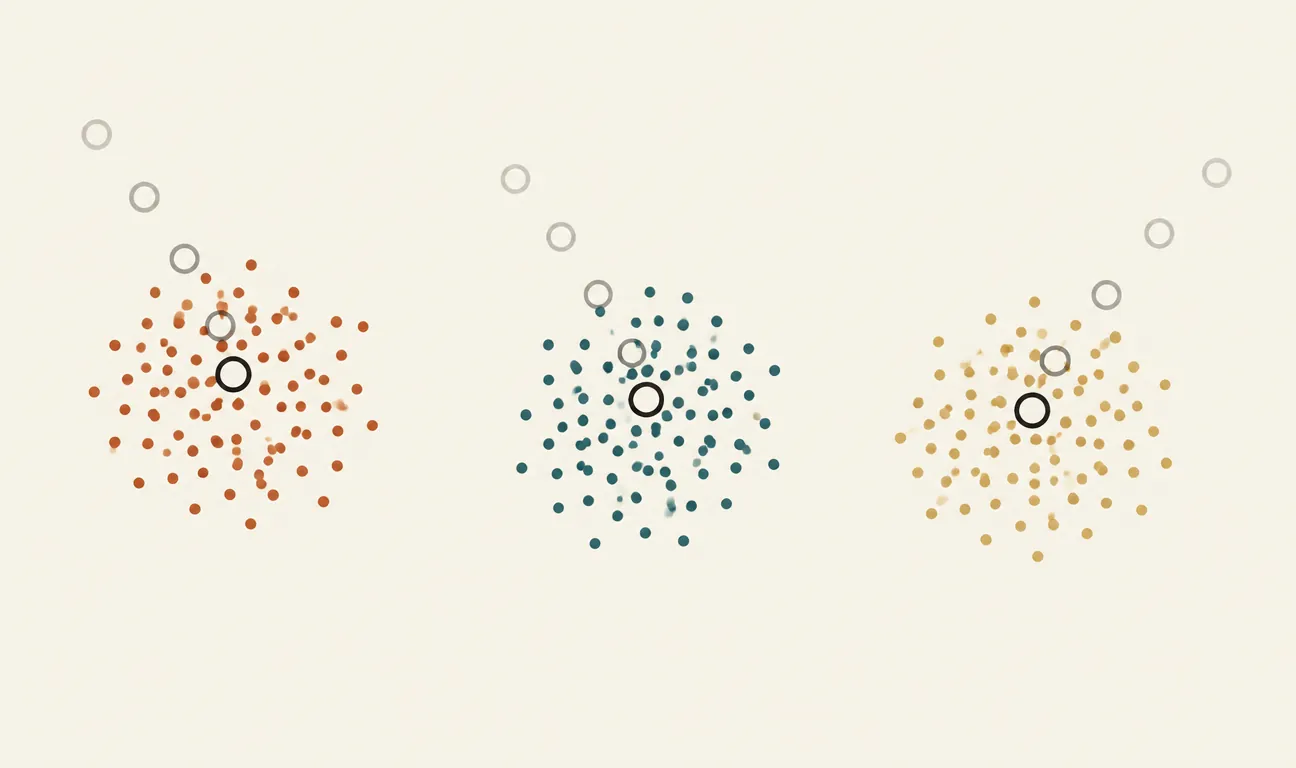
All’inizio i centroidi sono messi a caso, quindi le prime assegnazioni sono quasi arbitrarie. Ma a ogni iterazione i centroidi migrano verso le zone dense della nuvola, come tende piantate a caso in un campeggio che vengono spostate, notte dopo notte, sempre più vicino a dove la gente si raduna davvero. Dopo poche iterazioni nessun punto cambia più gruppo, i centroidi smettono di muoversi, e l’algoritmo si ferma.
La migrazione dei centroidi: partono da posizioni casuali, si spostano verso le zone dense a ogni iterazione, e si fermano quando nessun punto cambia più cluster.
Implementiamolo da zero
Prima di usare scikit-learn, scriviamo K-means a mano: sono davvero poche righe, e vederle aiuta a fissare l’idea.
import numpy as np

def kmeans(X, k, n_iter=100, seed=42):
    rng = np.random.default_rng(seed)
    # 1. centroidi iniziali: k punti scelti a caso dal dataset
    centroidi = X[rng.choice(len(X), size=k, replace=False)]

    for _ in range(n_iter):
        # 2. assegnazione: ogni punto al centroide piu' vicino
        distanze = np.linalg.norm(X[:, None] - centroidi[None, :], axis=2)
        etichette = distanze.argmin(axis=1)

        # 3. aggiornamento: ogni centroide = media dei suoi punti
        nuovi = np.array([X[etichette == j].mean(axis=0) for j in range(k)])

        # 4. convergenza: i centroidi non si muovono piu'
        if np.allclose(nuovi, centroidi):
            break
        centroidi = nuovi

    return etichette, centroidi
Proviamolo su dati sintetici con tre gruppi veri, per verificare che li ritrovi:
from sklearn.datasets import make_blobs

X, y_vero = make_blobs(n_samples=300, centers=3,
                       cluster_std=0.8, random_state=7)

etichette, centroidi = kmeans(X, k=3)
print("Centroidi trovati:\n", centroidi.round(2))
Il punto delicato è la riga delle distanze: X[:, None] - centroidi[None, :] usa il broadcasting di NumPy per calcolare in un colpo solo la distanza di ogni punto da ogni centroide, senza cicli espliciti. È lo stesso trucco che rende veloci quasi tutte le implementazioni numeriche in Python.
La versione da produzione: scikit-learn
Nella pratica si usa sklearn.cluster.KMeans, che aggiunge due migliorie importanti: l’inizializzazione k-means++ (i centroidi iniziali vengono scelti lontani tra loro, riducendo il rischio di partenze sfortunate) e il parametro n_init, che ripete l’intero algoritmo più volte e tiene il risultato migliore.
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

# Le feature vanno sempre standardizzate prima:
# K-means usa distanze, e una feature con scala grande domina le altre
X_std = StandardScaler().fit_transform(X)

km = KMeans(n_clusters=3, init="k-means++", n_init=10, random_state=7)
etichette = km.fit_predict(X_std)

print("Inerzia:", round(km.inertia_, 2))
print("Iterazioni per convergere:", km.n_iter_)
La standardizzazione non è un dettaglio. Se una colonna è il reddito in euro (decine di migliaia) e un’altra è l’età (decine), la distanza euclidea sarà dominata dal reddito e l’età diventerà irrilevante. È come misurare l’affinità tra due persone contando solo quanto distano le loro case e ignorando tutto il resto.
Quanti cluster? Il metodo del gomito
K-means non sceglie k da solo: glielo dovete dire voi. Il criterio più usato è il metodo del gomito: si prova una gamma di valori di k e si osserva l’inerzia, cioè la somma delle distanze quadratiche di ogni punto dal proprio centroide.
inerzie = []
for k in range(1, 10):
    km = KMeans(n_clusters=k, n_init=10, random_state=7).fit(X_std)
    inerzie.append(km.inertia_)

for k, i in enumerate(inerzie, start=1):
    print(f"k={k}: inerzia={i:.1f}")
L’inerzia scende sempre all’aumentare di k (più centroidi, punti più vicini). Ma a un certo punto la discesa rallenta bruscamente: quel «gomito» nella curva è il valore di k oltre il quale i cluster aggiuntivi non spiegano più struttura vera, ma spezzettano gruppi genuini. Una misura complementare, spesso più leggibile, è il silhouette score di sklearn.metrics.silhouette_score: vale tra -1 e 1, e valori alti indicano cluster compatti e ben separati.
K-means non trova i gruppi «veri»: trova la migliore partizione in k gruppi sferici. Se i vostri dati hanno un’altra forma, la risposta sarà sbagliata con grande sicurezza.
Dove K-means sbaglia
Conviene essere onesti sui limiti, perché sono strutturali e non si aggirano con più dati:
- Assume cluster sferici e di taglia simile. Due gruppi a forma di mezzaluna intrecciata verranno tagliati a metà, perché l’unico criterio è la distanza dal centroide.
- Ogni punto finisce in un cluster, sempre. Non esiste il concetto di rumore o di outlier: anche il punto anomalo isolato viene arruolato nel gruppo più vicino, spostandone il centroide.
- Il risultato dipende dall’inizializzazione.
k-means++en_initmitigano il problema, ma la garanzia è solo di trovare un minimo locale, non quello globale. - Dovete scegliere k a priori. Nei casi reali i gruppi «giusti» spesso non si sanno, e il gomito è un’indicazione, non un oracolo.
Per dati con forme irregolari, densità diverse o rumore, esistono alternative pensate apposta — DBSCAN e il clustering gerarchico, che vedremo nel prossimo articolo di questa serie.
Perché vi riguarda
Il clustering è il coltellino svizzero dell’analisi esplorativa: segmentare clienti per una campagna, raggruppare articoli simili, comprimere una palette di colori, individuare pattern in log di sistema. In tutti questi casi non avete etichette, e K-means è quasi sempre il primo tentativo giusto: veloce, comprensibile, con due soli iperparametri. Sapere anche dove fallisce — forme non sferiche, outlier, k sbagliato — è ciò che distingue chi usa l’algoritmo da chi lo subisce. E c’è un motivo in più per capirlo bene: la stessa idea di «assegna al più vicino, poi aggiorna il centro» riappare, sotto altri nomi, nella quantizzazione dei modelli e nella costruzione degli indici vettoriali che fanno funzionare i sistemi RAG. Sessant’anni dopo, K-means è ancora dappertutto.
I commenti sono riservati agli iscritti.
Accedi per commentare