
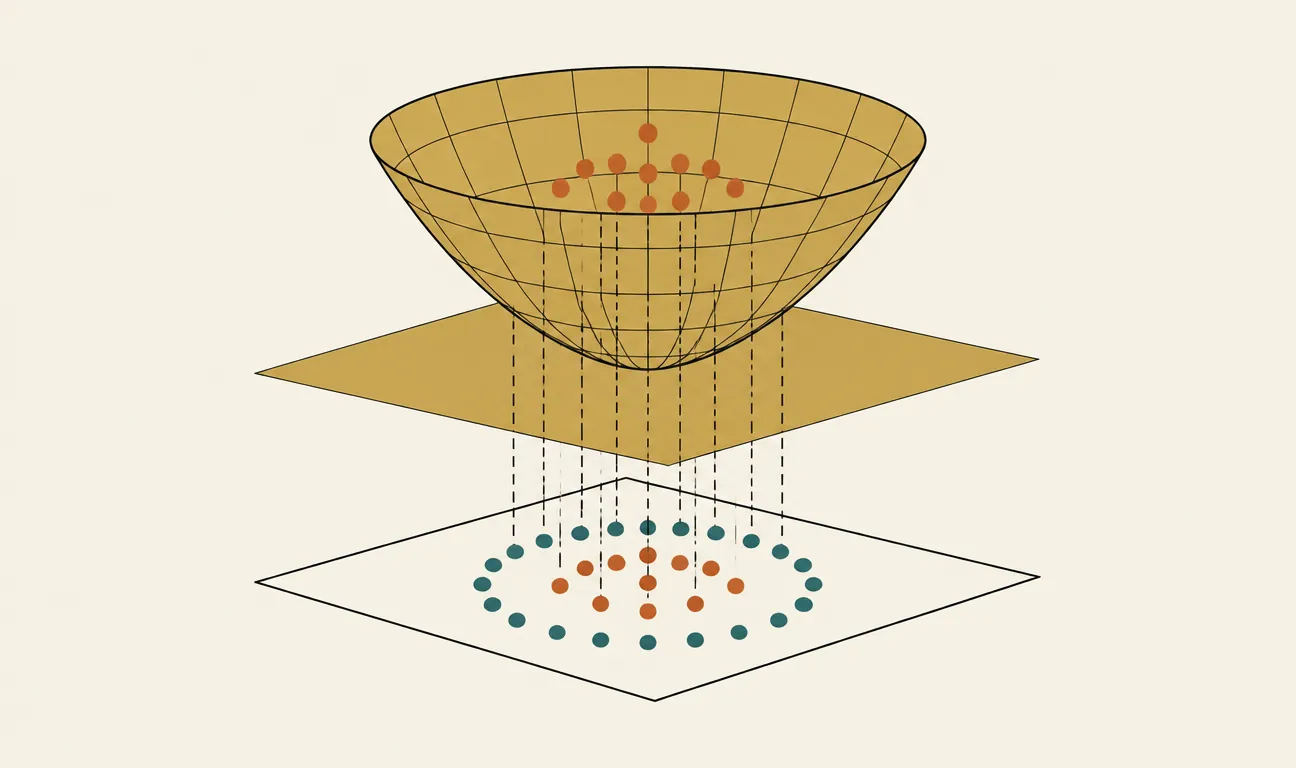
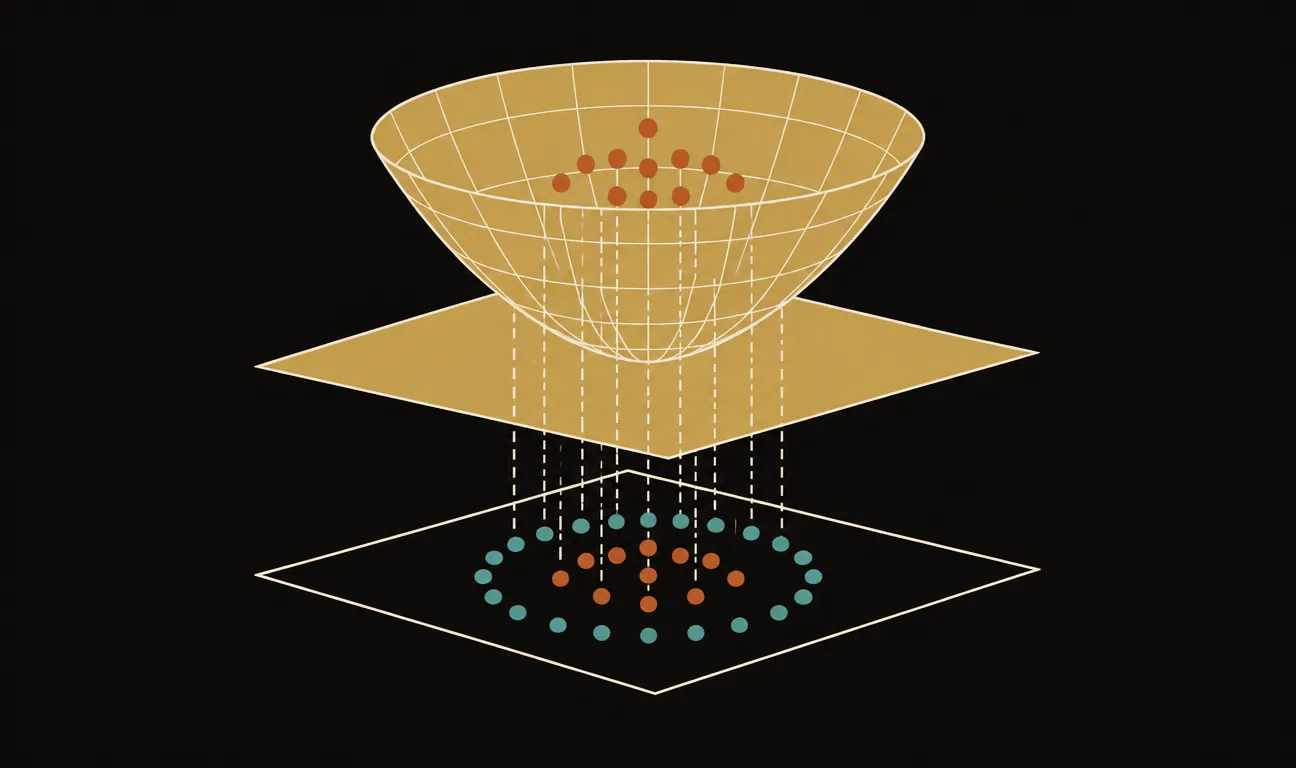
Immaginate dei coriandoli rossi e blu sparsi su un tavolo: i rossi formano un cerchio al centro, i blu un anello tutt’attorno. Provate a separarli con un righello. Impossibile: qualunque linea retta tracciate, taglia il cerchio e lascia rossi da entrambe le parti. Ora date un pugno al centro del tavolo, come se fosse un telo elastico: i coriandoli centrali si sollevano, quelli esterni restano in basso. All’improvviso un semplice piano orizzontale — un foglio di cartone infilato a mezz’altezza — li separa perfettamente. Non avete cambiato i dati: avete cambiato lo spazio in cui li guardate. Questa è l’idea al cuore delle support vector machine e del kernel trick, uno degli algoritmi più eleganti del machine learning classico.
Il margine massimo, il kernel trick e le SVM per regressione e anomaly detection sono trattati nel libro.
Leggi «Il kernel trick: separare l’inseparabile» nel libro →
Prima mossa: il margine più largo possibile
Partiamo dal caso facile, quando i dati sono separabili con una retta (o un iperpiano, in più dimensioni). Di rette separatrici ce ne sono infinite: quale scegliere? La risposta delle SVM, formulata da Vladimir Vapnik e colleghi, è: quella che passa più lontano possibile dai punti di entrambe le classi. La striscia vuota attorno alla retta si chiama margine, e la SVM cerca l’iperpiano che lo massimizza.
L’intuizione è la stessa di chi traccia un sentiero tra due campi minati: non basta un percorso che non tocca nessuna mina, si vuole quello che resta il più distante possibile da tutte. Un margine largo è una polizza contro il rumore: i punti futuri, che cadranno vicino ma non esattamente sopra quelli visti in addestramento, avranno più spazio per non finire dal lato sbagliato.
I pochi punti che toccano il bordo del margine si chiamano vettori di supporto, e danno il nome al metodo: sono gli unici che contano. Potete cancellare tutti gli altri punti dal dataset e la soluzione non cambia di un millimetro. È una proprietà notevole: il modello è definito da una manciata di esempi «di frontiera», non dalla massa.
Quando la retta non basta
Il mondo reale raramente è così gentile. I coriandoli dell’apertura — un cerchio dentro un anello — sono il controesempio classico: nessuna retta, comunque orientata, li separa. La tentazione ingenua sarebbe abbandonare le rette e cercare direttamente curve complicate. Le SVM fanno una cosa più furba: tengono le rette, ma cambiano lo spazio.
L’idea è aggiungere coordinate calcolate. Se ogni punto ha coordinate (x, y), aggiungiamo una terza coordinata: la distanza dal centro al quadrato, cioè x² + y². I coriandoli rossi, vicini al centro, avranno questa terza coordinata piccola; i blu, sull’anello esterno, l’avranno grande. Nel nuovo spazio tridimensionale le due classi vivono ad altezze diverse — esattamente il tavolo elastico dopo il pugno — e un piano orizzontale le separa in modo pulito. Riportato nel piano originale, quel piano diventa un cerchio: abbiamo ottenuto un confine curvo usando un separatore lineare.
Il kernel trick in immagine: nel piano originale (a sinistra) cerchio e anello non si separano con una retta. La proiezione φ aggiunge la coordinata x²+y²: i punti centrali si sollevano e un piano lineare (a destra, in ocra) li divide. Il confine, riportato in 2D, è un cerchio.
Il trucco vero: proiettare senza proiettare
Aggiungere coordinate a mano funziona per esempi giocattolo, ma esplode in fretta: per catturare interazioni complesse servirebbero migliaia, milioni di coordinate derivate — in certi casi infinite. Calcolarle e memorizzarle sarebbe impraticabile. Qui entra il trucco che dà il titolo all’articolo.
Riscrivendo il problema di ottimizzazione della SVM nella sua forma duale, si scopre che i dati non compaiono mai da soli: compaiono solo dentro prodotti scalari tra coppie di punti. All’algoritmo non serve sapere dove si trova ciascun punto nel nuovo spazio: gli basta sapere quanto ogni coppia di punti è «simile» lì dentro. E per molte proiezioni interessanti questa similarità si può calcolare direttamente dalle coordinate originali, con una formuletta chiusa chiamata kernel.
Il kernel gaussiano (RBF), ad esempio, vale exp(-γ·||x−z||²): due numeri in ingresso, un numero in uscita, costo di calcolo irrisorio. Eppure corrisponde a un prodotto scalare in uno spazio a infinite dimensioni. È come conoscere l’affinità tra due persone senza dover compilare il questionario infinito delle loro caratteristiche: un buon sensale non misura tutto, misura direttamente la compatibilità.
Il kernel trick non calcola la proiezione: calcola solo ciò che dell’ambiente proiettato serve davvero, la somiglianza tra coppie di punti.
Margini morbidi e manopole da girare
Resta un problema: anche nello spazio proiettato, i dati reali contengono rumore ed eccezioni. Pretendere la separazione perfetta significherebbe contorcere il confine attorno a ogni outlier — overfitting da manuale. La versione pratica delle SVM usa quindi un margine morbido: alcuni punti possono violare il margine, o persino finire dal lato sbagliato, pagando una penalità.
Il bilanciamento è governato da due iperparametri che chi usa le SVM impara a rispettare:
- C regola il prezzo delle violazioni. C grande: il modello punisce severamente ogni errore di addestramento e produce confini contorti (rischio di overfitting). C piccolo: il modello tollera errori in cambio di un margine più largo e più regolare.
- γ (gamma), nel kernel gaussiano, regola la portata dell’influenza di ogni punto. Gamma grande: influenza a corto raggio, confini frastagliati che seguono i singoli esempi. Gamma piccolo: influenza a lungo raggio, confini quasi lineari.
In pratica si esplorano entrambi su scala logaritmica con la cross-validation. E un dettaglio operativo che risparmia ore di frustrazione: le SVM con kernel RBF sono sensibili alla scala delle feature, quindi standardizzare i dati prima non è un’opzione, è un prerequisito.
Che posto occupano oggi
Negli anni Novanta e Duemila le SVM sono state lo stato dell’arte su molti problemi, dalla classificazione di testi al riconoscimento di cifre scritte a mano. Oggi il deep learning le ha superate ovunque i dati siano abbondanti e strutturati — immagini, audio, linguaggio. Ma dichiararle obsolete sarebbe sbagliato due volte.
Primo, per ragioni pratiche: su dataset piccoli o medi (poche migliaia di esempi) e con feature già ben costruite, una SVM con kernel RBF resta una baseline forte, con pochi iperparametri e fondamenta teoriche solide. Il tallone d’Achille è la scalabilità: l’addestramento cresce tra il quadrato e il cubo del numero di esempi, e sopra le decine di migliaia di punti il metodo arranca.
Secondo, per ragioni concettuali: i kernel sono un linguaggio, non solo un algoritmo. La stessa idea — sostituire coordinate esplicite con una funzione di similarità — attraversa i processi gaussiani, i metodi kernel per test statistici, e riaffiora perfino nell’analisi teorica delle reti neurali (il neural tangent kernel descrive reti molto larghe proprio come macchine kernel).
Cosa portarsi a casa
Se vi occupate di machine learning, dalle SVM portate via tre idee che valgono più dell’algoritmo stesso. Che un buon classificatore non cerca solo un confine, ma il confine più prudente — il margine massimo è una forma di umiltà incorporata nel modello. Che quando un problema sembra irrisolvibile, a volte la mossa giusta non è uno strumento più potente ma uno spazio diverso in cui guardare gli stessi dati. E che si può lavorare in uno spazio enorme, perfino infinito, senza mai visitarlo, purché si sappia calcolare l’unica cosa che conta: la somiglianza tra due punti. La prossima volta che un dataset vi sembra «inseparabile», ricordatevi del pugno sul tavolo elastico: forse non servono più dati, serve una dimensione in più.
I commenti sono riservati agli iscritti.
Accedi per commentare