
RuntimeError: expected input of shape (32, 3, 224, 224). Per molti è il primo incontro ravvicinato con un tensore: un messaggio d’errore di PyTorch, quattro numeri tra parentesi, nessuna spiegazione. La parola stessa non aiuta. «Tensore» evoca la relatività generale, Einstein, lavagne piene di indici. La realtà del deep learning è molto più prosaica: un tensore è una scatola di numeri con più dimensioni. Un array multidimensionale, per chi programma. Tutto il resto — la parte davvero utile — è capire come funziona la scatola.
Che cos’è un tensore, come ci si fanno i conti su CPU e GPU, e come autograd calcola la derivata da solo: nel libro.
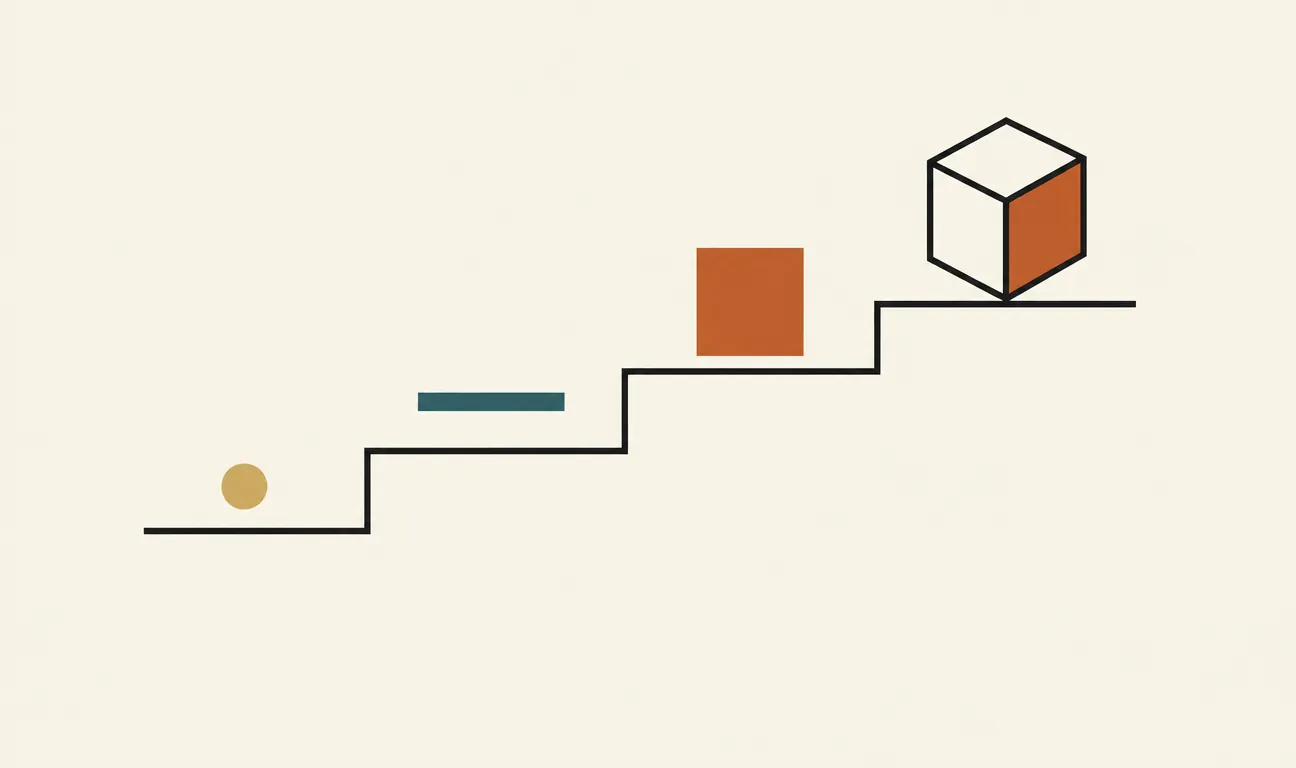
Una scala a quattro gradini
Il modo più pulito di arrivarci è salire una scala. Al primo gradino c’è lo scalare: un numero solo, come la temperatura di oggi, 23,5 gradi. Per trovarlo non serve nessun indice: è lì e basta. Si dice che ha rango zero.
Al secondo gradino, mettete in fila più scalari — le temperature dei sette giorni della settimana — e avete un vettore: rango uno, serve un indice («dammi il terzo giorno»). Al terzo, impilate più vettori — le temperature di sette giorni per dodici città — e avete una matrice: rango due, servono due indici, riga e colonna.
Il quarto gradino è quello dove il vocabolario quotidiano si arrende. Le temperature di sette giorni, per dodici città, misurate a quattro orari diversi richiedono tre indici, e quell’oggetto non ha un nome dedicato: è semplicemente un tensore di rango tre. La scala poi continua senza limiti — rango quattro, cinque, quanti ne servono. Un tensore è la generalizzazione della sequenza scalare → vettore → matrice: ogni gradino aggiunge un asse, cioè una domanda in più a cui rispondere per pescare un numero dalla scatola.
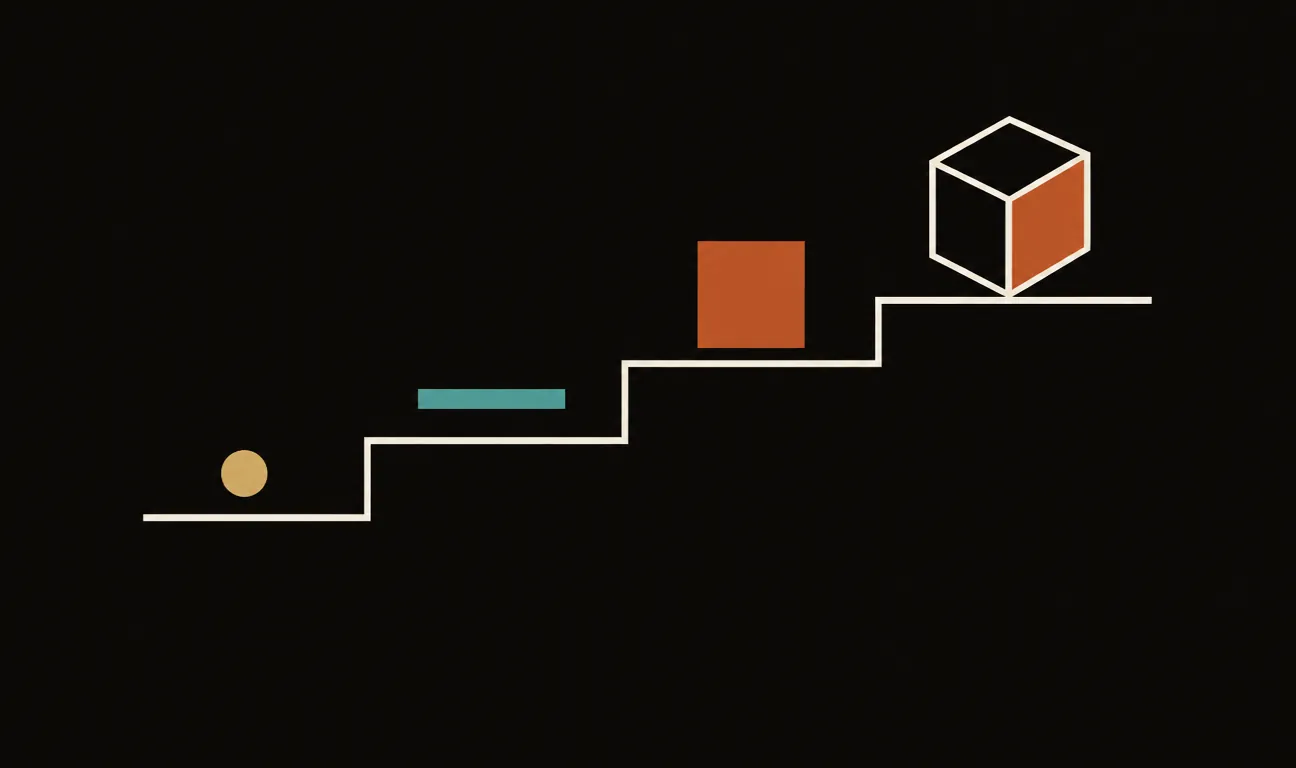
Ogni gradino della scala aggiunge un asse: dallo scalare (nessun indice) al tensore di rango 3 (tre indici), la struttura è sempre la stessa griglia di numeri.
Shape: la carta d’identità della scatola
Nella pratica quotidiana, di un tensore interessa quasi solo una cosa: la sua shape, la tupla che dice quanti elementi ci sono lungo ogni asse. Quel (32, 3, 224, 224) del messaggio d’errore iniziale si legge così: 32 immagini in un batch, 3 canali di colore (rosso, verde, blu), 224 righe e 224 colonne di pixel. Quattro assi, rango quattro — e ogni asse ha un significato, che però esiste solo nella testa di chi ha scritto il codice: per la macchina sono numeri in fila, indistinguibili.
È la stessa logica di un magazzino ben etichettato: corridoio, scaffale, ripiano, posizione. Il magazzino non sa cosa contengono le scatole; sa solo come arrivarci con quattro coordinate. La maggior parte dei bug nel deep learning quotidiano — la rete che non accetta l’input, la loss che esplode, il risultato trasposto — sono errori di coordinate: assi nell’ordine sbagliato, un asse dimenticato, un batch scambiato per un canale. Per questo la prima mossa di debug è quasi sempre stampare la shape.
Il malinteso con i fisici
Vale la pena essere onesti su un punto: il tensore dei matematici e dei fisici non è esattamente questo. In geometria differenziale un tensore è un oggetto multilineare che esiste indipendentemente dalle coordinate scelte, e che si trasforma secondo regole precise quando si cambia sistema di riferimento. L’array di numeri, in quel mondo, è solo la rappresentazione del tensore in un particolare sistema di coordinate — la fotografia, non la persona.
Il deep learning si è tenuto la parola e ha lasciato indietro la matematica: dei tensori di Einstein resta il nome, non le regole di trasformazione.
Quando TensorFlow, PyTorch e simili dicono «tensore», intendono la fotografia: la griglia di numeri, senza alcuna pretesa di invarianza geometrica. Non è un errore, è una scelta di vocabolario — ma spiega il dialogo tra sordi che ogni tanto si vede online tra fisici e ML engineer che usano la stessa parola per due cose diverse.
Perché tutto diventa tensore
Resta la domanda vera: perché il deep learning insiste a impacchettare tutto — immagini, testi, audio, pesi del modello — in queste scatole? La risposta è l’hardware. Le GPU sono nate per applicare la stessa operazione a milioni di pixel in parallelo, e sono diventate le macchine perfette per applicare la stessa operazione a milioni di numeri in parallelo. Ma per sfruttarle, i dati devono presentarsi in blocchi regolari e contigui in memoria: esattamente ciò che un tensore è.
Scrivere y = W @ x + b invece di tre cicli annidati non è solo eleganza: è la differenza tra dare alla GPU un bancale ordinato da processare in blocco e passarle i pacchi uno alla volta. A questo si aggiunge il broadcasting, la convenzione per cui tensori di shape diverse ma compatibili si combinano senza copie esplicite: sommare un vettore di bias di shape (3,) a un batch (32, 3) funziona perché la libreria «allunga» virtualmente il vettore su tutte le 32 righe. Comodissimo — e prima fonte di bug silenziosi, quando due shape combaciano per caso e l’operazione sbagliata va in porto senza errori.
Perché ti riguarda
Se lavorate con modelli di machine learning, i tensori non sono un argomento tra gli altri: sono la lingua in cui tutto è scritto. Un LLM è, materialmente, qualche centinaio di tensori di pesi più una sequenza di operazioni tra tensori; un’immagine generata è un tensore prima di diventare pixel su schermo. Capire che sotto il nome intimidatorio c’è solo una griglia di numeri con più assi toglie di mezzo il timore reverenziale; capire shape, assi e broadcasting toglie di mezzo la metà buona degli errori. La prossima volta che PyTorch protesta con quattro numeri tra parentesi, non è un oracolo che parla in codice: è un magazziniere che vi chiede in quale corridoio avreste voluto mettere le scatole.
I commenti sono riservati agli iscritti.
Accedi per commentare