
Aggiungete una colonna al vostro dataset e l’accuratezza del modello sale. Ne aggiungete un’altra, e sale ancora. Alla ventesima, inspiegabilmente, comincia a scendere. Non è un bug nel codice e non è sfortuna: è geometria. Quando il numero di dimensioni cresce, lo spazio in cui vivono i dati cambia natura, e molte delle intuizioni che ci portiamo dietro dal mondo a tre dimensioni smettono di funzionare. Il fenomeno ha un nome quasi teatrale, coniato da Richard Bellman negli anni Cinquanta: la maledizione della dimensionalità.
La maledizione della dimensionalità, la PCA, t-SNE e UMAP, e i metodi di raggruppamento: tutto nel libro.
Leggi «Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato» nel libro →
Un’arancia fatta quasi solo di buccia
Partiamo da un’immagine concreta. Un’arancia normale è quasi tutta polpa: la buccia è un sottile strato esterno, una frazione trascurabile del volume. Ora immaginate un’arancia in cento dimensioni, con lo stesso raggio ma immersa in uno spazio con molte più direzioni. Per quanto suoni assurdo, quell’arancia sarebbe quasi interamente buccia: la polpa, il centro, conterrebbe una porzione di volume prossima allo zero.
Il motivo è aritmetico. Se restringiamo una sfera del 10% lungo ogni asse, il volume che resta è 0,9 elevato al numero di dimensioni. In tre dimensioni fa circa il 73%: la polpa domina, come nell’esperienza quotidiana. In cento dimensioni fa 0,9100, cioè circa tre millesimi di punto percentuale: lo 0,003%. Tutto il resto — oltre il 99,99% del volume — sta in quel guscio sottile vicino alla superficie. In alta dimensione il volume non abita il centro delle figure: si accumula ai bordi.
Gli angoli che si mangiano tutto
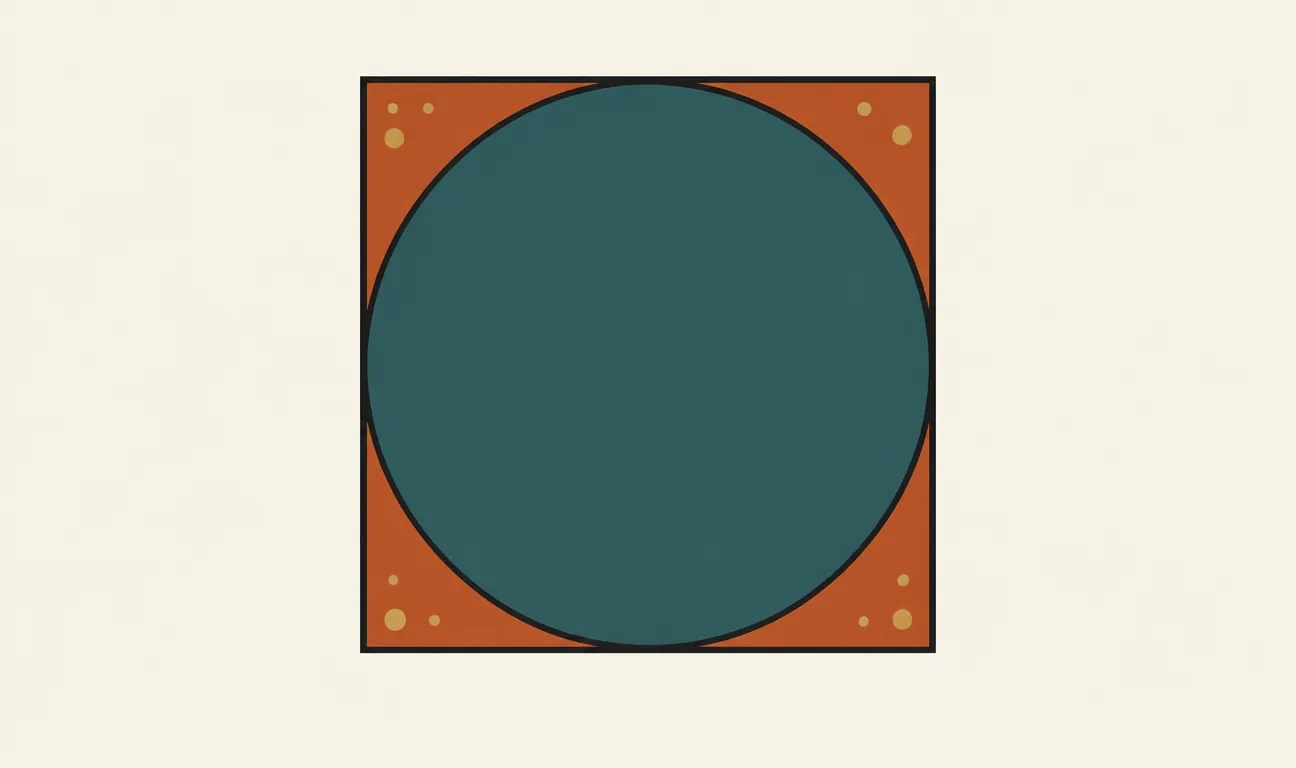
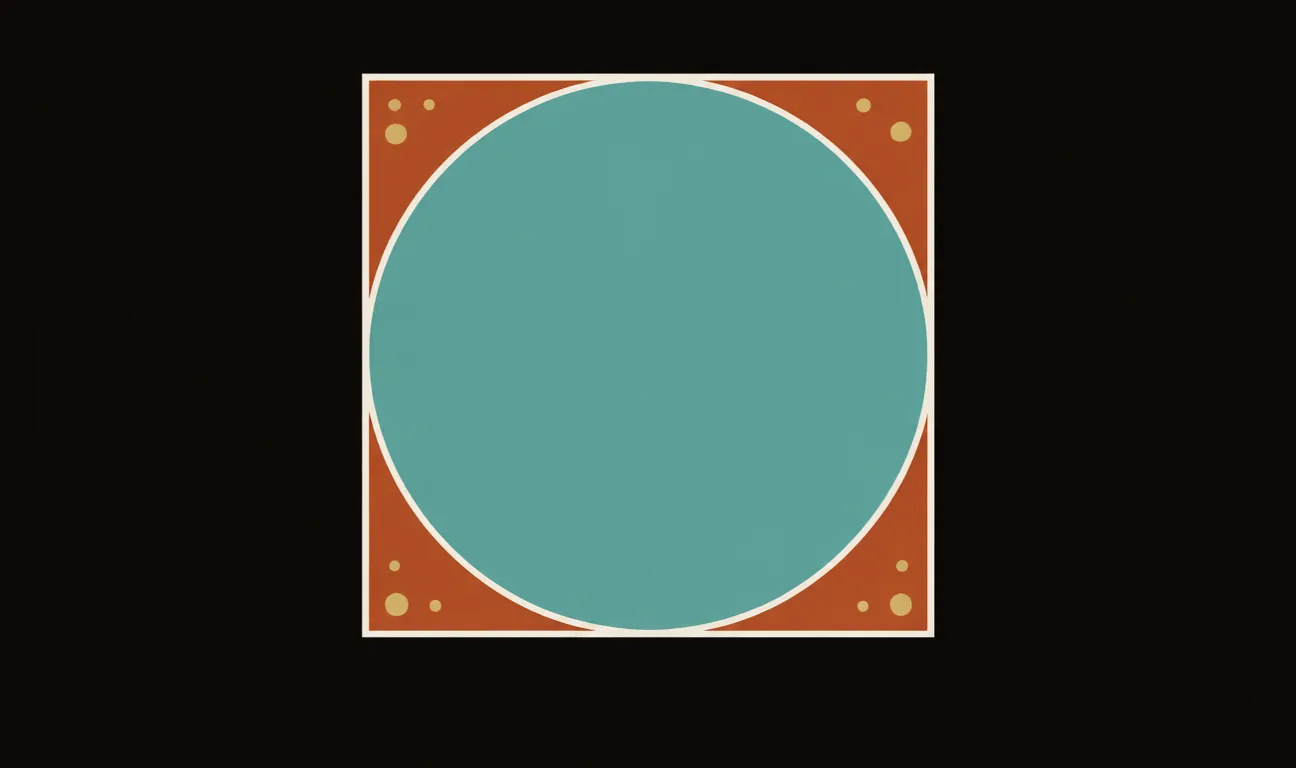
Lo stesso scherzo si ripete con il cubo e la sfera. Prendete un quadrato e inscrivetegli un cerchio: il cerchio copre circa il 78,5% dell’area, gli angoli si prendono il resto. Passate al cubo con la sfera inscritta: la sfera scende al 52,4%. Continuate ad aggiungere dimensioni e la sfera evapora: in dieci dimensioni occupa circa lo 0,25% dell’ipercubo. Praticamente tutto il volume si è trasferito negli angoli — che nel frattempo sono diventati 1.024, sempre più numerosi e sempre più lontani dal centro. L’ipercubo ad alta dimensione somiglia meno a una scatola e più a un riccio: un corpo centrale minuscolo da cui sporgono aculei lunghissimi.
La sfera inscritta nel cubo (in teal) si riduce al crescere delle dimensioni: in 10D quasi tutto il volume (in ocra) vive negli angoli dell’ipercubo.
Quando i vicini smettono di essere vicini
Questa geometria contorta ha una conseguenza diretta sugli algoritmi. Molti metodi classici — k-nearest neighbors, clustering, metodi kernel — si fondano su un’idea semplice: punti vicini si assomigliano. Ma in alta dimensione la nozione stessa di «vicino» si sgretola.
Se distribuite punti a caso in uno spazio con molte dimensioni e misurate le distanze tra coppie, scoprite che sono tutte quasi uguali: la differenza tra il punto più vicino e quello più lontano diventa trascurabile rispetto alla distanza media. È come chiedere a qualcuno di indicare il proprio migliore amico in una folla dove tutti stanno esattamente alla stessa distanza: la domanda perde senso. Un algoritmo che classifica guardando «i cinque punti più vicini» finisce per scegliere vicini che non sono più vicini di chiunque altro.
In alta dimensione tutti i punti sono lontani da tutti, e nessuno è davvero il vicino di nessuno.
Quanti dati servirebbero davvero
C’è poi il problema della copertura. Supponiamo di voler campionare uno spazio in modo decente, con una griglia che divide ogni asse in dieci intervalli. In una dimensione bastano 10 punti. In due, 100. In dieci dimensioni servono dieci miliardi di punti; in venti, cento miliardi di miliardi. Il fabbisogno di dati cresce esponenzialmente con le dimensioni, mentre i dataset reali crescono, nella migliore delle ipotesi, linearmente con il budget.
Il risultato è che in alta dimensione ogni dataset è, in senso geometrico, quasi vuoto: i punti osservati sono isole minuscole in un oceano di spazio mai campionato. Un modello abbastanza flessibile può sempre trovare una regola che separa perfettamente pochi punti sparsi in uno spazio enorme — ed è esattamente la ricetta dell’overfitting. Più dimensioni significano più modi di trovare pattern che esistono solo nel campione, non nel mondo.
Le vie di fuga
Se la maledizione fosse inaggirabile, il deep learning non funzionerebbe: un’immagine a colori di 224×224 pixel vive in uno spazio a più di 150.000 dimensioni, eppure le reti la classificano benissimo. Il trucco è che i dati reali non riempiono quasi mai lo spazio in cui sono rappresentati. Le foto di volti, ad esempio, sono una frazione infinitesimale di tutte le possibili griglie di pixel: occupano una regione a bassa dimensione — una sorta di superficie curva, un manifold — immersa nello spazio gigante. È la cosiddetta ipotesi del manifold, e cambia le regole del gioco: non serve coprire tutto lo spazio, basta imparare la superficie su cui i dati vivono davvero.
Da qui discendono le strategie pratiche. La riduzione di dimensionalità (PCA, UMAP, autoencoder) cerca esplicitamente quelle coordinate intrinseche. La selezione delle feature elimina le colonne che portano rumore invece di segnale. La regolarizzazione penalizza i modelli che sfruttano troppe dimensioni contemporaneamente. E le reti profonde, per come sono costruite, imparano rappresentazioni intermedie compatte: ogni strato è, in un certo senso, una macchina per comprimere via le dimensioni inutili.
Perché ti riguarda
La maledizione della dimensionalità non è una curiosità da matematici: è il motivo per cui «aggiungiamo un’altra feature» non è mai gratis. Ogni colonna in più allarga lo spazio da coprire, diluisce le distanze e regala al modello nuovi modi di imparare a memoria. Se lavorate con dati tabellari, è l’argomento per preferire venti feature scelte bene a duecento accumulate per inerzia. Se usate embedding e ricerca vettoriale — il cuore di ogni sistema RAG — è il motivo per cui la dimensione degli embedding e la metrica di similarità non sono dettagli implementativi, ma decisioni che toccano la geometria stessa del problema. E quando un modello peggiora dopo che gli avete dato più informazioni, ora sapete dove guardare: non nel codice, ma negli angoli dell’ipercubo.
I commenti sono riservati agli iscritti.
Accedi per commentare