
Il nuovo modello raggiunge l’87,2% di accuratezza sul test set. Il vecchio si fermava all’86,8%. Quattro decimi di punto in più: il team festeggia, il changelog annuncia il miglioramento, il modello va in produzione. Ma il test set contiene 500 esempi, e quattro decimi di punto su 500 esempi corrispondono a due risposte esatte in più. Due. Se rimescolaste il test set — stessi dati, stessa distribuzione, esemplari diversi — c’è un’ottima probabilità che la classifica si inverta. Il festeggiamento potrebbe essere per un lancio di moneta.
Questa scena si ripete ogni giorno in aziende e laboratori. La statistica ha strumenti collaudati da un secolo per distinguere un miglioramento reale dal rumore, ma nella pratica del machine learning vengono usati sorprendentemente poco. Vediamo quali sono e come si applicano, senza formalismi superflui.
Un’accuratezza è una stima, non una verità
Il primo passo è un cambio di prospettiva. L’accuratezza sul test set non è «la» prestazione del modello: è una stima della prestazione vera, calcolata su un campione finito. Il numero che ci interessa davvero — quanto spesso il modello risponderebbe correttamente sull’intera popolazione di casi possibili — non lo conosceremo mai. Il test set è una finestra su quella popolazione, e come ogni finestra mostra un panorama parziale.
L’analogia giusta è il sondaggio elettorale. Nessun istituto demoscopico titolerebbe «il candidato A è al 47,2%» senza aggiungere il margine d’errore: con mille intervistati, quel 47,2% significa «da qualche parte tra il 44% e il 50%, con ragionevole fiducia». La stessa onestà dovrebbe valere per un modello: valutarlo su 500 esempi è come sondare 500 elettori. Il numero che esce ha un margine d’errore, che lo scriviate o no.
Quanto trema il numero
Per l’accuratezza il margine si calcola in un rigo. Ogni predizione è un esperimento che riesce o fallisce, quindi il conteggio dei successi segue una distribuzione binomiale, e l’errore standard della stima è sqrt(p(1-p)/n), dove p è l’accuratezza osservata e n la dimensione del test set. L’intervallo di confidenza al 95% si estende circa due errori standard sopra e sotto la stima.
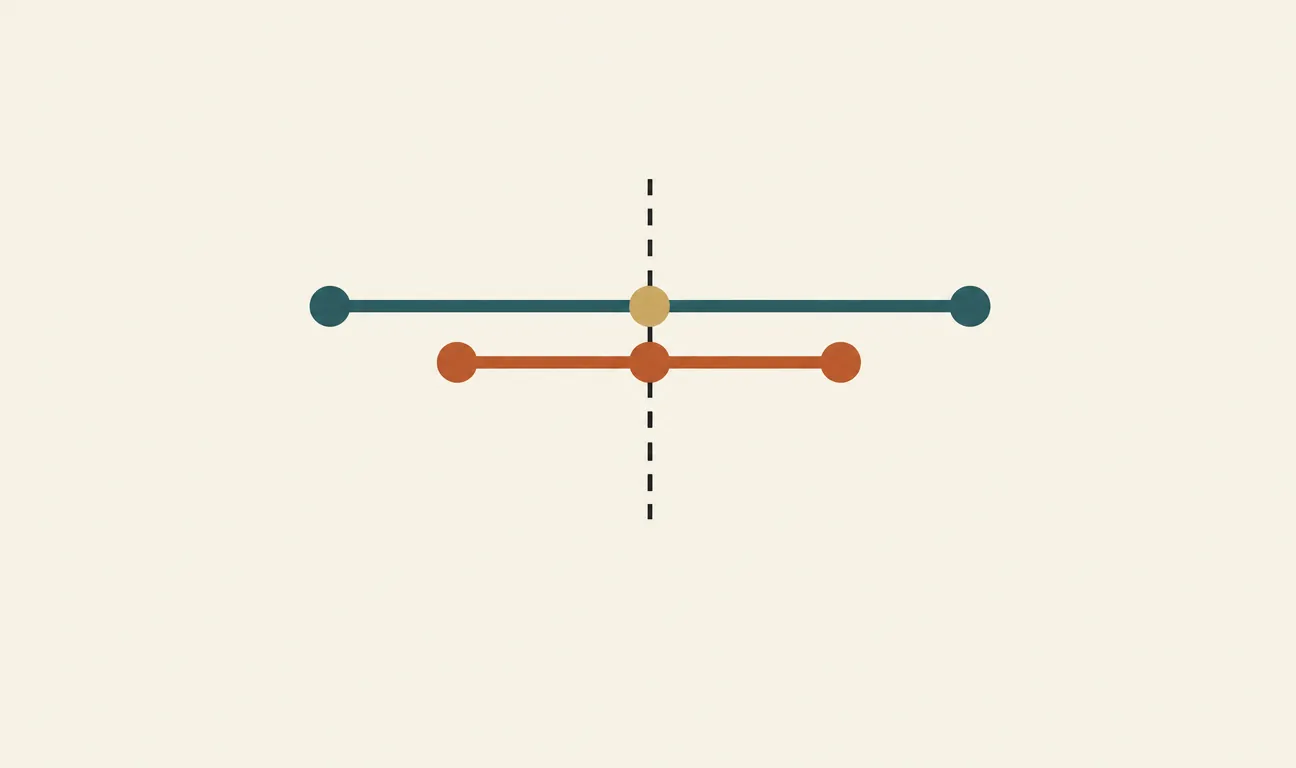
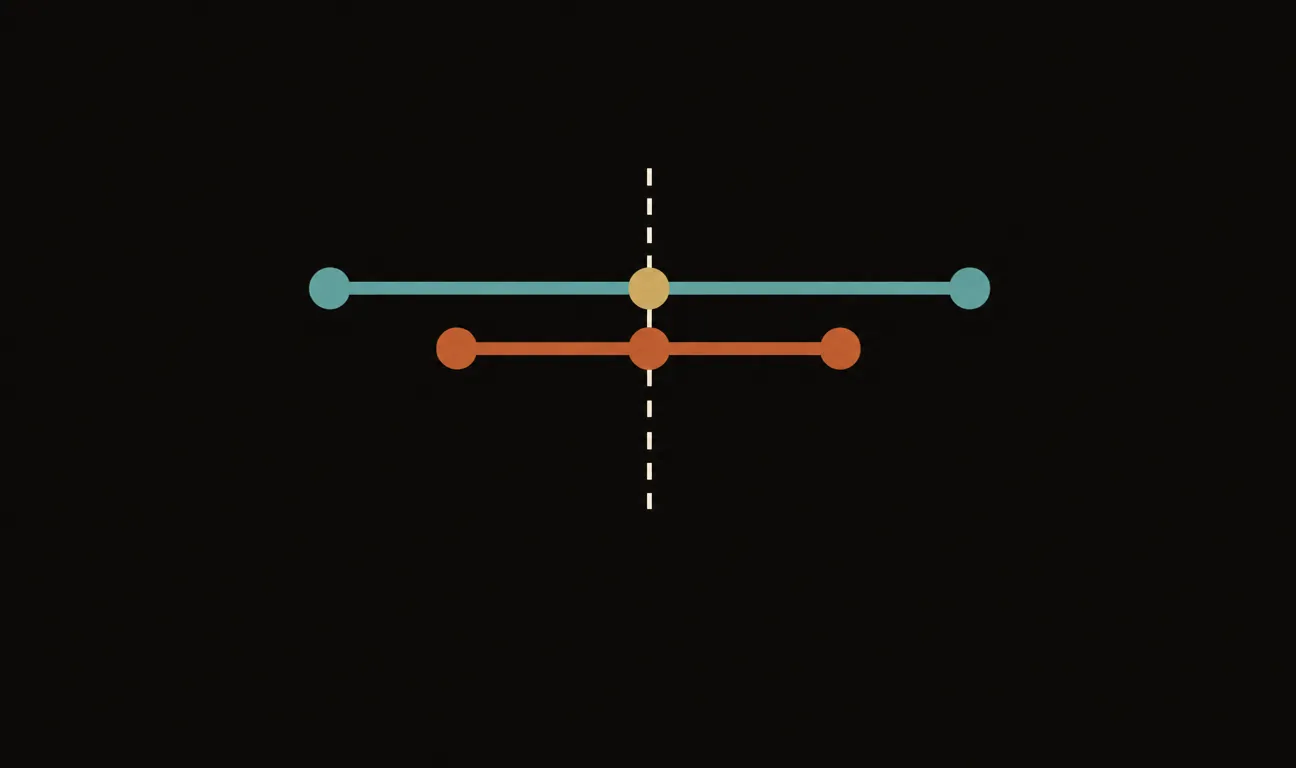
Facciamo i conti sul nostro esempio: con p = 0,87 e n = 500, l’errore standard vale circa 0,015. L’intervallo al 95% è quindi 87,2% ± 2,9 punti: la prestazione vera è plausibilmente ovunque tra l’84,3% e il 90,1%. Il vecchio modello, all’86,8% ± 3 punti, occupa un intervallo quasi identico. I due intervalli si sovrappongono quasi completamente: sulla base di questi dati, dichiarare un vincitore è indifendibile.
C’è una conseguenza scomoda da digerire: l’intervallo si restringe con la radice quadrata di n. Per dimezzare il margine servono quattro volte gli esempi; per ridurlo di dieci volte, cento volte gli esempi. Distinguere in modo affidabile due modelli separati da mezzo punto di accuratezza richiede test set da decine di migliaia di esempi — molto più grandi di quelli che la maggior parte dei progetti si può permettere.
Un’accuratezza senza intervallo di confidenza è una misura senza unità: un numero che sembra preciso solo perché tace la propria incertezza.
Tre modelli valutati sullo stesso test set, con intervalli di confidenza al 95%. A e B sembrano diversi guardando solo il punto centrale, ma i loro intervalli si sovrappongono quasi del tutto: la differenza è indistinguibile dal rumore. Solo C è distinguibile dagli altri due.
Il confronto giusto è appaiato
C’è però una sottigliezza che lavora a nostro favore. Quando due modelli vengono valutati sullo stesso test set, confrontare i due intervalli separati è un test più severo del necessario. La domanda giusta non è «quanto è incerta ciascuna accuratezza?», ma «sui casi in cui i due modelli danno risposte diverse, chi vince più spesso?».
È la differenza tra pesare due persone su due bilance diverse e farle salire a turno sulla stessa: nel secondo caso l’errore della bilancia si cancella, perché colpisce entrambe allo stesso modo. I test appaiati sfruttano proprio questo. Il test di McNemar, il classico per i classificatori, ignora tutti gli esempi su cui i due modelli concordano — che siano entrambi giusti o entrambi sbagliati — e guarda solo i casi discordanti: se il modello A corregge 30 errori di B ma B ne corregge 25 di A, la domanda diventa se 30 contro 25 possa essere frutto del caso. (Spoiler: sì, tranquillamente.)
Un’alternativa più flessibile, che funziona per qualunque metrica e non solo per l’accuratezza, è il bootstrap: si ricampiona il test set con reimmissione migliaia di volte, si ricalcola la differenza tra i due modelli su ogni ricampionamento e si osserva la distribuzione risultante. Se la differenza cambia segno in una frazione consistente dei ricampionamenti, non avete le prove per dichiarare un vincitore. Il costo è qualche secondo di calcolo; il beneficio è sapere se state guardando un segnale o il rumore.
Le trappole: confronti multipli e test set consumati
Anche con i test giusti restano due modi eleganti di ingannarsi. Il primo sono i confronti multipli. Un test al 95% concede, per costruzione, un falso positivo ogni venti confronti. Se provate venti configurazioni di iperparametri e scegliete quella con l’accuratezza più alta sul test set, avete ottime probabilità di aver selezionato la più fortunata, non la migliore. È come premiare chi fa sei su un dado dopo aver fatto tirare venti persone: qualcuno farà sei quasi sicuramente, e non è merito suo.
Il secondo è il test set consumato. Ogni volta che guardate il risultato sul test set e prendete una decisione di conseguenza — cambiare architettura, aggiustare una soglia, riprovare — trasferite un po’ di informazione dal test set al modello. Dopo abbastanza iterazioni, il test set non misura più la generalizzazione: misura quanto vi siete adattati a lui. È il motivo per cui i punteggi sui benchmark pubblici tendono a gonfiarsi col passare degli anni, e per cui la disciplina classica prevede tre insiemi separati: training per imparare, validation per scegliere, test per la stima finale — da toccare il meno possibile.
Perché vi riguarda
Se sviluppate modelli, la ricetta minima è breve: riportate sempre l’intervallo accanto alla metrica, usate un test appaiato (McNemar o bootstrap) prima di dichiarare un miglioramento, fate le scelte sul validation set e riservate il test alla verifica finale. Sono venti righe di codice che vi risparmiano di inseguire miglioramenti immaginari — o di scartare per sfortuna un’idea buona, che è l’errore simmetrico e altrettanto costoso.
Se invece i modelli li scegliete o li acquistate, avete appena guadagnato una domanda affilata da fare a chiunque vi mostri una tabella di benchmark: «quanto è grande il test set, e la differenza è statisticamente significativa?«. Se chi avete davanti non sa rispondere, il numero sulla slide vale quanto un sondaggio fatto a un condominio: forse indicativo, certamente non una prova. L’onestà statistica non è pignoleria accademica — è l’unica cosa che separa una valutazione da una speranza.
I commenti sono riservati agli iscritti.
Accedi per commentare