
Immagina di dover scendere da una montagna di notte, con una lanterna che illumina soltanto il metro di terreno sotto i tuoi piedi. Non vedi la valle, non vedi il sentiero: puoi solo sentire da che parte pende il suolo e fare un passo in discesa. Poi un altro. Poi un altro ancora. Questo, spogliato di ogni formula, è quello che fa la discesa del gradiente quando addestra una rete neurale. E come ogni escursionista notturno sa, il problema non è camminare: è capire dove si finisce.
Derivate, gradiente, regola della catena e discesa del gradiente sono trattati per esteso nel libro, formule comprese.
Leggi «Analisi e ottimizzazione: derivate e discesa del gradiente» nel libro →
Il terreno su cui si cammina si chiama paesaggio della loss, ed è uno degli oggetti più strani della matematica applicata. Capire com’è fatto — dove ha buche, pianure e passi di montagna — spiega perché il deep learning funziona molto meglio di quanto la teoria classica lasciasse sperare.
Il paesaggio della loss
Ogni configurazione dei pesi di una rete produce un certo errore sui dati di training: la loss. Se la rete avesse due soli pesi, potremmo disegnare la loss come una superficie in tre dimensioni — due assi per i pesi, uno per l’errore — e vedremmo colline, valli e altipiani. Addestrare il modello significa trovare un punto basso di questa superficie.
Il problema è che una rete vera non ha due pesi: ne ha milioni, o miliardi. Il paesaggio non vive in tre dimensioni ma in miliardi di dimensioni, e la nostra intuizione da escursionisti — costruita su colline a tre dimensioni — comincia a tradirci in modi interessanti.
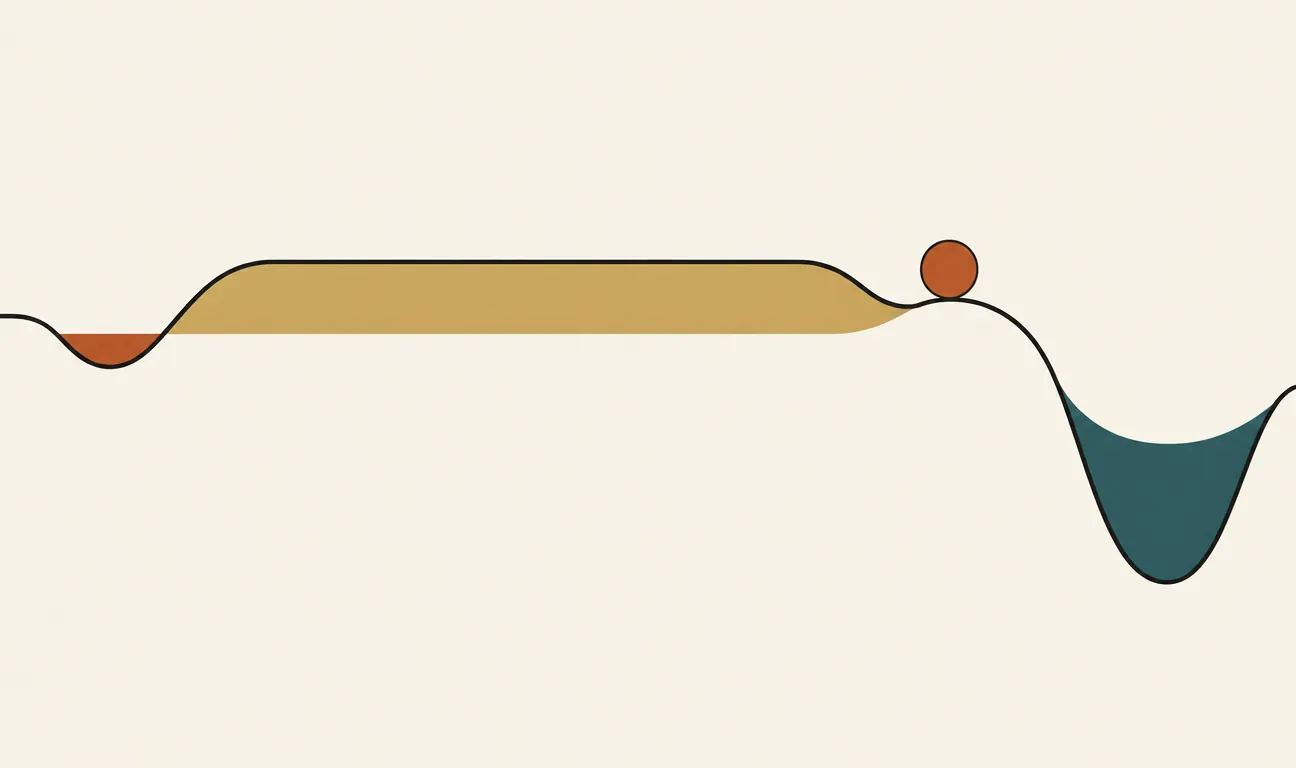
In questo paesaggio esistono tre tipi di punti in cui il gradiente si annulla, cioè in cui il terreno è localmente piatto e la lanterna non indica più nessuna direzione di discesa: i minimi (locali o globali), i punti di sella e i plateau. Non sono affatto equivalenti.
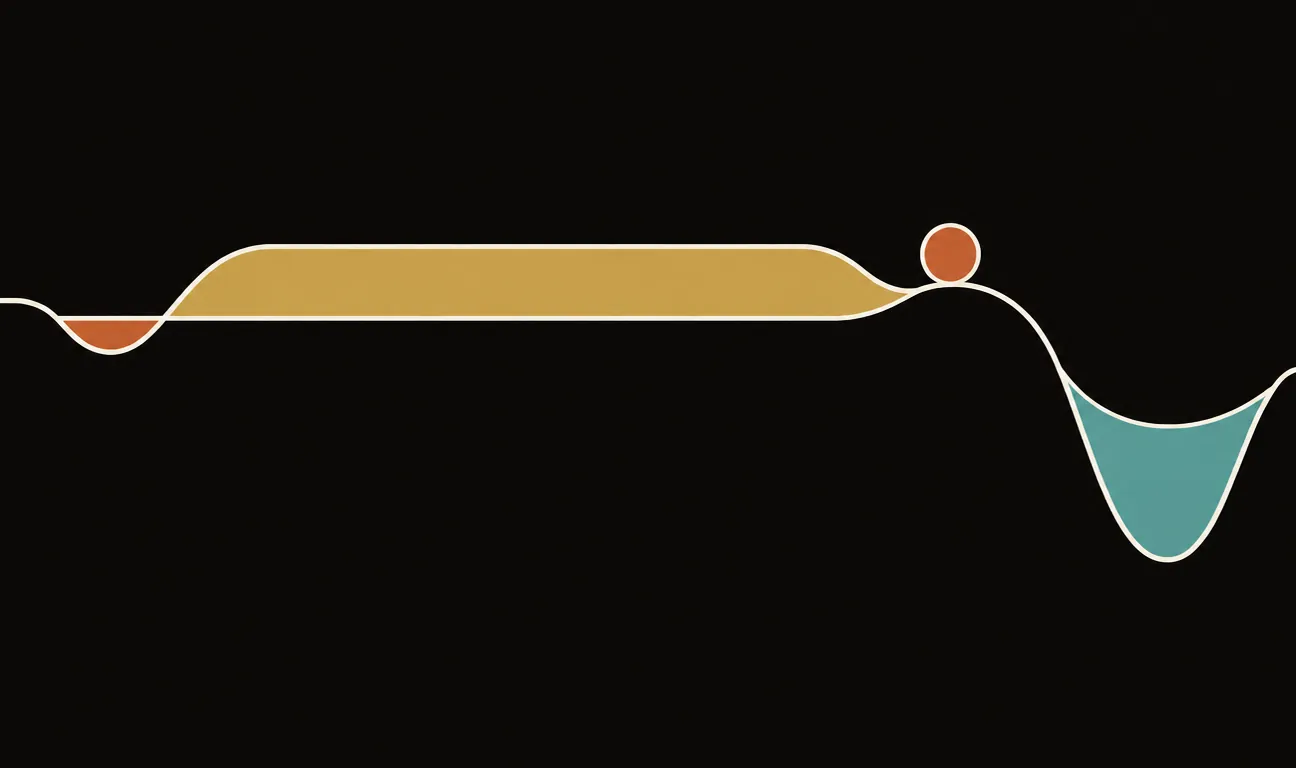
Un paesaggio di loss stilizzato: il plateau rallenta la discesa, il minimo locale la intrappola (in teoria), il punto di sella la inganna. Le curve arretrate suggeriscono che il paesaggio vero ha molte più dimensioni di quante ne possiamo disegnare.
Minimi locali: la trappola che ci hanno insegnato a temere
Il minimo locale è la buca classica: un punto più basso di tutto ciò che lo circonda, ma non il più basso in assoluto. Se la pallina ci finisce dentro, ogni direzione è in salita e la discesa del gradiente si ferma lì, convinta di aver finito. È la lezione standard di ogni corso di ottimizzazione: le funzioni non convesse hanno minimi locali, e i minimi locali sono cattivi.
Per anni questa è stata l’obiezione teorica principale al deep learning: la loss di una rete neurale è selvaggiamente non convessa, quindi — ragionava la teoria — il training dovrebbe incagliarsi di continuo in soluzioni mediocri. In pratica, però, le reti profonde si addestrano sorprendentemente bene. Come mai?
In alta dimensione la trappola cambia forma
La risposta sta in un argomento di conteggio quasi banale. In un punto in cui il gradiente si annulla, ogni direzione dello spazio può curvare verso l’alto (e allora in quella direzione siamo in una buca) o verso il basso (e allora siamo su una cresta). Perché il punto sia un vero minimo locale, tutte le direzioni devono curvare verso l’alto, contemporaneamente.
Con due dimensioni è facile: basta essere sfortunati due volte. Ma una rete con un milione di parametri vive in un milione di dimensioni. Se, semplificando molto, immaginiamo che ogni direzione curvi verso l’alto o verso il basso in modo più o meno indipendente, ottenere un milione di «verso l’alto» di fila è come lanciare una moneta un milione di volte e ottenere sempre testa.
In un milione di dimensioni, restare intrappolati in un minimo locale richiede di essere sfortunati un milione di volte di seguito.
Il punto critico tipico, in alta dimensione, non è quindi una buca: è una sella — un punto che sale in alcune direzioni e scende in altre. Studi empirici e teorici a metà anni Dieci (tra cui un lavoro di Dauphin e colleghi del 2014) hanno sostenuto proprio questo: negli spazi ad alta dimensione il vero ostacolo dell’ottimizzazione non sono i minimi locali, che tendono a essere rari e comunque di qualità simile al minimo globale, ma la proliferazione di punti di sella.
Punti di sella e plateau: dove il gradiente mente
Il punto di sella prende il nome dalla sella del cavallo: seduto lì, sei in un minimo rispetto alla direzione testa-coda (la sella ti accoglie), ma in un massimo rispetto alla direzione dei fianchi (basta spostarsi di lato per scivolare giù). Al centro esatto della sella il terreno è piatto: il gradiente è zero, esattamente come in un minimo. La lanterna del nostro escursionista non distingue i due casi.
Ecco perché le selle sono infide: rallentano l’ottimizzazione facendola sembrare conclusa. In loro prossimità il gradiente diventa minuscolo, la loss smette quasi di scendere, e chi guarda la curva di training può concludere che il modello ha «converso». In realtà basta un piccolo spintone in una direzione di discesa per riprendere il cammino.
I plateau sono il fenomeno cugino: vaste regioni quasi piatte, dove il gradiente non è zero ma è così piccolo che ogni passo sposta di pochissimo. Sono l’equivalente di una pianura padana con una pendenza dello 0,001%: tecnicamente stai scendendo, praticamente sei fermo. Attivazioni sature (come le code piatte della sigmoide) e cattive inizializzazioni sono generatori classici di plateau.
La buona notizia è che gli strumenti quotidiani del deep learning sono, di fatto, dispositivi anti-sella e anti-plateau. Il rumore dello stochastic gradient descent — che calcola il gradiente su mini-batch diversi a ogni passo — funziona come una vibrazione continua che fa scivolare la pallina fuori dai punti piatti. Il momentum le dà inerzia, così un plateau viene attraversato con la velocità accumulata prima, come un ciclista che smette di pedalare in pianura ma continua ad avanzare. E i learning rate schedule con warmup e restart servono anche a questo: dare energia quando il paesaggio si appiattisce.
Non tutti i minimi sono uguali
C’è un ultimo colpo di scena. Anche ammesso di arrivare in un minimo, conta quale minimo. Un’ipotesi molto discussa in letteratura distingue i minimi «larghi» — ampie conche dove la loss resta bassa anche spostando un po’ i pesi — dai minimi «stretti», crepacci angusti dove basta un passo per risalire. L’intuizione: un minimo largo corrisponde a una soluzione robusta, che tollera la differenza tra dati di training e dati reali, e quindi generalizza meglio; un minimo stretto è una soluzione fragile, tarata sui capricci del training set.
È anche uno dei motivi per cui il rumore di SGD viene considerato una benedizione più che un difetto: una pallina che vibra fatica a restare in un crepaccio stretto, mentre si assesta comodamente in una conca ampia. Va detto con onestà: la relazione tra larghezza dei minimi e generalizzazione è un tema ancora dibattuto, con controesempi noti (la «larghezza» dipende da come si parametrizza la rete), ma l’immagine resta una guida utile.
Perché ti riguarda
Se addestri modelli, anche piccoli, questa mappa del terreno cambia le diagnosi quotidiane. Una loss che ristagna quasi mai significa «siamo in un minimo locale, arrendiamoci»: molto più spesso significa plateau o sella, e le contromisure sono note — alzare temporaneamente il learning rate, usare momentum, cambiare inizializzazione, lasciare che il rumore dei mini-batch faccia il suo lavoro. Prima di buttare l’architettura, conviene dare uno spintone alla pallina.
E se i modelli li usi soltanto, questa storia spiega un piccolo miracolo che diamo per scontato: perché addestrare reti con miliardi di parametri, un problema che sulla carta è intrattabile, in pratica funziona in modo affidabile. La geometria dell’alta dimensione, che ci sembra un mondo alieno, qui gioca dalla nostra parte: più il paesaggio è vasto, più le trappole vere diventano rare, e più diventa questione di pazienza — un passo in discesa alla volta, con la lanterna in mano.
I commenti sono riservati agli iscritti.
Accedi per commentare