Ogni volta che qualcuno addestra una rete neurale — da un modello linguistico con miliardi di parametri a un piccolo classificatore su un portatile — sotto il cofano gira quasi sempre lo stesso algoritmo, o una sua variante. Si chiama discesa del gradiente, ha più di un secolo e mezzo (Cauchy lo descrisse nel 1847), e il suo nucleo sta comodamente in dieci righe di Python. In questo tutorial lo scriviamo da zero, senza PyTorch, senza TensorFlow, senza nemmeno NumPy per la prima parte. Solo Python e una derivata.
Derivate, gradiente, regola della catena e discesa del gradiente sono trattati per esteso nel libro, formule comprese.
Leggi «Analisi e ottimizzazione: derivate e discesa del gradiente» nel libro →
L’intuizione: scendere una valle nella nebbia
Immagina di trovarti su un fianco di montagna, di notte, con una nebbia così fitta da vedere solo il metro di terreno intorno ai tuoi piedi. Vuoi raggiungere il fondovalle. Non puoi vedere dove sia, ma puoi sentire con i piedi in quale direzione il terreno scende più ripidamente. La strategia ovvia: fai un passo in quella direzione, ritasti il terreno, fai un altro passo. Ripeti finché il terreno intorno a te non è piatto.
Questa è, letteralmente, la discesa del gradiente. La montagna è la funzione di loss: una funzione che misura quanto il modello sta sbagliando, e che dipende dai parametri del modello. La tua posizione è il valore attuale dei parametri. La pendenza sotto i piedi è il gradiente: la derivata della loss rispetto ai parametri, che indica in quale direzione l’errore cresce più in fretta. Camminare in direzione opposta al gradiente significa ridurre l’errore. La lunghezza del passo si chiama learning rate.
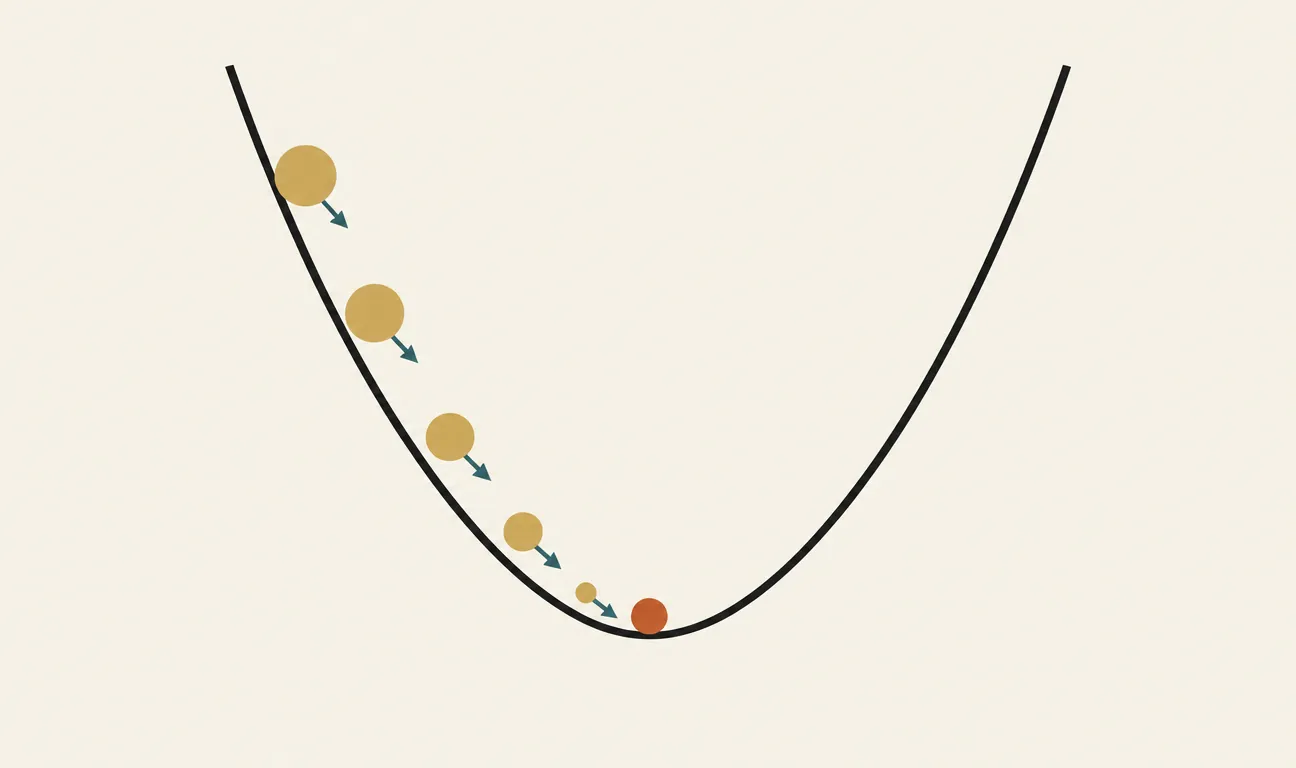
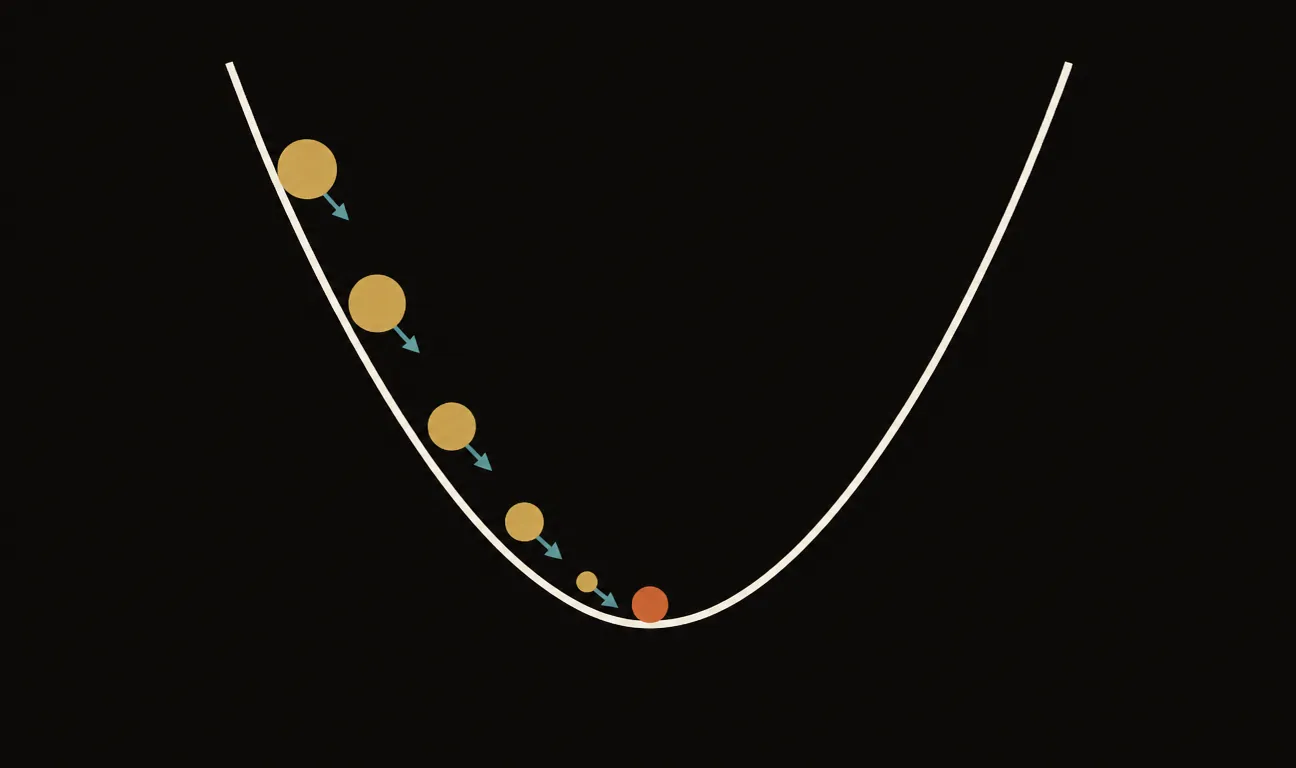
La traiettoria della discesa del gradiente su una curva di loss: i passi sono proporzionali alla pendenza, quindi si accorciano da soli avvicinandosi al minimo.
Il caso più semplice possibile: una parabola
Partiamo da una funzione di cui conosciamo già la risposta, così possiamo verificare che l’algoritmo funzioni: L(w) = (w - 3)². È una parabola con il minimo in w = 3. La sua derivata è L'(w) = 2(w - 3): positiva a destra del minimo, negativa a sinistra. La regola di aggiornamento è una sola riga: sottrai dal parametro la derivata moltiplicata per il learning rate.
def loss(w):
    return (w - 3) ** 2

def gradiente(w):
    return 2 * (w - 3)

w = -5.0            # partenza volutamente lontana dal minimo
lr = 0.1            # learning rate: la lunghezza del passo

for passo in range(30):
    g = gradiente(w)
    w = w - lr * g  # il cuore di tutto il deep learning
    if passo % 5 == 0:
        print(f"passo {passo:2d}: w = {w:8.4f}, loss = {loss(w):.6f}")
Eseguendo lo script, w parte da -5 e converge rapidamente verso 3, mentre la loss precipita verso zero. Nota un dettaglio elegante: non abbiamo mai detto all’algoritmo di rallentare vicino al minimo, eppure lo fa da solo. Il motivo è che la derivata 2(w - 3) si rimpicciolisce man mano che w si avvicina a 3, quindi i passi — proporzionali alla derivata — si accorciano automaticamente. Come un’altalena che perde ampiezza per attrito.
Il learning rate: il parametro che decide tutto
Prova a rieseguire il codice cambiando solo lr. Con lr = 0.01 la convergenza c’è ma è lenta: dopo 30 passi sei ancora lontano. Con lr = 0.9 il parametro salta da un fianco all’altro della parabola come una biglia in una ciotola, ma converge lo stesso. Con lr = 1.1 succede il disastro: ogni salto è più ampio del precedente e la loss diverge verso l’infinito.
for lr in [0.01, 0.5, 0.9, 1.1]:
    w = -5.0
    for _ in range(30):
        w = w - lr * gradiente(w)
    print(f"lr = {lr}: dopo 30 passi w = {w:.4f}")
Il learning rate è il compromesso fondamentale dell’ottimizzazione: passi troppo corti e non arrivi mai, passi troppo lunghi e scavalchi la valle atterrando più in alto di prima.
Nella pratica moderna il learning rate non è fisso: viene fatto variare durante l’addestramento con schedule di vario tipo, e ottimizzatori come Adam ne adattano una versione per ogni singolo parametro. Ma il dilemma di fondo resta esattamente questo.
Un problema vero: regressione lineare da zero
La parabola era un giocattolo. Ora usiamo lo stesso identico meccanismo per un compito reale: trovare la retta y = w·x + b che meglio approssima dei dati. Stavolta i parametri sono due (w e b) e il gradiente ha due componenti — una derivata parziale per ciascuno. La loss è l’errore quadratico medio sulle predizioni.
import random

# Dati sintetici: la "verita'" e' y = 2x + 1, piu' rumore
random.seed(42)
dati = [(x, 2 * x + 1 + random.gauss(0, 0.3))
        for x in [i / 10 for i in range(50)]]

w, b = 0.0, 0.0   # partiamo da una retta piatta sull'origine
lr = 0.05

for epoca in range(200):
    # Gradiente della loss quadratica media rispetto a w e b
    grad_w = sum(2 * (w * x + b - y) * x for x, y in dati) / len(dati)
    grad_b = sum(2 * (w * x + b - y)     for x, y in dati) / len(dati)

    w = w - lr * grad_w
    b = b - lr * grad_b

    if epoca % 50 == 0:
        mse = sum((w * x + b - y) ** 2 for x, y in dati) / len(dati)
        print(f"epoca {epoca:3d}: w = {w:.3f}, b = {b:.3f}, mse = {mse:.4f}")

print(f"Risultato: y = {w:.2f}x + {b:.2f}  (verita': y = 2x + 1)")
Dopo duecento epoche, w e b approdano molto vicini a 2 e 1: l’algoritmo ha recuperato la retta nascosta nel rumore. Vale la pena fermarsi su cosa non abbiamo fatto: non abbiamo risolto nessuna equazione, non abbiamo usato la formula chiusa della regressione (che esiste). Abbiamo solo seguito la pendenza, un passo alla volta. È un metodo più lento della formula chiusa per questo problema — ma funziona identico anche quando i parametri sono centosettanta miliardi e nessuna formula chiusa esiste.
Dal nostro script a GPT: cosa cambia e cosa no
Tra il nostro script e l’addestramento di un modello linguistico ci sono tre differenze principali, e nessuna tocca il cuore dell’algoritmo.
- Il gradiente non si scrive a mano. Noi abbiamo derivato la loss con carta e penna. Con milioni di parametri è impensabile: ci pensa la differenziazione automatica (l’autograd di PyTorch), che applica la regola della catena meccanicamente. La backpropagation è esattamente questo: calcolo efficiente del gradiente in una rete.
- Non si usano tutti i dati a ogni passo. Il nostro script somma l’errore su tutto il dataset a ogni aggiornamento. Con miliardi di esempi si usa un piccolo campione casuale (mini-batch) a ogni passo: il gradiente diventa una stima rumorosa ma economica. È la «S» di SGD, discesa del gradiente stocastica.
- Il paesaggio non è una ciotola. La nostra loss aveva un solo minimo. Quella di una rete profonda è un paesaggio ad altissima dimensione pieno di valli, plateau e punti di sella — un tema che merita un articolo a sé. Sorprendentemente, seguire la pendenza locale funziona bene lo stesso.
Perché ti conviene averlo scritto una volta
Chi usa i framework moderni non scriverà mai più w = w - lr * g a mano: sta dentro optimizer.step(), invisibile. Ma averlo scritto una volta cambia il modo in cui leggi tutto il resto. Quando l’addestramento diverge, sai che probabilmente il learning rate è troppo alto — hai visto la biglia uscire dalla ciotola con i tuoi occhi. Quando la loss ristagna, sai che il gradiente da qualche parte si è fatto piccolo. Quando senti parlare di warmup, schedule, momentum o Adam, sai che sono tutte risposte a un’unica domanda: quanto deve essere lungo il prossimo passo, e in quale direzione esatta.
La nebbia sulla montagna resta fitta anche per i modelli più grandi del mondo. Semplicemente, hanno imparato a camminare molto bene.
I commenti sono riservati agli iscritti.
Accedi per commentare