
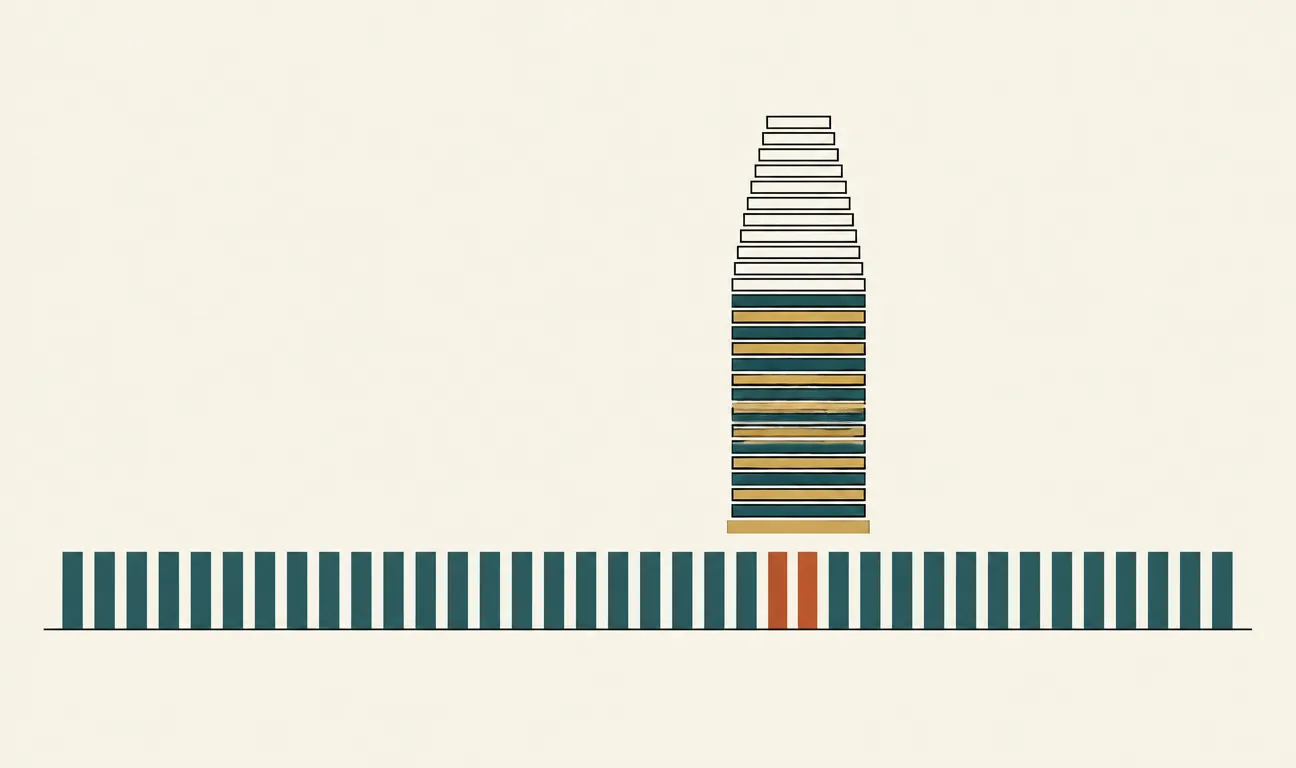
Immaginate una piscina comunale con quaranta corsie e un concorso in cui il premio non è una somma di denaro ma una corsia tutta per sé, per un anno, gratis. Chi vince non riceve un euro: riceve acqua e tempo, e l’impegno a tornare con un risultato. È più o meno la forma del premio che la Commissione europea ha assegnato il 19 giugno. Le corsie sono i supercomputer pubblici dell’impresa comune EuroHPC, e la quota è «fino al 2,5 per cento» della loro capacità complessiva per un anno: una corsia su quaranta. Chi l’ha vinta deve usarla per addestrare un modello linguistico da oltre 400 miliardi di parametri, aperto, capace di lavorare in tutte le 24 lingue ufficiali dell’Unione.
La Commissione ha scelto EUROPA, un consorzio europeo «guidato dall’impresa italiana Domyn», come vincitore della Frontier AI Grand Challenge. Secondo la pagina del progetto che ha gestito la gara e il comunicato dell’istituto tedesco, con Domyn ci sono due istituti della Fraunhofer-Gesellschaft, lo IAIS (analisi intelligente e sistemi informativi) e lo IIS (circuiti integrati). «L’Europa può guidare l’AI avanzata alle proprie condizioni», ha detto la vicepresidente esecutiva Henna Virkkunen.
Una premessa va detta subito: il modello non esiste ancora. Esistono una gara vinta, una quota di calcolo promessa e una scadenza dichiarata. Questo pezzo racconta che cosa chiedeva il bando, chi sono i vincitori, che cosa hanno promesso e che cosa, al 24 settembre, non si sa.
Che cosa chiedeva la gara
La Frontier AI Grand Challenge è stata lanciata il 13 febbraio 2026 dalla Commissione insieme all’impresa comune EuroHPC, dentro la strategia Apply AI, e affidata ad AI-BOOST, un progetto finanziato dal programma Horizon Europe che organizza competizioni sull’AI. Per EuroHPC è la seconda gara sull’AI organizzata con la Commissione. Le domande si potevano presentare fino al 13 aprile; i risultati erano attesi per maggio e sono arrivati il 19 giugno. Il vincitore doveva essere uno solo.
Le linee guida per i candidati sono più precise dei comunicati. Il modello doveva avere capacità «equivalenti ad almeno 400 miliardi di parametri», usare un’architettura modulare come la mixture of experts, essere addestrato seguendo le leggi di scala ottimali fra calcolo e dati, e superare lo stato dell’arte in una serie di compiti rilevanti. Doveva anche restare un modello generale, adattabile a compiti nuovi con un riaddestramento o un fine-tuning.
Che cosa vuol dire che un modello è «a miscela di esperti», e perché il numero totale di parametri non è quello che lavora a ogni parola, è spiegato nel libro.
Potevano partecipare soltanto imprese industriali stabilite nell’Unione e «sotto controllo UE», che una nota definisce così: non possedute direttamente per più della metà del capitale da soggetti di Paesi extra UE. Università ed enti di ricerca potevano entrare come partner, ma il capofila doveva essere un’impresa privata. Tutti dovevano dimostrare di aver già sviluppato e messo in esercizio modelli da oltre 100 miliardi di parametri, di conoscere le architetture modulari, di avere esperienza su tutte le lingue dell’Unione e accesso ai dati. E il bando prevedeva che dimostrassero di avere già assicurato altro calcolo, nazionale o privato, per coprire il fabbisogno complessivo dell’addestramento: la quota europea non era pensata per bastare da sola.
Sull’apertura il bando è meno netto dei comunicati. Annuncia «modelli aperti» da mettere largamente a disposizione di amministrazioni, ricercatori e imprese; ma fra i requisiti chiede di impegnarsi ai principi di scienza aperta di Horizon Europe, con pubblicazioni ad accesso aperto, dati gestiti secondo i principi FAIR e, «dove applicabile», il rilascio dei pesi, dei dettagli dell’architettura o della documentazione. Chiedeva anche di dimostrare che lo sviluppo avrebbe tenuto conto dell’AI Act. La valutazione, affidata a una giuria da tre a cinque esperti nominati da AI-BOOST ed EuroHPC, dava poi dei punti in più: uno per un approccio open source con pesi aperti, due per modelli multimodali con forti capacità in molte lingue dell’Unione, due per la «dimensione europea». I pesi aperti, insomma, erano un’attesa dichiarata e un vantaggio in graduatoria, più che un obbligo scritto.
Il premio: calcolo, non denaro
Il vincitore non riceve un finanziamento. Riceve un accesso gratuito e «strategico» ai supercomputer EuroHPC, fino al 2,5 per cento della capacità complessiva per un anno, prorogabile dal consiglio direttivo dell’impresa comune, più i servizi delle AI Factory, i centri europei di supporto all’AI costruiti attorno a quelle macchine. Le linee guida parlano di uno o più supercomputer «ottimizzati per l’AI», già operativi o in arrivo, scelti in base a disponibilità e caratteristiche tecniche. A febbraio EuroHPC dichiarava di averne acquistati dodici, fra cui JUPITER in Germania e Alice Recoque, i primi europei di classe exascale. Quali saranno usati per EUROPA non è stato annunciato.
Gli obblighi sono pochi e chiari: usare il tempo per il modello descritto nella proposta, consegnare un rapporto finale entro tre mesi dalla fine dell’assegnazione, citare EuroHPC in ogni pubblicazione e dichiarare il sostegno dell’Unione in ogni comunicazione. Sulla proprietà dei risultati le linee guida dicono che chi assegna il premio «non la acquisisce», e si riserva solo il diritto di usare le informazioni non riservate per comunicare.
Chi c’è nel consorzio
Domyn è una società milanese che fino al giugno 2025 si chiamava iGenius: il cambio di nome l’ha annunciato l’azienda stessa il 5 giugno 2025. Secondo Reuters è stata fondata a Milano nel 2016; il fondatore e amministratore delegato è Uljan Sharka. Lavora per settori regolati, cioè finanza, pubblica amministrazione e difesa, industria pesante, e il suo argomento commerciale è la «proprietà» dei modelli: il cliente li installa sulla propria infrastruttura, anche isolata dalla rete. Come iGenius aveva pubblicato nel 2024 un modello aperto da 9 miliardi di parametri, Modello Italia, sviluppato con il CINECA. Oggi la sua famiglia di modelli ne conta due: Domyn Large, da circa 260 miliardi di parametri, offerto alle imprese anche tramite Microsoft Foundry da aprile 2026, e Domyn Small, da 10 miliardi, uscito a maggio con i pesi aperti e licenza MIT. Domyn Small è stato addestrato sul supercomputer Leonardo del CINECA, nell’ambito della AI Factory italiana IT4LIA: è già, in piccolo, il modello di collaborazione fra un’impresa privata e il calcolo pubblico europeo che la gara premia in grande.
Domyn dichiara anche di costruire un proprio supercomputer, Colosseum, con NVIDIA e «in partnership» con gli Emirati Arabi Uniti. A Reuters l’azienda ha detto di essere sostenuta da G42 di Abu Dhabi e da investitori fra cui Eurizon, Rabobank e BNY, ma non ha voluto dare dettagli sui finanziamenti. Qui c’è una domanda legittima, a cui le fonti pubbliche non rispondono. Il bando ammetteva solo imprese non possedute direttamente per più della metà da soggetti extra UE, e AI-BOOST descrive EUROPA come un consorzio «interamente sotto controllo UE». La composizione del capitale di Domyn non è nei documenti che abbiamo letto: la verifica dei requisiti spettava agli organizzatori della gara, e da fuori non la si può rifare.
Fraunhofer IAIS e Fraunhofer IIS sono due istituti della Fraunhofer-Gesellschaft, la rete tedesca di ricerca applicata. Nel comunicato del 24 giugno scrivono di portare in EUROPA l’esperienza accumulata nel Lamarr-Institut e in progetti come OpenGPT-X, TrustLLM e OpenEuroLLM: pipeline di dati multilingui, metodi di addestramento, post-training e sistemi di valutazione. Lo IIS aggiunge il trasferimento verso le applicazioni industriali. Curiosamente, né il comunicato della Commissione né quello di Domyn nominano i due partner tedeschi: li nominano AI-BOOST e Fraunhofer, mentre Reuters cita la Fraunhofer-Gesellschaft senza distinguere gli istituti.
Che cosa vuol dire «aperto», qui
«Aperto» è la parola più usata negli annunci ed è anche la più scivolosa, perché un modello si può aprire a tre livelli diversi.
I pesi. È il livello minimo: chiunque può scaricare il modello, farlo girare sui propri server, modificarlo. Secondo AI-BOOST EUROPA uscirà con licenza Apache 2.0, che permette anche l’uso commerciale e la redistribuzione. È un impegno più forte di quello che il bando chiedeva (pesi aperti «dove applicabile», premiati con un punto) e diverso da quello che Domyn applica ai propri modelli: Domyn Small ha pesi pubblici, mentre Domyn Large è concesso ai clienti con una «Open Enterprise License» che dà a ciascuno la proprietà della propria versione personalizzata, pesi compresi. Aperto al cliente, non al pubblico: sull’account Hugging Face di Domyn, al 24 settembre, c’è soltanto Domyn Small.
I dati. AI-BOOST scrive che EUROPA sarà costruito «esclusivamente su dati aperti». Secondo Reuters, però, Domyn intende raccogliere dati da partner istituzionali, e il 25 giugno Sharka si aspettava i primi accordi con i governi «entro settimane». Le due cose possono stare insieme, se i dati delle amministrazioni sono pubblicati; ma se il corpus di addestramento verrà reso disponibile, e in che forma, nessuna fonte lo dice.
La ricetta. Secondo Reuters, Sharka ha detto che il modello sarà «completamente open source e riproducibile». Riproducibile vuol dire che qualcuno fuori dal consorzio potrebbe rifarlo: servono i dati, il codice e la ricetta di addestramento, non solo il file dei pesi. Se la promessa verrà mantenuta per intero, sarà più di quanto offra oggi gran parte dei modelli detti aperti, che pubblicano i pesi ma non i dati. Per ora è una promessa: la riporta Reuters e la ripete AI-BOOST, che parla di una tecnologia che ogni istituzione europea potrà «riprodurre».
Le 24 lingue
L’Unione ha 24 lingue ufficiali, dal tedesco e dal francese al maltese e all’irlandese, e il progetto promette di coprirle tutte. Non è un dettaglio di marketing: il bando chiedeva esperienza su tutte le lingue dell’Unione come requisito d’ingresso e premiava le capacità multilingui in graduatoria, e AI-BOOST scrive che EUROPA sarà il primo modello di frontiera a catturare «in profondità» la conoscenza giuridica, amministrativa e culturale europea.
La difficoltà sta tutta nei dati. Per le lingue con pochi parlanti esistono molti meno testi, e un modello impara meno ciò che vede poco. Come il consorzio intenda bilanciare le lingue, quanto testo avrà per ciascuna e come misurerà le prestazioni lingua per lingua, i documenti pubblici non lo dicono. È su questo, più che sul numero di parametri, che un modello europeo potrebbe distinguersi da quelli che già esistono. Gli accordi sui dati con i governi di cui ha parlato Sharka potrebbero servire proprio qui, visto che molti testi pubblici, a cominciare dalla legislazione dell’Unione, esistono per obbligo in più lingue. Ma è un’ipotesi, e nessuna fonte la conferma.
I numeri che non coincidono
Chi legge i comunicati uno accanto all’altro trova almeno quattro punti in cui non combaciano, o tacciono.
- Quanti parametri. La Commissione, Domyn e Fraunhofer citano la soglia del bando, più di 400 miliardi; Reuters scrive che il modello ne avrà «oltre 400 miliardi». AI-BOOST scrive «500 miliardi». Con un’architettura a esperti, poi, il totale dice poco sul costo di ogni risposta, che dipende dai parametri attivi a ogni passo: quanti saranno, nessuno l’ha detto.
- Quanto calcolo. Il 2,5 per cento è una quota, non una quantità: non si sa in quante ore di GPU si traduca, né su quali macchine. Il bando prevedeva inoltre calcolo aggiuntivo già assicurato. Domyn dichiara di avere in costruzione un proprio supercomputer, ma che venga usato per EUROPA non è scritto da nessuna parte.
- Quanto costa, e chi paga. Il premio non comprende denaro. Ciò che la quota EuroHPC non copre, dal personale ai dati, resta a carico del consorzio, che non ha reso pubblico un budget.
- Quando si comincia. Le linee guida dicono che l’accesso viene concesso «poco dopo» la selezione. Al 24 settembre non risulta un annuncio pubblico sull’avvio dell’addestramento: la pagina delle notizie di Domyn, dopo il 19 giugno, riporta una partnership con Cognizant e l’inserimento di Sharka nella lista TIME100 AI, e nient’altro su EUROPA.
I tempi
Il calendario ufficiale si ferma alla scelta del vincitore. Il resto viene da due frasi: le linee guida, che assegnano il calcolo «per un anno», prorogabile, e l’amministratore delegato di Domyn, che secondo Reuters ha promesso un modello addestrato da zero e rilasciato «entro un anno». Contando dal 25 giugno, vuol dire entro l’inizio dell’estate 2027. Reuters, nello stesso articolo, aggiungeva una cautela che vale la pena ripetere: un modello da 400 miliardi di parametri sarebbe fra i più grandi mai pubblicati con licenza aperta, ma la dimensione da sola non dice se raggiungerà le capacità dei sistemi di punta.
La gara, in fondo, è un esperimento su un’idea precisa: che per costruire un modello di frontiera in Europa il pezzo mancante non siano i soldi ma le macchine, e che le macchine pubbliche ci siano già. Sharka l’ha detto in modo esplicito, secondo Reuters, chiamando la rete EuroHPC una risorsa strategica sottovalutata. Se ha ragione, EUROPA lo dimostrerà con un modello che chiunque potrà scaricare, provare in lettone o in portoghese, e confrontare con gli altri. Se non ha ragione, lo si vedrà dagli stessi numeri. Fra un anno si guarderà il cronometro, non la corsia.
I commenti sono riservati agli iscritti.
Accedi per commentare