
Nel 1991 uno studente di Monaco di Baviera, Sepp Hochreiter, consegna una tesi di laurea che diagnostica con precisione chirurgica il motivo per cui le reti neurali dell’epoca non riuscivano a imparare dipendenze a lungo termine: il segnale di errore, propagandosi all’indietro attraverso gli strati, si affievolisce fino a scomparire. Ci vorranno più di vent’anni perché la comunità trovi rimedi abbastanza robusti da rendere addestrabili reti con decine o centinaia di strati. Nel frattempo, il problema ha un nome che oggi ogni corso di deep learning insegna nella prima settimana: vanishing gradient.
Perché serve una non linearità, e come si passa da sigmoide e tanh alla ReLU — gradienti che svaniscono compresi — è nel libro.
Capire questo fenomeno non è archeologia. È il motivo per cui esistono la ReLU, la batch normalization, le connessioni residue di ResNet e le celle LSTM. Quasi ogni scelta architetturale delle reti moderne è, in fondo, una risposta a questa domanda: come faccio ad arrivare in fondo alla rete senza perdere il segnale per strada?
Il telefono senza fili della retropropagazione
Una rete neurale impara con la retropropagazione: si calcola l’errore in uscita e lo si fa risalire strato per strato, per capire quanto ogni peso ha contribuito allo sbaglio. Matematicamente, questo significa applicare la regola della catena del calcolo differenziale: il gradiente rispetto a un peso del primo strato è il prodotto di tanti fattori, uno per ogni strato attraversato.
È il gioco del telefono senza fili. Il messaggio parte dall’ultimo strato («hai sbagliato di tanto, in questa direzione») e viene sussurrato di strato in strato verso l’inizio della rete. Ogni passaggio distorce un po’ il messaggio: lo amplifica o lo attenua di un fattore che dipende dai pesi e dalla derivata della funzione di attivazione. Se la rete ha 5 strati, il messaggio sopravvive. Se ne ha 50, quello che arriva al primo strato può essere un sussurro impercettibile — o un urlo assordante.
La chiave è che i fattori si moltiplicano, non si sommano. E i prodotti di tanti numeri hanno un comportamento estremo: se i fattori sono in media minori di 1, il prodotto crolla verso zero esponenzialmente; se sono maggiori di 1, diverge verso l’infinito. Non esiste quasi via di mezzo stabile.
Quando il segnale si spegne
Prendiamo la sigmoide, la funzione di attivazione preferita degli anni Novanta. La sua derivata vale al massimo 0,25, e nelle zone di saturazione (input molto grandi o molto piccoli) è praticamente zero. Ogni strato attraversato all’indietro moltiplica il gradiente per un numero che non supera mai 0,25: dopo 10 strati, nel caso migliore, il segnale è ridotto a meno di un milionesimo del valore iniziale.
La conseguenza pratica è subdola: la rete sembra addestrarsi. La loss scende un po’, gli ultimi strati imparano. Ma i primi strati — quelli che dovrebbero imparare le rappresentazioni di base, le fondamenta su cui tutto il resto poggia — ricevono aggiornamenti così minuscoli da restare di fatto congelati ai valori casuali dell’inizializzazione. È come ristrutturare un palazzo lavorando solo all’attico e lasciando le fondamenta come le ha buttate giù il cantiere.
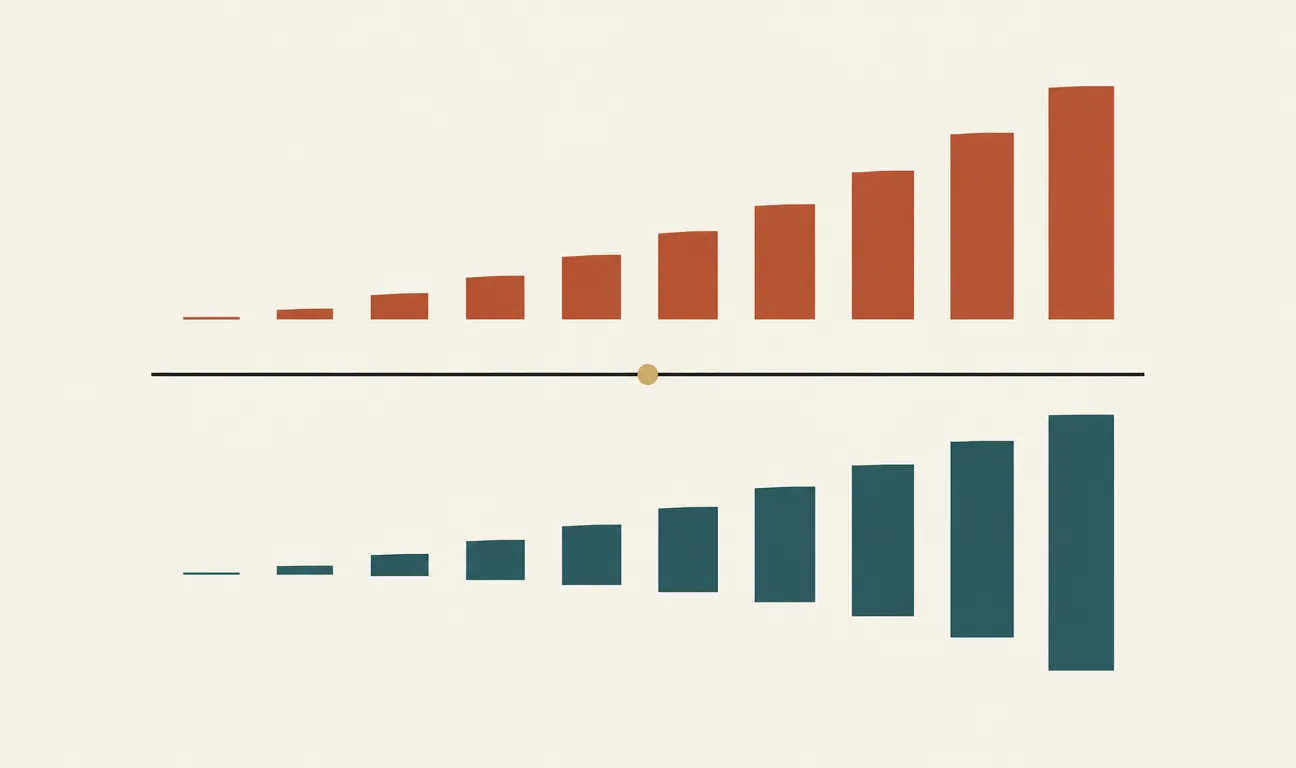
Il segnale di errore (barre terracotta) parte pieno dall’ultimo strato e si riduce a ogni passaggio all’indietro: ai primi strati arriva quasi nulla.
Il gemello cattivo: l’esplosione
Il fenomeno opposto è meno raccontato ma altrettanto distruttivo. Se i fattori moltiplicati sono in media maggiori di 1 — pesi inizializzati troppo grandi, o certe configurazioni delle reti ricorrenti — il gradiente cresce esponenzialmente strato dopo strato. È l’interesse composto applicato all’errore: un 10% in più a ogni passaggio, dopo 50 passaggi, è un fattore 117.
I sintomi dell’exploding gradient sono più teatrali di quelli del vanishing: la loss schizza verso l’alto, i pesi assumono valori enormi e nel giro di poche iterazioni compare il temuto NaN. Il problema è particolarmente severo nelle reti ricorrenti, dove la stessa matrice di pesi viene attraversata a ogni passo temporale: elaborare una frase di 100 parole equivale, ai fini del gradiente, ad attraversare 100 strati con gli stessi identici pesi.
Quasi ogni scelta architetturale del deep learning moderno è una risposta alla stessa domanda: come arrivo in fondo alla rete senza perdere il segnale per strada?
Le contromisure che hanno reso possibile il deep learning
La storia del deep learning tra il 2010 e il 2016 si può leggere come una collezione di rimedi a questo problema. I principali:
- ReLU al posto della sigmoide. La funzione
max(0, x)ha derivata esattamente 1 per gli input positivi: il segnale che passa non viene attenuato. Non risolve tutto (i neuroni possono «morire» nella zona negativa), ma elimina la saturazione sistematica della sigmoide. - Inizializzazione calibrata. Gli schemi di Xavier/Glorot e di He scelgono la scala dei pesi iniziali in modo che la varianza del segnale resti circa costante strato dopo strato, sia in avanti sia all’indietro. Partire col piede giusto conta moltissimo.
- Batch normalization. Rinormalizzare le attivazioni dentro la rete impedisce che i valori scivolino nelle zone di saturazione e mantiene i gradienti in un intervallo sano.
- Connessioni residue. L’idea di ResNet: ogni blocco calcola una correzione da sommare all’input, invece di trasformarlo da capo. La somma crea un’autostrada per il gradiente, che può tornare indietro saltando i blocchi senza essere moltiplicato per le loro derivate. È il motivo per cui oggi si addestrano reti da centinaia di strati.
- Gradient clipping. Contro l’esplosione, il rimedio più pragmatico: se la norma del gradiente supera una soglia, lo si riscala. Un limitatore di velocità, brutale ma efficace, tuttora standard nell’addestramento dei modelli linguistici.
- Architetture con gate. La LSTM — progettata proprio da Hochreiter e Schmidhuber — introduce una cella di memoria in cui l’informazione fluisce attraverso somme e gate moltiplicativi controllati, invece di attraversare una trasformazione completa a ogni passo. È la risposta storica al vanishing gradient nelle sequenze.
Vale la pena notare che anche il Transformer, l’architettura dietro i modelli linguistici attuali, è disseminato di queste contromisure: connessioni residue attorno a ogni blocco, normalizzazione dei layer, inizializzazioni attente. Il problema non è «risolto» una volta per tutte: è tenuto sotto controllo da un insieme di accorgimenti che ormai diamo per scontati.
Come riconoscerlo nei tuoi esperimenti
Se addestri reti, prima o poi incontrerai entrambi i fenomeni. Alcuni segnali d’allarme concreti: la loss che ristagna da subito mentre la rete è profonda (vanishing); la loss che diventa NaN dopo poche iterazioni (exploding); i primi strati i cui pesi, a fine addestramento, sono quasi identici all’inizializzazione. Lo strumento diagnostico più semplice è tracciare la norma del gradiente per strato: se decade esponenzialmente man mano che si va verso l’ingresso, hai la conferma visiva del problema — è esattamente il grafico dello schema qui sopra.
Perché ti riguarda
Se lavori con il deep learning, questo problema è la lente con cui leggere le architetture: quando incontri una connessione residua, una batch norm o un gradient clipping nel codice di qualcun altro, ora sai a quale malattia rispondono. Se invece l’AI la usi e basta, c’è comunque una lezione di metodo: i sistemi che moltiplicano tanti effetti in cascata — che siano gradienti, interessi finanziari o passaggi di comunicazione in un’azienda — non degradano linearmente ma esponenzialmente. Il deep learning ha imparato a costruire autostrade per il segnale. Non è un cattivo principio anche fuori dalle reti neurali.
I commenti sono riservati agli iscritti.
Accedi per commentare