
Chi ha fatto il verbalista in un’assemblea di condominio conosce il mestiere. Mentre la gente parla bisogna scrivere due cose insieme: che cosa viene detto e chi lo sta dicendo. «Rossi: la caldaia va cambiata. Bianchi: non quest’anno.» Un verbale corretto consegnato una settimana dopo va bene per l’archivio, ma non serve a chi deve rispondere adesso, in riunione, a Bianchi. E il verbalista bravo non aspetta la fine dell’intervento per decidere chi parla: lo capisce dalla voce, ma anche da quello che viene detto, e se Rossi torna a parlare dopo dieci minuti lo riconosce e lo chiama ancora Rossi.
È esattamente questo che chiede un assistente vocale seduto a una riunione con più persone, ed è il problema affrontato da VibeVoice-ASR-Streaming Technical Report, uscito su arXiv il 2 settembre 2026 (2609.02812, rivisto il 10 settembre). Lo firmano Yujie Tu, dell’Università dell’Accademia cinese delle scienze e in stage a Microsoft Research, e altri tredici autori fra Microsoft Research, la stessa università, la Shanghai Jiao Tong University e un ricercatore indipendente, con Furu Wei come contatto. È la versione in diretta di VibeVoice-ASR, il trascrittore che Microsoft aveva presentato a gennaio e che elabora fino a un’ora di registrazione in un passaggio solo, ma solo a registrazione finita.
Due mestieri, un modello solo
Il compito tecnico si chiama ASR con attribuzione del parlante: trascrivere e, insieme, dire chi parla. Tradizionalmente erano due sistemi in fila, un riconoscitore del parlato e un modulo di diarizzazione che raggruppa i frammenti di voce per somiglianza acustica. I modelli di nuova generazione basati su LLM, VibeVoice-ASR compreso, li hanno fusi in uno, ma leggono tutta la registrazione prima di scrivere una parola. Dall’altra parte, chi ha reso i riconoscitori basati su LLM capaci di lavorare in diretta lo ha fatto per un parlante solo; e i sistemi in diretta con più parlanti aggiungono quasi sempre un componente dedicato alle identità, una memoria di voci o una diarizzazione online in cascata al riconoscitore.
Il report insiste su un punto centrale. Per un normale riconoscitore, ricordare ciò che è già stato detto aiuta; per chi deve attribuire le battute, è indispensabile. Un parlante che compare nel pezzo di audio corrente può essere intervenuto la prima volta diversi minuti prima, e deve ricevere la stessa etichetta. Un sistema che dimentica la storia deve reintrodurla altrove, con una memoria di impronte vocali o un raggruppamento finale, e quindi rimette in piedi lo stadio separato che si voleva eliminare.
Che cosa fa un riconoscitore vocale, da dove viene il tasso di errore sulle parole e perché il parlato spontaneo è più difficile di un audiolibro: il riconoscimento del parlato ha un capitolo suo nel libro.
Audio e testo a strisce alterne
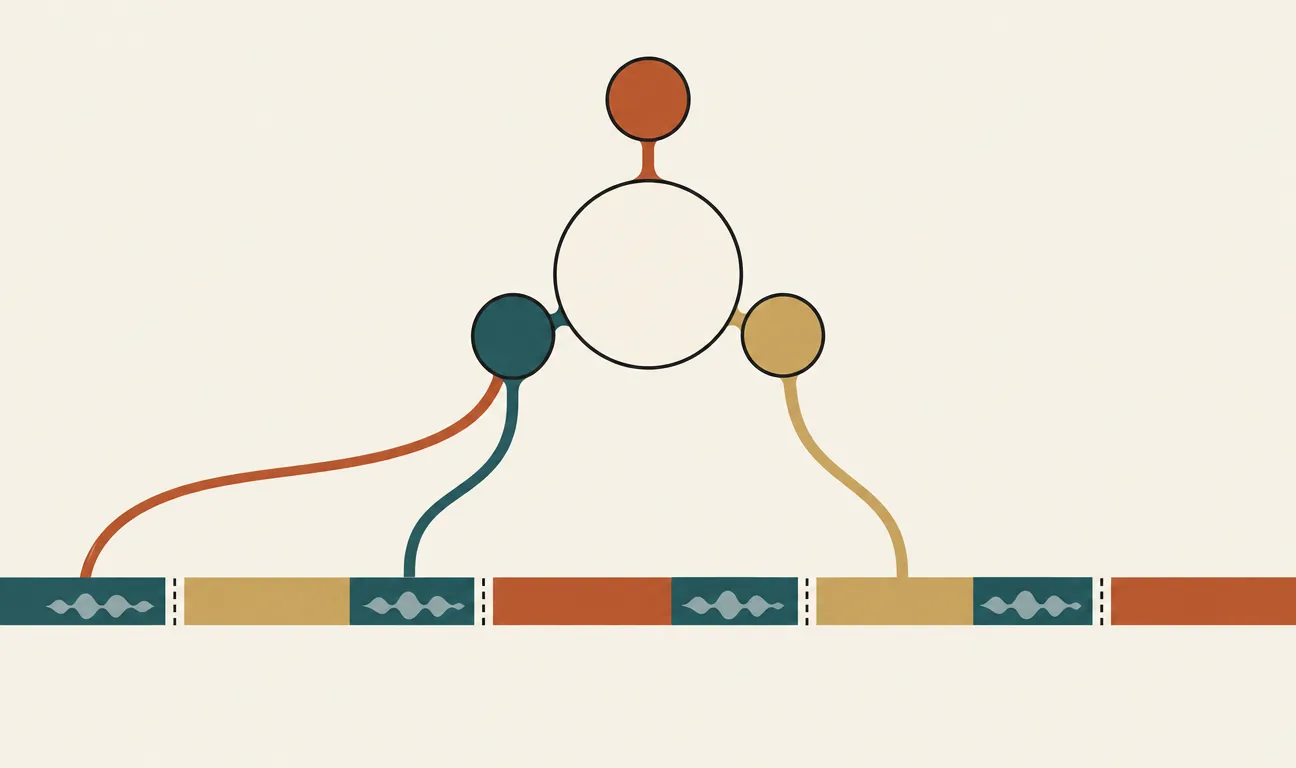
La soluzione è semplice da enunciare. L’audio arriva a pezzi di lunghezza fissa e il modello, un LLM della famiglia Qwen2.5 da 1,5 o 7 miliardi di parametri, vede un’unica sequenza in cui i pezzi di audio $X_k$ e i pezzi di trascrizione $Y_k$ si alternano:
$$[X_1, Y_1, X_2, Y_2, \dots]$$
Niente viene buttato: quando arriva il pezzo successivo, audio e testo precedenti restano nel contesto. Ogni pezzo di trascrizione viene generato parola per parola guardando tutto ciò che è venuto prima, più il pezzo corrente e un piccolo assaggio di futuro:
$$p(Y_k \mid X_{\lt k}, \tilde{X}_k, Y_{\lt k}) = \prod_{j=1}^{N_k} p\big(y_{k,j} \mid X_{\lt k}, \tilde{X}_k, Y_{\lt k}, y_{k,\lt j}\big)$$
dove $\tilde{X}_k$ è il pezzo corrente con il suo lookahead, mezzo secondo di audio successivo che permette di leggere a cavallo del confine prima di impegnarsi sul testo. Il modello decide da sé quanto scrivere: chiude ogni pezzo con un token speciale, addestrato anche sui pezzi senza parlato, dove il testo giusto è vuoto. Le battute arrivano già etichettate, «Speaker 0», «Speaker 1», con numeri assegnati in ordine di prima comparsa e riusati quando la stessa voce torna.
A monte ci sono i due tokenizzatori di VibeVoice, uno acustico e uno semantico, congelati: riducono di 3.200 volte la frequenza dell’audio a 24 kHz, cioè un fotogramma latente ogni 133,3 millisecondi, 7,5 al secondo. Tutto si misura in fotogrammi. I pezzi sono da 15 fotogrammi (2,0 secondi) o da 22 (2,9 secondi), il lookahead è di 4 (0,5 secondi). Il ritardo atteso fra una parola pronunciata e la sua comparsa con l’etichetta di chi l’ha detta è allora
$$\bar{\ell} = \frac{C}{2} + L \cdot 133{,}3\ \text{ms}$$
con $C$ la durata del pezzo: 2,00 secondi con i pezzi lunghi, 1,53 con quelli corti. In più, come la versione offline, il modello accetta un contesto iniziale di nomi propri, sigle e termini tecnici da tenere presenti per tutta la sessione.
L’addestramento procede in tre tappe, che cambiano il modo di costruire gli esempi e non il modello. Prima il modello impara il compito offline, con la registrazione intera sotto gli occhi. Poi, partendo da lì, viene riaddestrato nel formato a strisce su circa 420.000 ore di parlato inglese e cinese, perché la diretta diventi la sua condizione normale. Infine una rifinitura su circa 13.000 ore curate, prese da insiemi pubblici e da un corpus sintetico: 50.884 conversazioni da riunione generate con terminologia di settore, voci sovrapposte e riverbero di stanza, 4.519,6 ore in tutto. Tutte le trascrizioni vengono spezzate in pezzi grazie a un allineatore automatico, Qwen3-ForcedAligner-0.6B, che dice quando finisce ogni parola.
I numeri
Il confronto è con servizi commerciali in diretta, su quattro corpora di riunioni (i cinesi AISHELL-4 e AliMeeting, l’inglese AMI con microfono a cuffia e con un solo microfono distante) e su nove lingue di MLC-Challenge, italiano compreso. Il modello è quello da 7 miliardi con i pezzi lunghi.
Solo trascrizione. Con i servizi alimentati a pezzi da 2,9 secondi come VibeVoice, sulla media dei cinque insiemi l’errore di VibeVoice è il più basso, con Gemini 3.5 Transcribe Live subito dietro e gli altri servizi staccati. Il primato però è stretto: VibeVoice vince su AISHELL-4 e AliMeeting, pareggia di fatto su AMI a cuffia (19,83 contro 19,85), perde su AMI a microfono singolo (29,81 contro 27,18) e perde soprattutto sul multilingue, dove Gemini fa 13,73 contro 17,09. Sull’italiano Gemini sbaglia il 12,98% delle parole, VibeVoice il 17,00%.
| Sistema | Errore |
|---|---|
| VibeVoice-ASR-Streaming | 24,66 |
| Gemini 3.5 Transcribe Live | 25,23 |
| GPT Realtime Whisper | 39,31 |
| GPT Live Transcribe | 40,55 |
| ElevenLabs Scribe v2 Realtime | 41,39 |
Chi ha detto cosa. Qui il margine è più netto. Contro Azure ConversationTranscriber (di Microsoft stessa) e Google Cloud Speech-to-Text, misurati con cpWER, un tasso d’errore che conta anche le battute attribuite alla persona sbagliata, VibeVoice è primo o a pari merito in 12 impostazioni su 13; l’unica che perde è il portoghese. Sulle riunioni batte Azure di 2,39–12,45 punti, sulla media multilingue passa da 27,06 a 22,75; in italiano 21,20 contro 21,53. Sulla sola trascrizione, però, Azure resta spesso davanti: in media multilingue 15,43 contro 17,09. E soprattutto VibeVoice si impegna prima: un ritardo atteso di 2,00 secondi, contro 8,21 misurati per Azure e 9,12 per Google, le cui etichette continuano a cambiare per decine di secondi. Se si aspetta la versione definitiva di Google, in media 51,06 secondi dopo, il suo errore scende di 27–32 punti rispetto alla prima etichetta emessa: fra il 42,6% e il 67,9% delle parole cambiano etichetta almeno una volta.
Il prezzo della diretta. Rispetto al VibeVoice-ASR offline da cui parte, la versione in streaming perde da 0,75 a 3,53 punti di errore sulle parole e da 5,13 a 6,67 sul cpWER: la diretta costa più all’attribuzione che alla trascrizione. Stesso segnale dagli esperimenti di taratura: passare da 1,5 a 7 miliardi di parametri riduce il cpWER medio di 12,76 punti e l’errore sulle parole di 4,69; allungare i pezzi da 15 a 22 fotogrammi aiuta anch’esso di più l’attribuzione. Il lookahead migliora ogni metrica su tutti e cinque gli insiemi, e il guadagno sulle etichette non si è ancora appiattito a quattro fotogrammi.
Un risultato è controintuitivo. Scrivere l’etichetta del parlante dopo la battuta, anziché prima, non migliora nulla: 31,56 contro 31,55. Per un sistema a cascata aspettare è proprio il modo di sbagliare meno, perché l’identità si stima dalla sola voce e più voce si ascolta meglio è. Un modello che trascrive intanto usa anche il contenuto e il filo della conversazione, come fa il verbalista, e secondo gli autori gli bastano i due o tre secondi di un pezzo.
Costi. Su una A100 da 80 GB con vLLM e un flusso alla volta, il modello da 7 miliardi con i pezzi corti decodifica un pezzo in 146–208 millisecondi, contro i 2.000 di audio che il pezzo contiene: circa un decimo del tempo reale, 0,104 nel caso peggiore, a otto minuti di registrazione.
I limiti
Il confronto non è sempre alla pari. La latenza di VibeVoice è il ritardo algoritmico atteso, calcolato dalla formula senza il tempo di calcolo; quella dei servizi cloud è misurata al cronometro. Tutte le misure sono degli autori, che per Google si limitano all’inglese e gli danno il numero esatto di parlanti, ad Azure la lingua, mentre VibeVoice non riceve nessuna informazione in più. Va anche detto che uno dei sistemi battuti è un prodotto della stessa Microsoft.
Otto minuti. I checkpoint pubblicati coprono registrazioni fino a otto minuti, e tutte le valutazioni sono tagliate lì. La storia resta nel contesto senza compressione, quindi il costo cresce con la lunghezza. Molte riunioni durano di più: secondo gli autori il limite è di calcolo, non di architettura, ma oltre gli otto minuti non ci sono misure.
Voci sovrapposte e lingue. Il testo esce in fila unica, quindi quando due persone parlano insieme a lungo le prestazioni calano. Le lingue sono dieci, limitate da quelle che l’allineatore sa trattare. E i 2 secondi sono a regime: la prima risposta arriva dopo un pezzo intero più il lookahead, cioè 3,5 secondi (2,5 con i pezzi corti).
Il caso a voce sola non è il suo campo. Sul parlato di un solo parlante il modello non vince nessun test e la sua media pareggia quella del migliore, come dichiarano gli stessi autori.
Perché conta adesso
Gli assistenti vocali stanno uscendo dalla conversazione a due per entrare nelle riunioni, dove parlano in tanti e la domanda utile non è solo «che cosa è stato detto» ma «chi l’ha detto, e a chi devo rispondere». Finora la risposta in diretta passava da una catena di componenti, e le etichette arrivavano tardi e cambiavano. VibeVoice-ASR-Streaming mostra che un solo modello linguistico, lasciato ricordare tutto, può farlo in due secondi e con meno errori di attribuzione dei due servizi cloud misurati, almeno fino a otto minuti di registrazione. Microsoft rilascia i pesi da 1,5 e 7 miliardi, il codice di inferenza con vLLM e una demo: il resto, a partire da riunioni più lunghe di otto minuti e dall’italiano parlato nelle sale vere, lo potranno misurare gli altri.
I commenti sono riservati agli iscritti.
Accedi per commentare