
Per quasi un decennio, «visione artificiale» ha voluto dire una cosa sola: convoluzioni. Ogni sistema che riconosceva un volto, un tumore o un gatto passava le immagini attraverso strati convoluzionali, mattoni progettati apposta per le immagini. Nel 2020 un gruppo di Google Research provò a toglierli del tutto. Presero l’architettura che aveva conquistato l’elaborazione del linguaggio — il Transformer, nato per le frasi — e le diedero in pasto un’immagine, senza una sola convoluzione. Il risultato, con abbastanza dati, eguagliava e a volte superava le migliori reti convoluzionali. Il paper si intitola, con una battuta, An Image is Worth 16×16 Words: un’immagine vale sedici per sedici parole.
Il titolo è già la tesi. Se il Transformer tratta una frase come una sequenza di parole, perché non trattare un’immagine come una sequenza di pezzetti d’immagine? La domanda sembra ingenua. La risposta ha unificato due campi che fino ad allora parlavano lingue diverse.
Un’immagine come una frase
Il Transformer, introdotto nel 2017 per la traduzione, lavora su sequenze di «token» — tipicamente parole o pezzi di parola. Il suo meccanismo di attenzione mette in relazione ogni token con tutti gli altri: in una frase, capisce che «lui» si riferisce a un nome comparso dieci parole prima. Non ha nulla di specificamente linguistico dentro; è una macchina generica per trovare relazioni tra gli elementi di una sequenza.
Il problema, per usarlo sulle immagini, è che un’immagine non è una sequenza: è una griglia di pixel. E darla in pasto pixel per pixel è impraticabile. Un’immagine di 224 per 224 pixel sono oltre cinquantamila elementi, e l’attenzione, che confronta ogni elemento con ogni altro, ha un costo che cresce col quadrato della lunghezza della sequenza: cinquantamila token la farebbero esplodere.
Tagliare l’immagine a quadretti
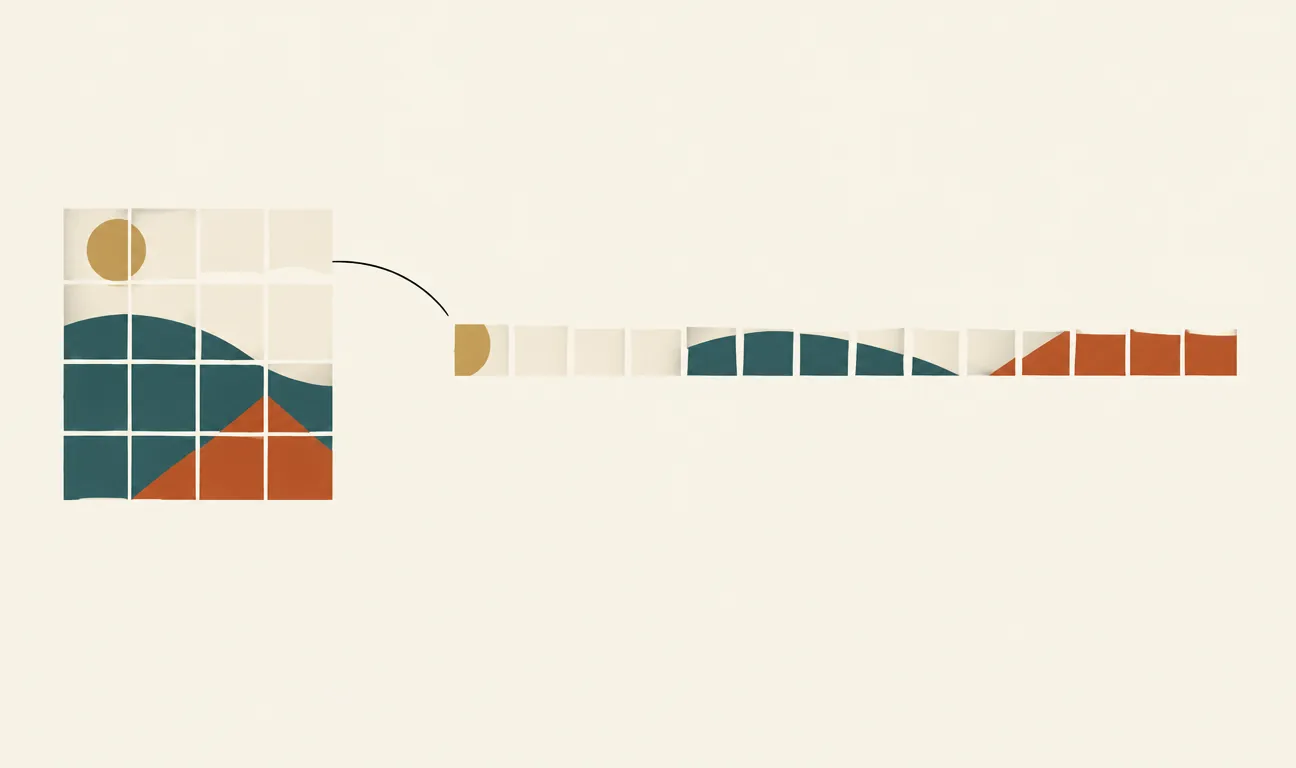
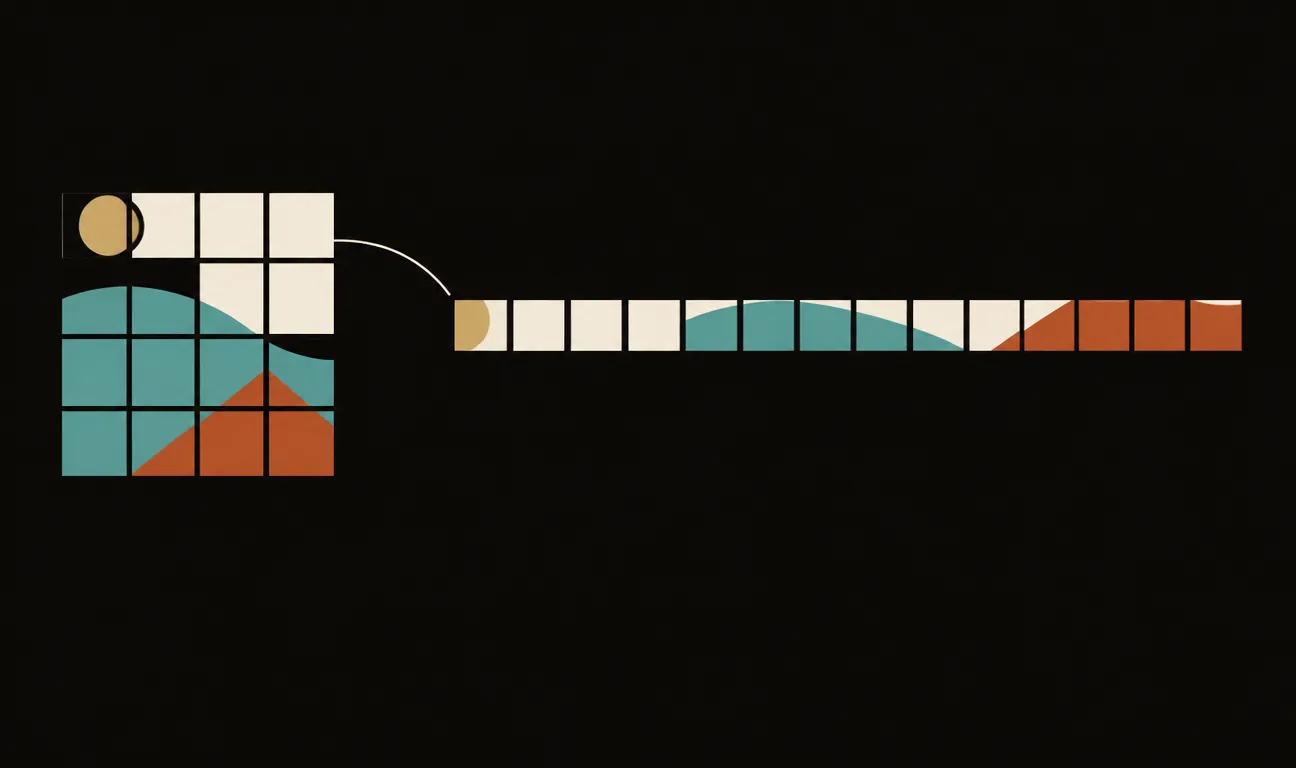
L’idea centrale di ViT — Vision Transformer — è disarmante. Invece di trattare ogni pixel come un token, taglia l’immagine in una griglia di quadretti, le patch, di dimensione fissa, tipicamente 16 per 16 pixel. Un’immagine 224 per 224 diventa così una griglia di 14 per 14 quadretti, cioè 196 patch. Ciascun quadretto viene «srotolato» nei suoi valori numerici e fatto passare attraverso una singola trasformazione lineare che lo comprime in un vettore. Ognuno di questi vettori è, a tutti gli effetti, un token: l’equivalente visivo di una parola. Da lì in poi ViT è un Transformer ordinario, identico a quello del testo.
È come leggere un mosaico. Non guardate le singole tessere una per una, né l’immagine tutta insieme in un colpo d’occhio: la scomponete in un numero gestibile di piastrelle, e l’attenzione salta dall’una all’altra per ricostruire la scena. Sedici per sedici pixel è la dimensione della tessera.
Restano due dettagli necessari. Primo, un Transformer non sa in che ordine arrivano i token: va aggiunta a ciascuna patch una «codifica di posizione» che dice dove stava nella griglia, altrimenti l’immagine diventa un sacchetto di tessere rimescolate. Secondo, gli autori aggiungono in testa alla sequenza un token speciale, il token di classe, che non corrisponde a nessuna patch: è un segnaposto la cui rappresentazione finale, dopo essere passata per tutti gli strati, viene usata per la decisione — è un gatto? un cane? È il taccuino su cui il modello scrive il riassunto di ciò che ha visto.
Il flusso di ViT: l’immagine è tagliata in patch, ogni patch diventa un token con la sua posizione, la sequenza (preceduta dal token CLS) entra in un Transformer identico a quello del testo, e la rappresentazione finale del token CLS produce la categoria.
Niente convoluzioni, niente pregiudizi
Qui sta il punto teorico interessante. Una rete convoluzionale ha, per costruzione, alcune convinzioni di partenza sulle immagini: che i pixel vicini siano più correlati di quelli lontani (località), e che un oggetto resti lo stesso oggetto ovunque compaia nell’inquadratura (invarianza alla traslazione). Questi «pregiudizi utili» — in gergo, bias induttivi — sono cablati nell’architettura, e sono il motivo per cui le reti convoluzionali imparano bene anche con dataset relativamente piccoli: partono già sapendo qualcosa di come sono fatte le immagini.
ViT rinuncia quasi del tutto a questi pregiudizi. Oltre al taglio in patch, non assume nulla sulla struttura spaziale: deve imparare da zero, dai dati, che i pixel vicini contano e che un gatto in alto a sinistra è come un gatto in basso a destra. È un modello più ingenuo, una tabula rasa rispetto alla rete convoluzionale che nasce già con delle opinioni.
La rete convoluzionale parte sapendo qualcosa sulle immagini. Il Vision Transformer parte da zero — e proprio per questo, con abbastanza esempi, può imparare cose che alla convoluzione erano precluse.
Il prezzo: servono montagne di dati
Questa ingenuità ha un costo preciso, ed è il risultato più onesto del paper. Addestrato solo su ImageNet — 1,3 milioni di immagini, un dataset che per gli standard della visione è «medio» — ViT resta indietro rispetto a reti convoluzionali di dimensioni paragonabili, di qualche punto percentuale. Senza i pregiudizi cablati, e con «pochi» dati, la convoluzione vince: sfrutta ciò che sa già.
Il quadro si rovescia quando si allarga il dataset di pre-addestramento. Gli autori provarono con ImageNet-21k (14 milioni di immagini) e con JFT-300M, un dataset interno di Google da circa 300 milioni di immagini. Man mano che i dati crescono, ViT rimonta e poi supera le reti convoluzionali. La frase con cui il paper riassume il fenomeno è quasi un motto: su larga scala, l’addestramento batte i pregiudizi induttivi. Con abbastanza esempi, il modello impara da sé le regolarità che la convoluzione aveva ricevuto in dono, e ne impara anche altre.
È la differenza tra due studenti. Uno arriva con un buon manuale di regole già scritte: parte avvantaggiato, ma quelle regole sono anche un limite. L’altro non ha manuale e all’inizio arranca, ma se gli dai una biblioteca sterminata finisce per capire la materia più a fondo di chi si è fermato al manuale.
I numeri, e perché contano
Il modello più grande, ViT-H/14 (dove «H» sta per huge e «14» è la dimensione delle patch, qui 14 per 14 pixel), pre-addestrato su JFT-300M, raggiunse l’88,55% di accuratezza sul test di ImageNet, avvicinandosi al meglio delle reti convoluzionali dell’epoca. Il dettaglio che colpì di più, però, non era l’accuratezza in sé: era il costo. ViT arrivava a quei risultati richiedendo all’incirca quattro volte meno risorse di calcolo per l’addestramento rispetto alle migliori reti convoluzionali comparabili. Non solo eguagliava le CNN: lo faceva spendendo meno.
C’è una ragione strutturale. Le operazioni del Transformer sono essenzialmente grandi moltiplicazioni tra matrici — esattamente ciò per cui le GPU e i TPU sono ottimizzati. Riusare l’architettura del testo significava anche riusare anni di ottimizzazioni hardware e software costruite intorno a essa, invece di inseguire un’architettura su misura.
Perché riguarda voi
La conseguenza più profonda di ViT non è un punto percentuale su un benchmark. È che, dal 2020 in poi, testo e immagini possono essere elaborati dalla stessa architettura. Prima c’erano due mondi separati, con strumenti, intuizioni e comunità di ricerca distinte. ViT ha mostrato che il Transformer è un motore abbastanza generale da digerire entrambi: basta impacchettare l’input in una sequenza di token.
È il presupposto tecnico dei modelli multimodali che usate oggi, quelli a cui potete mostrare una foto e fare una domanda a parole, ricevendo una risposta che tiene conto di tutte e due. Sotto il cofano, la foto è diventata una sequenza di patch e la domanda una sequenza di parole, e lo stesso meccanismo di attenzione le mette in relazione. Quando un assistente vi descrive un’immagine o vi legge un grafico che gli avete incollato, sta facendo, in fondo, quello che ViT ha reso possibile: trattare i pixel come si trattano le parole.
E c’è una morale più generale, la stessa di molte svolte in questo campo. ViT non ha inventato quasi nulla di nuovo: il Transformer c’era già dal 2017, l’idea di tagliare a quadretti è elementare. Ha soprattutto tolto qualcosa — i pregiudizi che credevamo indispensabili — e li ha rimpiazzati con dati. A volte il progresso non è aggiungere una struttura più intelligente, ma averne abbastanza di meno e lasciare che siano gli esempi a riempire il vuoto.
Il paper
Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov e altri (12 autori, Google Research, Brain Team), An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale, 2020. Presentato a ICLR 2021, disponibile su arXiv: arxiv.org/abs/2010.11929.
I commenti sono riservati agli iscritti.
Accedi per commentare