Un medico di pronto soccorso non risolve equazioni per decidere se un dolore al petto è urgente. Fa domande in sequenza: il dolore si irradia al braccio? C’è affanno? Il paziente ha più di sessant’anni? Ogni risposta restringe le possibilità, finché non resta una decisione. Un albero di decisione fa esattamente questo: trasforma una classificazione in una catena di domande sì/no e — cosa rara nel machine learning — ti mostra la catena per intero.
L’albero decisionale, perché da solo è ballerino, e come Random Forest e boosting lo correggono: nel libro.
È questa trasparenza a renderlo speciale. Una rete neurale ti dà una risposta; un albero ti dà una risposta e il ragionamento. Nei settori dove la spiegabilità è un requisito normativo e non un vezzo — credito, sanità, assicurazioni — l’albero e i suoi derivati restano strumenti di lavoro quotidiano.
L’anatomia di un albero
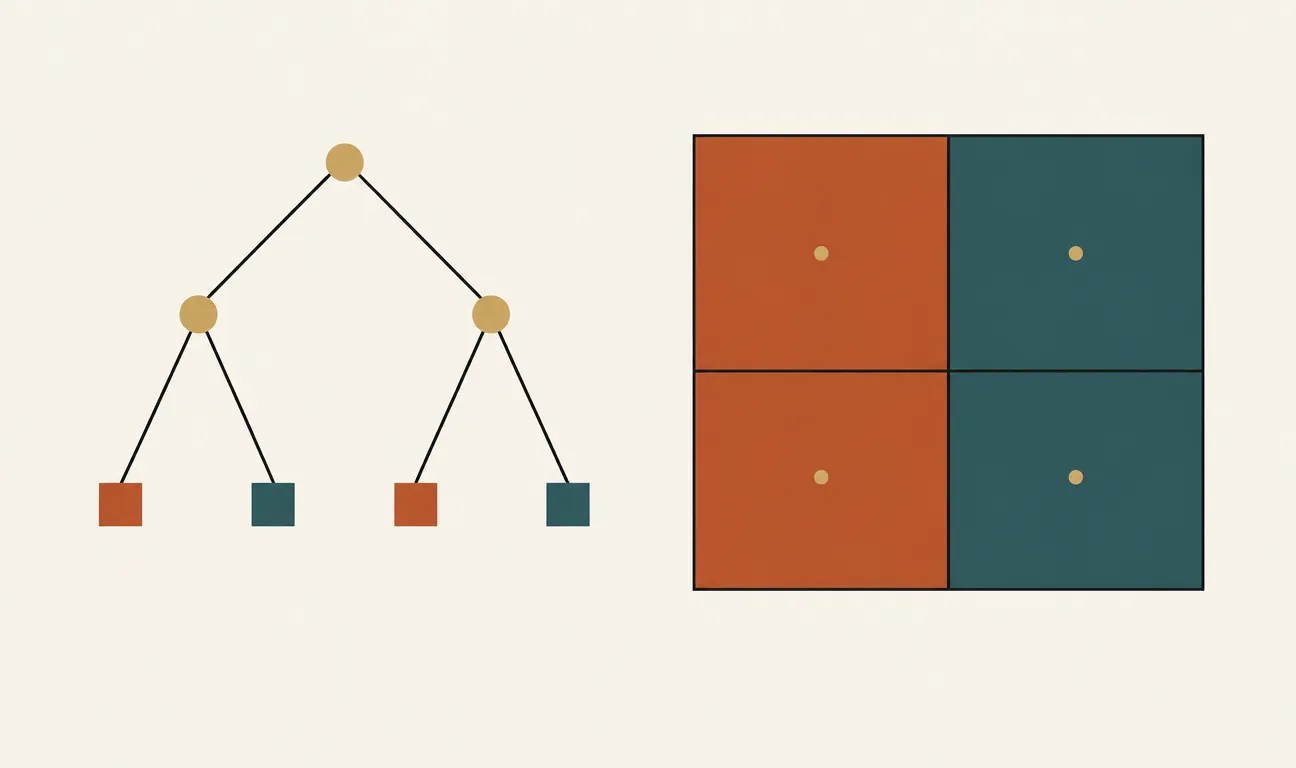
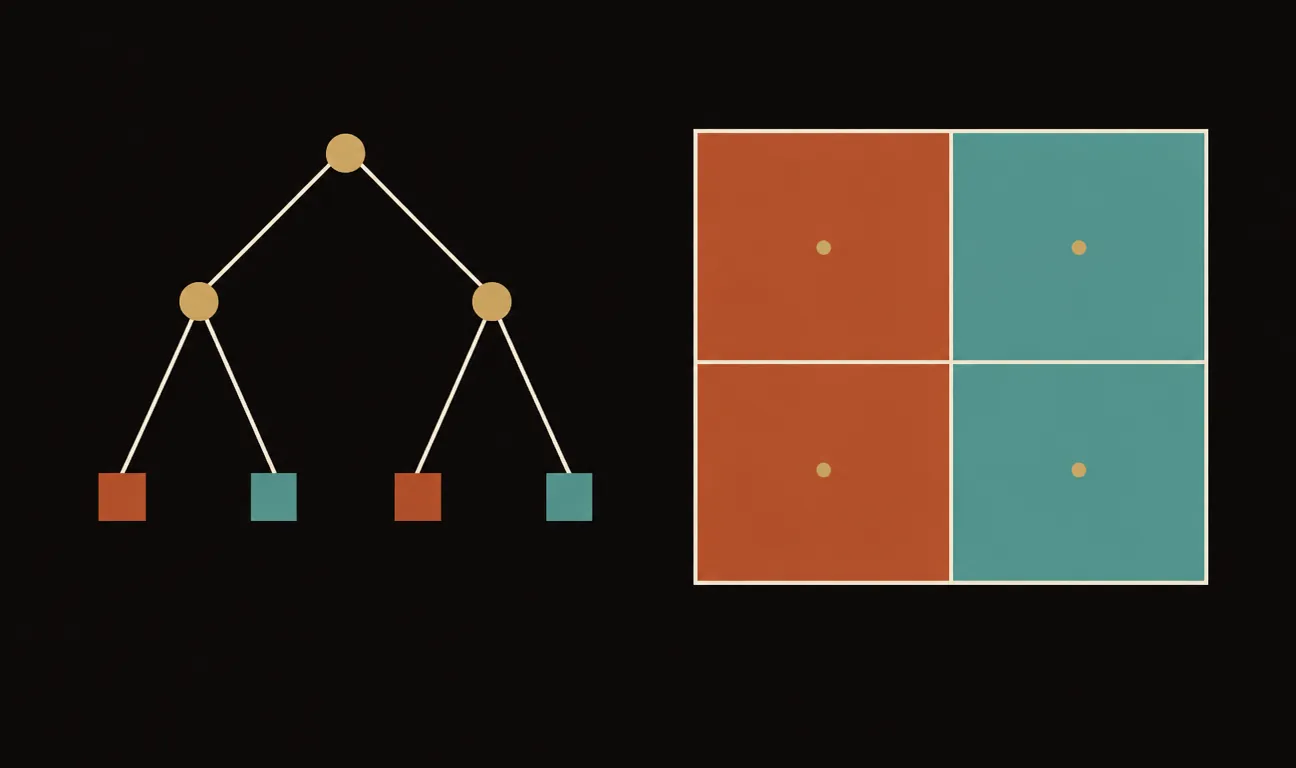
Un albero di decisione è fatto di nodi. Quello in cima, la radice, contiene tutti i dati di addestramento. Ogni nodo interno pone una domanda su una singola feature — «il reddito supera i 30.000 euro?» — e divide i dati in due rami. Le foglie, in fondo, non pongono più domande: contengono la predizione finale.
Addestrare l’albero significa scegliere, nodo per nodo, la domanda che separa meglio le classi. «Meglio» ha una definizione precisa: dopo lo split, i due gruppi devono essere il più possibile puri, cioè composti da esempi della stessa classe. Le due misure classiche di impurità sono l’indice di Gini e l’entropia; in pratica producono alberi quasi identici, e Gini è il default di scikit-learn perché costa meno da calcolare.
La struttura di un albero di decisione: ogni nodo pone una domanda su una feature, ogni foglia è una predizione. Il percorso dalla radice alla foglia è la spiegazione della decisione.
Costruiamone uno in Python
Usiamo il dataset dei vini incluso in scikit-learn: 178 vini, 13 misure chimiche, 3 cantine di origine da indovinare. Bastano poche righe.
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

albero = DecisionTreeClassifier(max_depth=3, random_state=42)
albero.fit(X_train, y_train)

print(f"Accuracy sul test: {accuracy_score(y_test, albero.predict(X_test)):.3f}")
Con profondità 3 — al massimo tre domande per arrivare a una foglia — l’albero supera il 90% di accuratezza. Non male per un modello che si legge come un diagramma di flusso.
Guardare dentro il modello
Qui gli alberi mostrano il loro vantaggio competitivo: possiamo stampare l’intera logica del modello in formato testuale, come una ricetta.
from sklearn.tree import export_text
from sklearn.datasets import load_wine

nomi = load_wine().feature_names
print(export_text(albero, feature_names=nomi))
L’output è una gerarchia di regole del tipo «se color_intensity > 3.82 e flavanoids <= 1.58 e alcalinity_of_ash > 17.65 allora classe 2». Ogni predizione ha un percorso ricostruibile. Possiamo anche chiedere quali feature contano di più:
import numpy as np

importanze = albero.feature_importances_
for i in np.argsort(importanze)[::-1][:5]:
    print(f"{nomi[i]:30s} {importanze[i]:.3f}")
Scopriremo che poche misure chimiche fanno quasi tutto il lavoro. È un’informazione preziosa anche fuori dal modello: dice al laboratorio quali analisi vale la pena pagare.
Il tallone d’Achille: l’overfitting
Lasciato libero, un albero cresce finché ogni foglia contiene esempi di una sola classe, anche uno soltanto. A quel punto l’accuratezza sui dati di addestramento è del 100% — e quella sui dati nuovi crolla. L’albero non ha imparato regole generali: ha memorizzato il dataset, come uno studente che ripete a memoria gli esercizi svolti ma non sa risolverne uno nuovo.
Un albero senza limiti di profondità non impara: memorizza. E un modello che memorizza è inutile esattamente là dove serve, cioè sui dati che non ha mai visto.
Verifichiamolo, confrontando un albero libero con due alberi potati:
for depth in [None, 3, 5]:
    a = DecisionTreeClassifier(max_depth=depth, random_state=42)
    a.fit(X_train, y_train)
    tr = accuracy_score(y_train, a.predict(X_train))
    te = accuracy_score(y_test, a.predict(X_test))
    print(f"max_depth={str(depth):5s}  train={tr:.3f}  test={te:.3f}")
Con max_depth=None il train arriva a 1.000 e il test resta indietro: quel divario tra le due colonne è la firma dell’overfitting. I parametri per contenerlo si chiamano, non a caso, potatura: max_depth limita le domande in sequenza, min_samples_leaf impone che ogni foglia contenga abbastanza esempi da essere statisticamente credibile, ccp_alpha pota a posteriori i rami che non si guadagnano il posto.
Quando usarlo, quando no
L’albero singolo ha limiti onesti. È instabile: cambiando pochi esempi di training, lo split alla radice può cambiare e con lui l’intero albero — come una diagnosi che prende tutt’altra strada se la prima domanda del medico è diversa. Produce confini di decisione a scalini, rigidamente paralleli agli assi delle feature. E in accuratezza pura viene quasi sempre battuto dagli ensemble.
- Usalo quando la spiegabilità è un requisito, quando serve un prototipo rapido su dati tabellari, o quando vuoi capire quali feature contano prima di costruire modelli più complessi.
- Evitalo quando conta solo la performance predittiva: in quel caso il passo successivo naturale è un ensemble di alberi — random forest o gradient boosting — che sacrifica la leggibilità del singolo albero per guadagnare parecchi punti di accuratezza.
Perché ti riguarda
Se lavori con dati tabellari — e la maggior parte dei dati aziendali italiani lo è: anagrafiche, transazioni, letture di sensori — gli alberi e i loro ensemble restano oggi una delle scelte più solide, spesso più delle reti neurali. E se un giorno dovrai spiegare a un cliente, a un revisore o a un giudice perché il tuo modello ha rifiutato un prestito, l’albero di decisione è uno dei pochi modelli che ti permette di rispondere mostrando, letteralmente, il percorso della decisione. Nel prossimo articolo vedremo cosa succede quando, invece di un albero solo, ne facciamo votare cento.
I commenti sono riservati agli iscritti.
Accedi per commentare